Gemini 4 Argon: Google'ın yeni sınır zekâ çağı
Google DeepMind'ın Gemini 4 Argon modeli güvenilir siber savunmacılara açılıyor. Google'ın kendi tablosunda 19 benchmark'ın 14'ünde önde, beşinde geride.
Bu yazıda
Google Gemini 4 Argon’u tanıttı, ama çoğu kişi henüz kullanamıyor. Google DeepMind’ın SVP’si ve Baş Yapay Zekâ Mimarı Koray Kavukcuoglu’nun yazdığı 30 Eylül duyurusunda şirket, Argon’un “Fairwind Programı aracılığıyla bir grup güvenilir siber savunmacıya” sunulduğunu söylüyor. Geliştiriciler, kurumlar ve tüketiciler “mümkün olan en kısa sürede” gelecek, önce ücretli API müşterileri ve Google AI Ultra aboneleri. Bu yazı Google’ın modelle ilgili söylediklerini özetliyor. Performans rakamları Google’ın kendi rakamları.
Şu an ne erişilebilir, ne zaman
Bugün yalnızca güvenilir savunmacı grubunun erişimi var. Google, erişimi kademeli genişletirken ABD hükümetinin gönüllü ön sürüm erişim sürecine katıldığını ve korumaları yinelerken erken test edenlerden geri bildirim toplamaya devam edeceğini söylüyor. Yazı genel erişim için bir tarih vermiyor.
Planlanan fiyat, milyon input token başına 2 dolar, milyon output token başına 10 dolar tanıtım fiyatı; önbellekteki input token’lar input fiyatından %95 indirimli. Bir dipnota göre tanıtım süresi bittikten sonra fiyat 4 ve 20 dolar oluyor. Bunlar henüz yapılmamış bir lansmanın fiyatları. Argon’un output sınırı 64K’dan 1M token’a çıkıyor; yazı bir input context window belirtmiyor.
Benchmark’lar: Argon nerede önde, nerede değil
Google’ın yazısı Argon’u tek bir tabloda GPT-6 Astra, Claude Fable 5.1 ve Claude Opus 5.5 ile yan yana koyuyor. Tablonun tamamını okumak, “en iyi sonuç” başlıklarından daha öğretici.
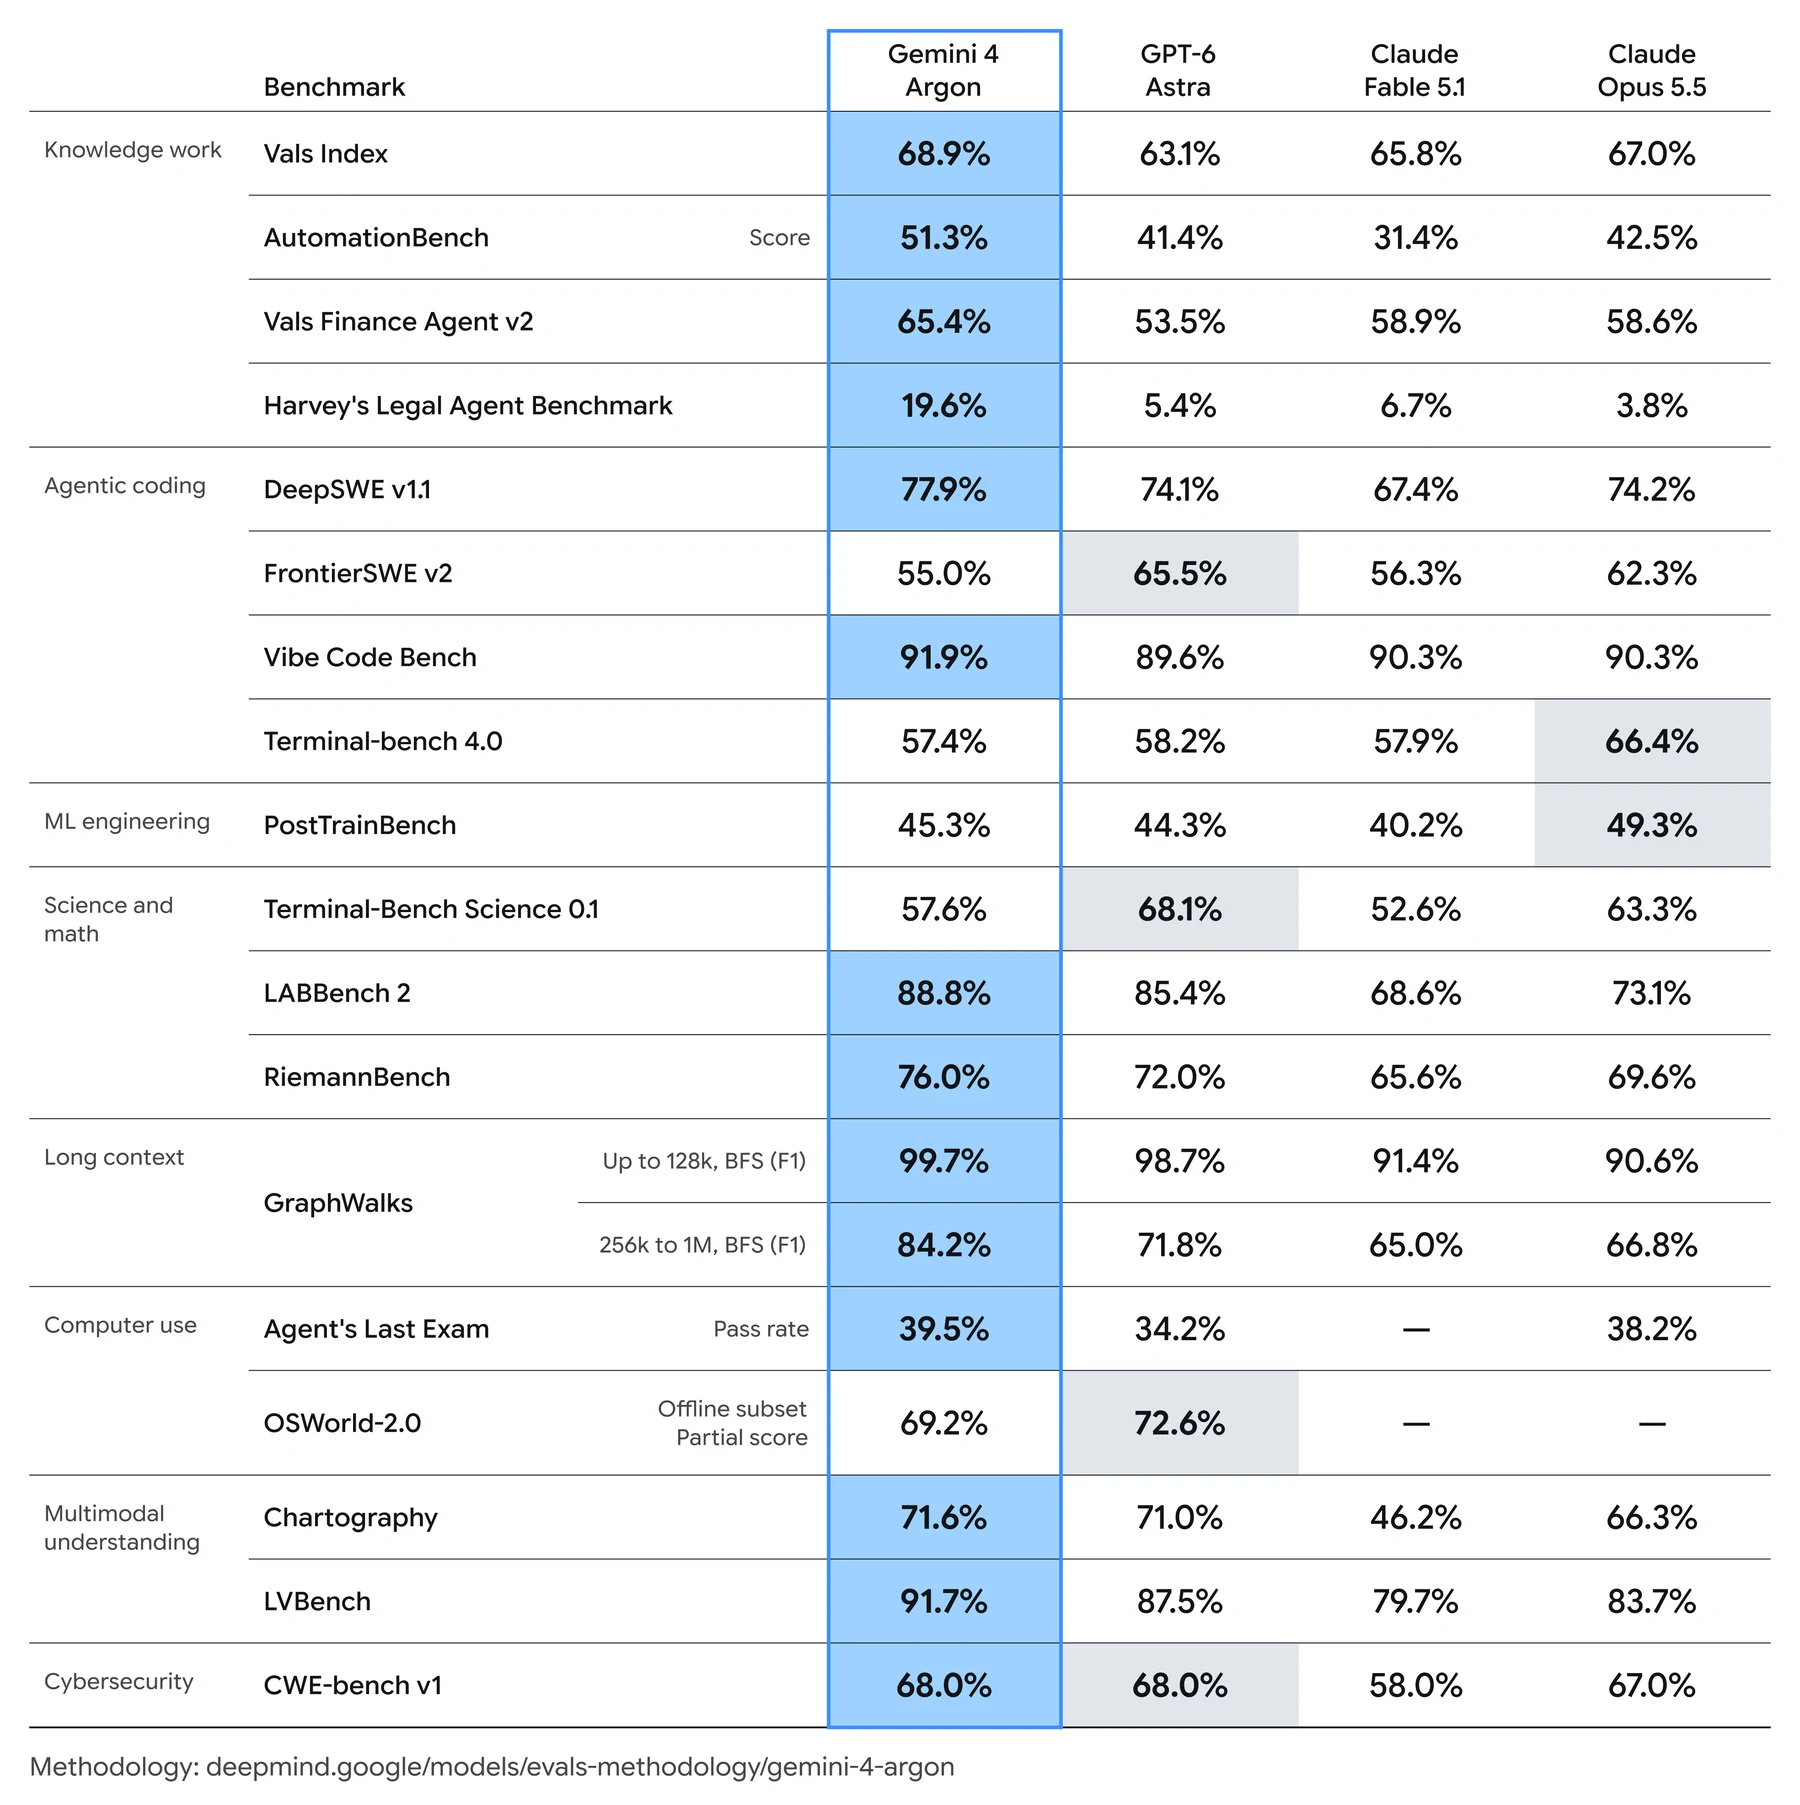
Argon 19 satırın 14’ünde önde ya da berabere, beşinde geride:
| Benchmark | Gemini 4 Argon | Tablodaki en iyi diğer model |
|---|---|---|
| DeepSWE v1.1 (uzun soluklu yazılım işi) | %77,9 | %74,2 (Opus 5.5) |
| AutomationBench (Zapier) | %51,3 | %42,5 (Opus 5.5) |
| Vals Index | %68,9 | %67,0 (Opus 5.5) |
| LVBench (uzun video) | %91,7 | %87,5 (GPT-6 Astra) |
| GraphWalks, 256k ile 1M token arası | %84,2 | %71,8 (GPT-6 Astra) |
| FrontierSWE v2 | %55,0 | %65,5 (GPT-6 Astra) |
| Terminal-bench 4.0 | %57,4 | %66,4 (Opus 5.5) |
| Terminal-Bench Science 0.1 | %57,6 | %68,1 (GPT-6 Astra) |
| PostTrainBench | %45,3 | %49,3 (Opus 5.5) |
| OSWorld-2.0 (çevrimdışı alt küme, kısmi puan) | %69,2 | %72,6 (GPT-6 Astra) |
En geniş farklar bilgi işinde ve uzun bağlamda. Harvey’nin hukuk benchmark’ında Argon %19,6 alırken diğerlerinin en iyisi %6,7; bu aynı zamanda mutlak puanların ne kadar düşük olduğunu da gösteriyor. Kodlama ikiye bölünmüş: Argon DeepSWE ve Vibe Code Bench’te önde, FrontierSWE v2 ve Terminal-bench 4.0’da geride. Ana tablo Grok ya da DeepSeek gibi diğer laboratuvarların modellerini dışarıda bırakıyor; aşağıdaki CWE-bench ve prompt injection grafiklerinde ise var. Yazının bağladığı metodoloji sayfasını okumadık.
Google’ın ileri sürdüğü diğer şeyler
Google içindeki işler. Google, binlerce çalışanının Argon’u şimdiden kullandığını söylüyor ve hepsi kendi bildirimi olan üç örnek veriyor:
- Bir kuantum hesaplama görevinde yayımlanmış bir referans değeri dakikalar içinde %40 geçmiş.
- Bir Argon ajan ekibi filo genelindeki profil verilerini analiz edip, Google’a göre devreye alındığında 300 TiB’tan fazla belleği boşaltacak, toplamda tahmini 500 TiB ile 1 PiB arasında tasarruf sağlayacak bellek optimizasyonları uygulamış.
- Ajanlar C/C++ kodunu Rust’a taşıyor; re2 ve libgav1 gibi çekirdek kütüphanelerden Fuchsia Zircon çekirdeğinde 800 bin satırın üzerine kadar. Video çözücü libgav1 için Google, ajanların mevcut bir Rust portundaki 32 bin satırlık SIMD kodunu değiştirdiğini ve aynı video çıktısıyla o porttan 2,7 kat hızlı, bellek güvenli bir çözücü ürettiğini söylüyor. Google, bu yeniden yazımların üretime girmeden önce denetlendiğini ve test edildiğini ekliyor.
Siber savunma. Google, Argon’u “kritik yazılım açıklarını otonom olarak bulacak, doğrulayacak ve yamalayacak” şekilde eğittiğini söylüyor. Selefi Gemini 3.8 Flash Cyber’a karşı 20 dilde gerçek dünya açık keşfinde %85,8’e karşı %71,0, Wiz’in sızma testi benchmark’ında %70,9’a karşı %58,2 bildiriyor. İkisi de pass@1 ve Google’ın grafiğinden.
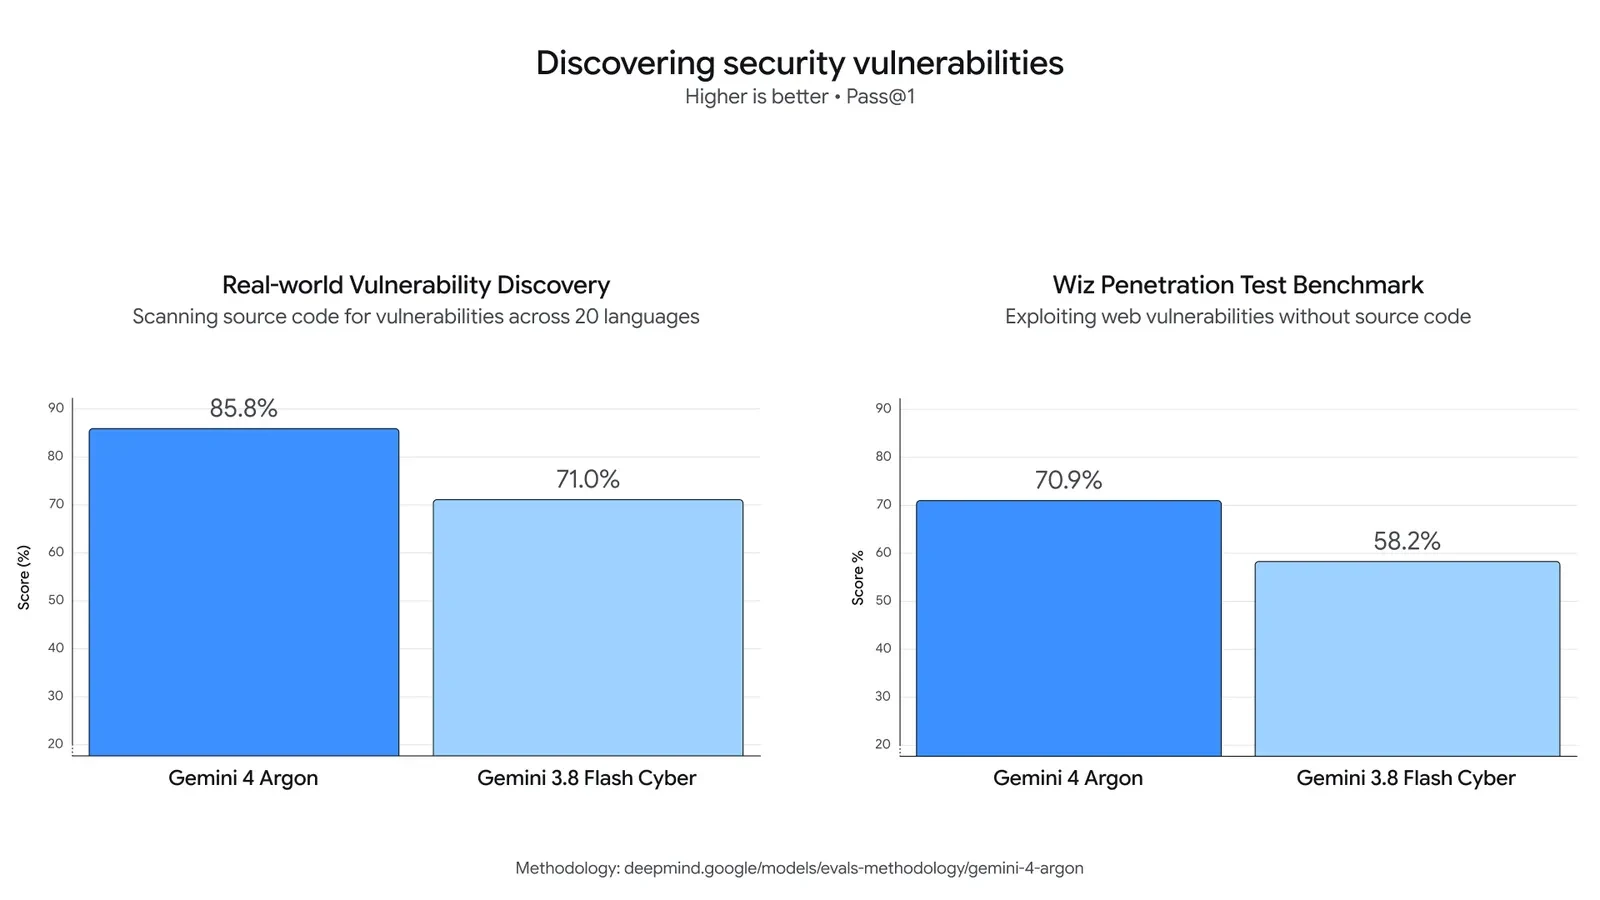
Wiz, Scan for Good girişimi kapsamında Argon’u kritik kamu altyapısını korumak için kullanıyor; Google, dünya çapında hastanelerin kullandığı sağlık yazılımında hassas kişisel bilgileri açığa çıkaran ve önceki frontier model’lerin kaçırdığı kritik bir açık bulduğunu söylüyor. Yazı, bu bulguya dair ayrıntı ya da düzeltme durumu vermiyor.
Güvenlik açıklarını gidermeyi sınayan CWE-bench v1’de Google, Argon’un %68 ile “birincilikle berabere” olduğunu söylüyor. Kendi liderlik tablosu bunun ne anlama geldiğini gösteriyor:
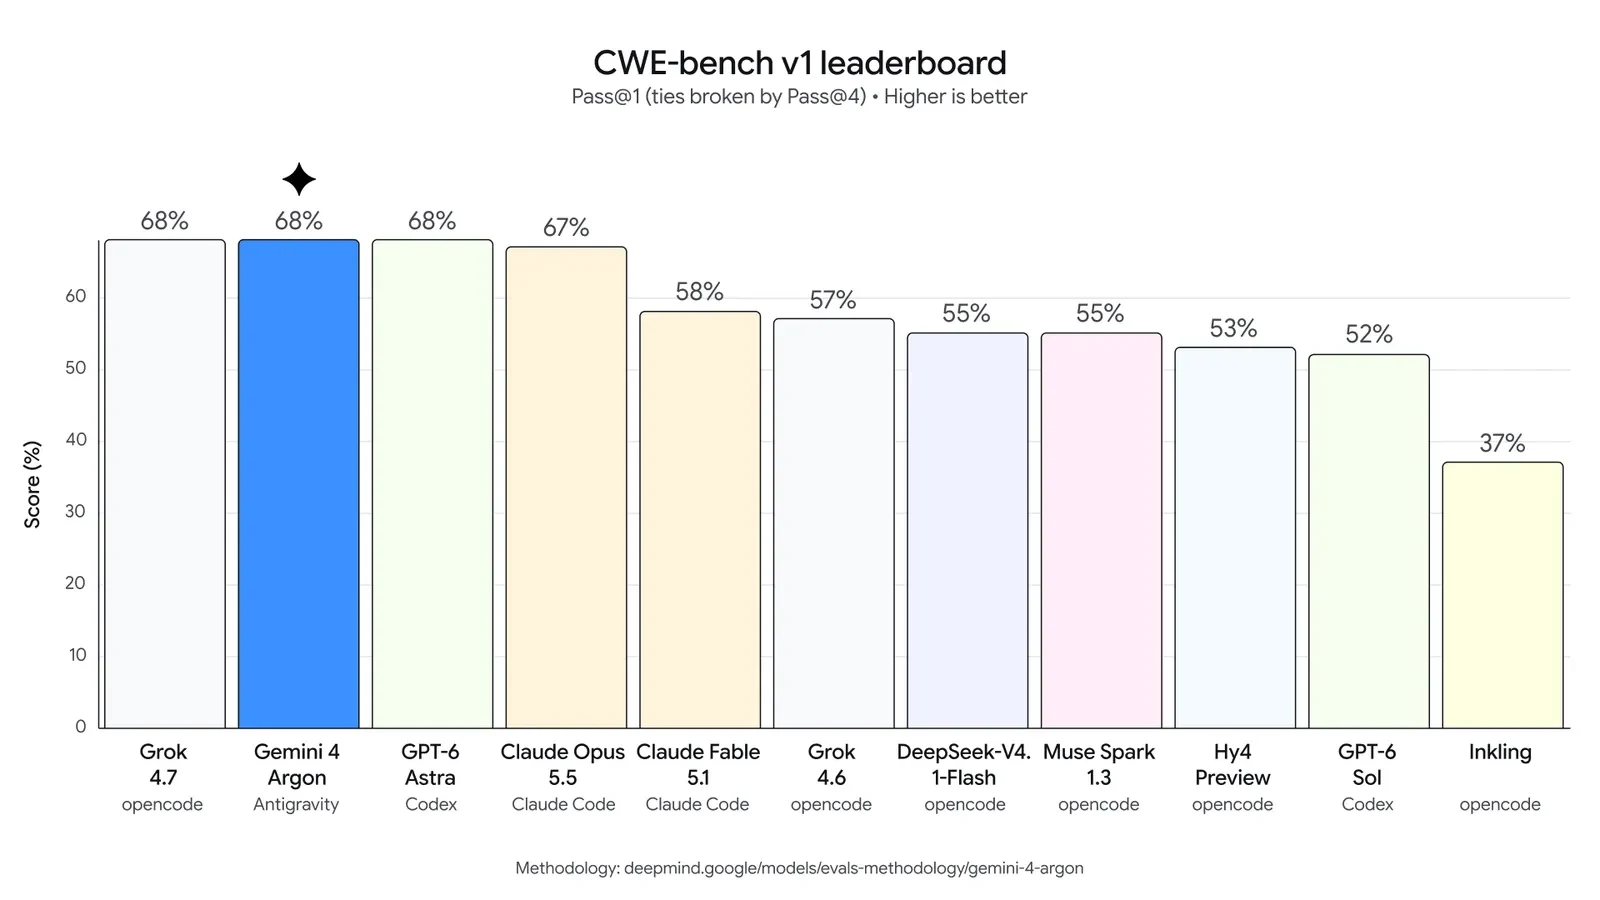
Üç model %68’i paylaşıyor: Grok 4.7, Argon ve GPT-6 Astra; Claude Opus 5.5 %67’de. Grafik beraberliği pass@4 ile bozuyor ve Grok 4.7’yi Argon’un önüne koyuyor. Ayrıca her modelin çalıştığı ajan altyapısını etiketliyor: Argon Antigravity’de, Astra Codex’te, Claude modelleri Claude Code’da, Grok ve diğerlerinin çoğu opencode’da. Dolayısıyla buradaki puan, model ile altyapısının birlikte sonucu.
Bazı kullanıcılar için siber korumasız
Bir cümle özellikle dikkat çekiyor: güvenilir savunmacılar ve Google’ın kendi ekipleri için “Argon’u, sınır seviyesindeki siber savunma yeteneklerinden tam yararlanabilsinler diye siber korumalar olmadan yayımlayacağız.” Yani Google’ın ikili kullanım sorununa cevabı önce erişim kontrolü, sonra model davranışı; geniş sürüm de böyle kademelendiriliyor.
Google’ın anlattığı güvenlik önlemleri
Google, geniş sürümden önce dört alanı güçlendirdiğini söylüyor:
- Kötüye kullanım: Model, siber ve CBRN dahil zararlı istekleri reddedecek, meşru ikili kullanımlı araştırmayı koruyacak şekilde tasarlandı. Google, modelin iç aktivasyonlarını izleme tekniklerini geliştirdiğini ve önlemlerin iç ve dış red team’lerce test edildiğini söylüyor.
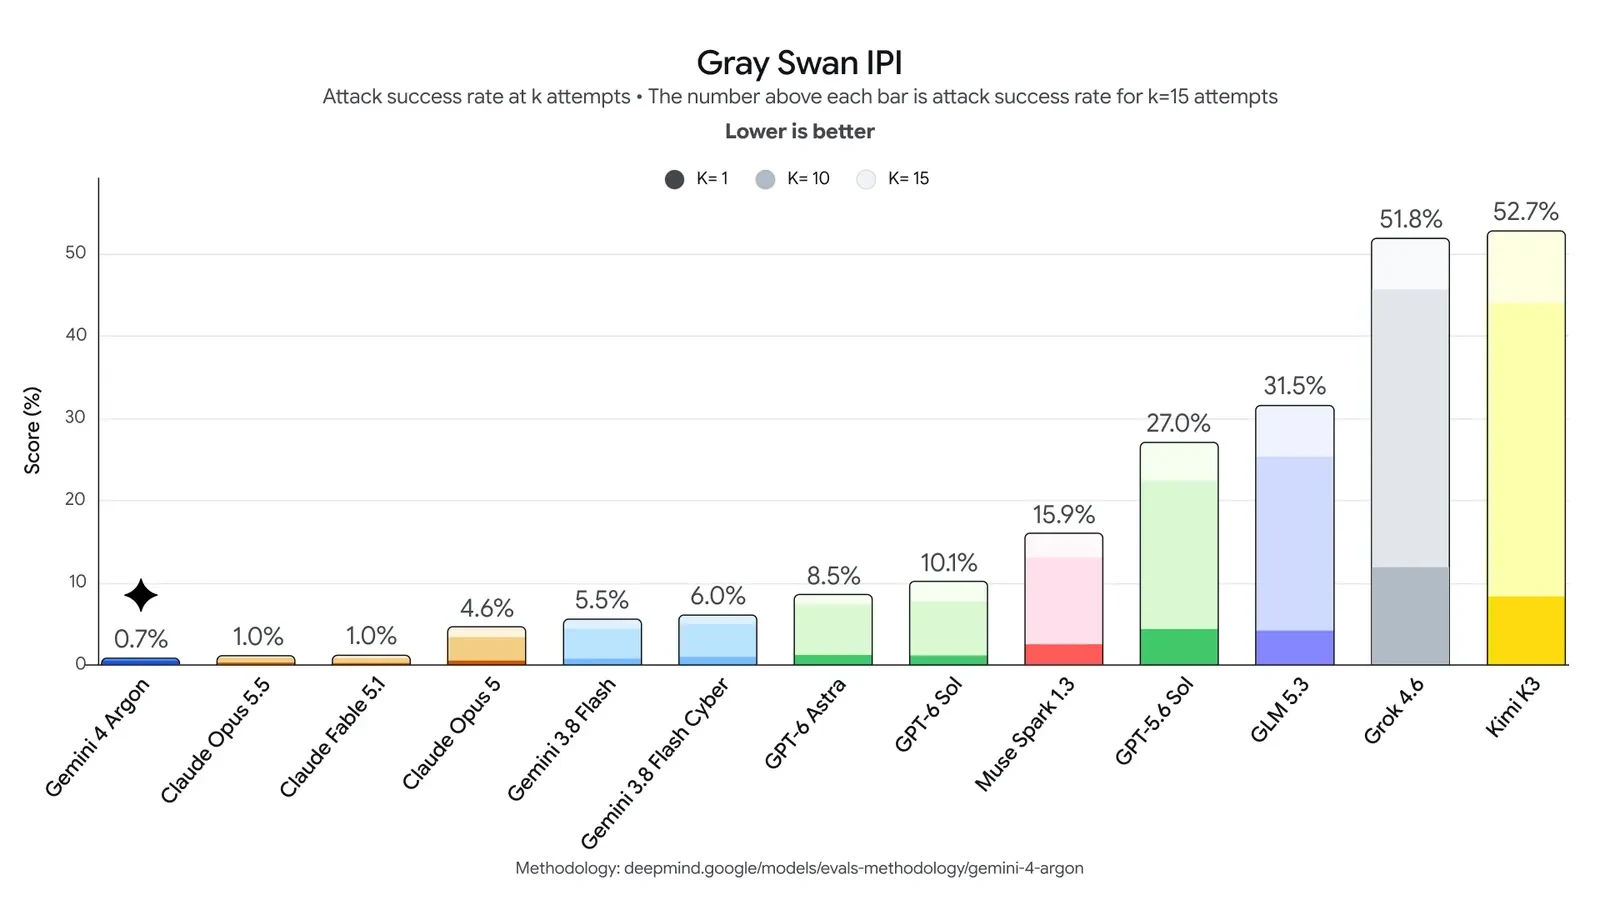
- Prompt injection: Google, Argon’u indirect prompt injection’a karşı şimdiye kadarki en dirençli modeli olarak niteliyor. Gray Swan grafiğinde 15 denemedeki saldırı başarı oranı Argon için %0,7, Claude Opus 5.5 ve Claude Fable 5.1 için %1,0, GPT-6 Astra için %8,5, GLM 5.3 için %31,5 ve Kimi K3 için %52,7. Düşük olan iyi.
- Misalignment: İzleyiciler Argon’un chain-of-thought’unu ve eylemlerini izliyor, gerekirse yürütmeyi durduruyor. Benzer bir sistem eğitim çalışmalarını izliyor ve bir olay müdahale ekibine uyarı gönderiyor. Google, bu bulguları modele izlemeden kaçmayı öğretmemek için eğitime geri beslemekten kaçındığını söylüyor ve sektörü akıl yürütme şeffaflığını korumaya çağırıyor.
- Sistemleri sertleştirme: Ajan kontrol yol haritası doğrultusunda Google, yüksek riskli eğitim ya da değerlendirmeler başlamadan önce sandbox ortamlarını yalıtıp mühürlediğini söylüyor.
Son ikisi bu hafta farklı okunuyor. OpenAI’ın Avustralya’dan özür dilediği ve bir Senato oturumuna katılmadığı haftada, OpenAI’ın ajan olayları zaman çizelgemizde sıraya koyduğumuz denetimleri, yani chain-of-thought izlemeyi, çalışmaları durdurmayı ve mühürlü sandbox’ları, Google yeni devreye aldığı şeyler olarak anlatıyor. OpenAI’ın Ağustos raporu da Astra sınıfı modellerinin kritik siber yeteneklere sahip olabileceğini söylüyor. Google’ın yazısı bu türden bir olay yaşadığını söylemiyor ve elimizde böyle bir olaya dair bir kanıt yok.
Nelere bakmalı
- Erişim: Fairwind grubunun nasıl seçildiği ve ücretli API müşterilerinin Argon’a ne zaman kavuşacağı.
- Bağımsız sonuçlar: Yukarıdaki her rakam Google’ın, Google’ın seçtiği benchmark ve altyapılarda çalıştırdığı rakamlar ve bir kısmı ortak ya da iç benchmark’lara dayanıyor. Argon’un geride kaldığı beş satır, önde olduğu 14 satır kadar bilgilendirici.
- Savunmacı bulguları: Sağlık yazılımındaki açık ayrıntısız anlatılıyor.
- Fiyat: 2 ve 10 dolarlık rakamlar tanıtım fiyatı ve iki katına çıkacak.
Editoryal inceleme: 30 Eylül 2026 (AI). Google’ın duyurusundan, benchmark tablosu ve grafikleri dahil aynı gün tamamı okunarak, ve OpenAI’ın Ağustos raporundan hazırlandı. Tüm performans ve maliyet rakamları Google’a aittir ve bağımsız olarak doğrulanmadı. Grafikler ve görsel Google’a aittir, kredi ve kaynak bağlantısıyla yeniden üretilmiştir; bağlı metodoloji sayfası incelenmedi.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder