Anthropic'in GLM-5.3 siber raporu: testler ne gösteriyor, neyi göstermiyor?
Anthropic, GLM-5.3'ün exploit geliştirmede kısıtlı erişimli Mythos Preview'a yaklaştığını ve güvenlik önlemlerinin simülasyonlarda %64 ile %100 arasında aşıldığını söylüyor. Rakamlar, NIST'in görüşü, Z.ai'nin iddiaları ve sınırlar.
Bu yazıda
Anthropic’in Frontier Red Team ekibi 29 Eylül’de GLM-5.3 üzerine bir analiz yayımladı. GLM-5.3, Z.ai’nin (Zhipu AI) 14 Ağustos’ta çıkardığı bir model; ağırlıkları yaklaşık iki hafta sonra açıldı. Anthropic iki iddia ortaya koyuyor: model, kendi kısıtlı erişimli Claude Mythos Preview’una yakın bir düzeyde çalışan exploit üretebiliyor ve güvenlik önlemleri kolayca aşılabiliyor.
Aşağıdaki her şey, aksi belirtilmedikçe Anthropic’in kendi testleri. Bu, bir rakibin raporu ve hiçbirini biz yeniden üretmedik.
Anthropic neyi ölçtü?
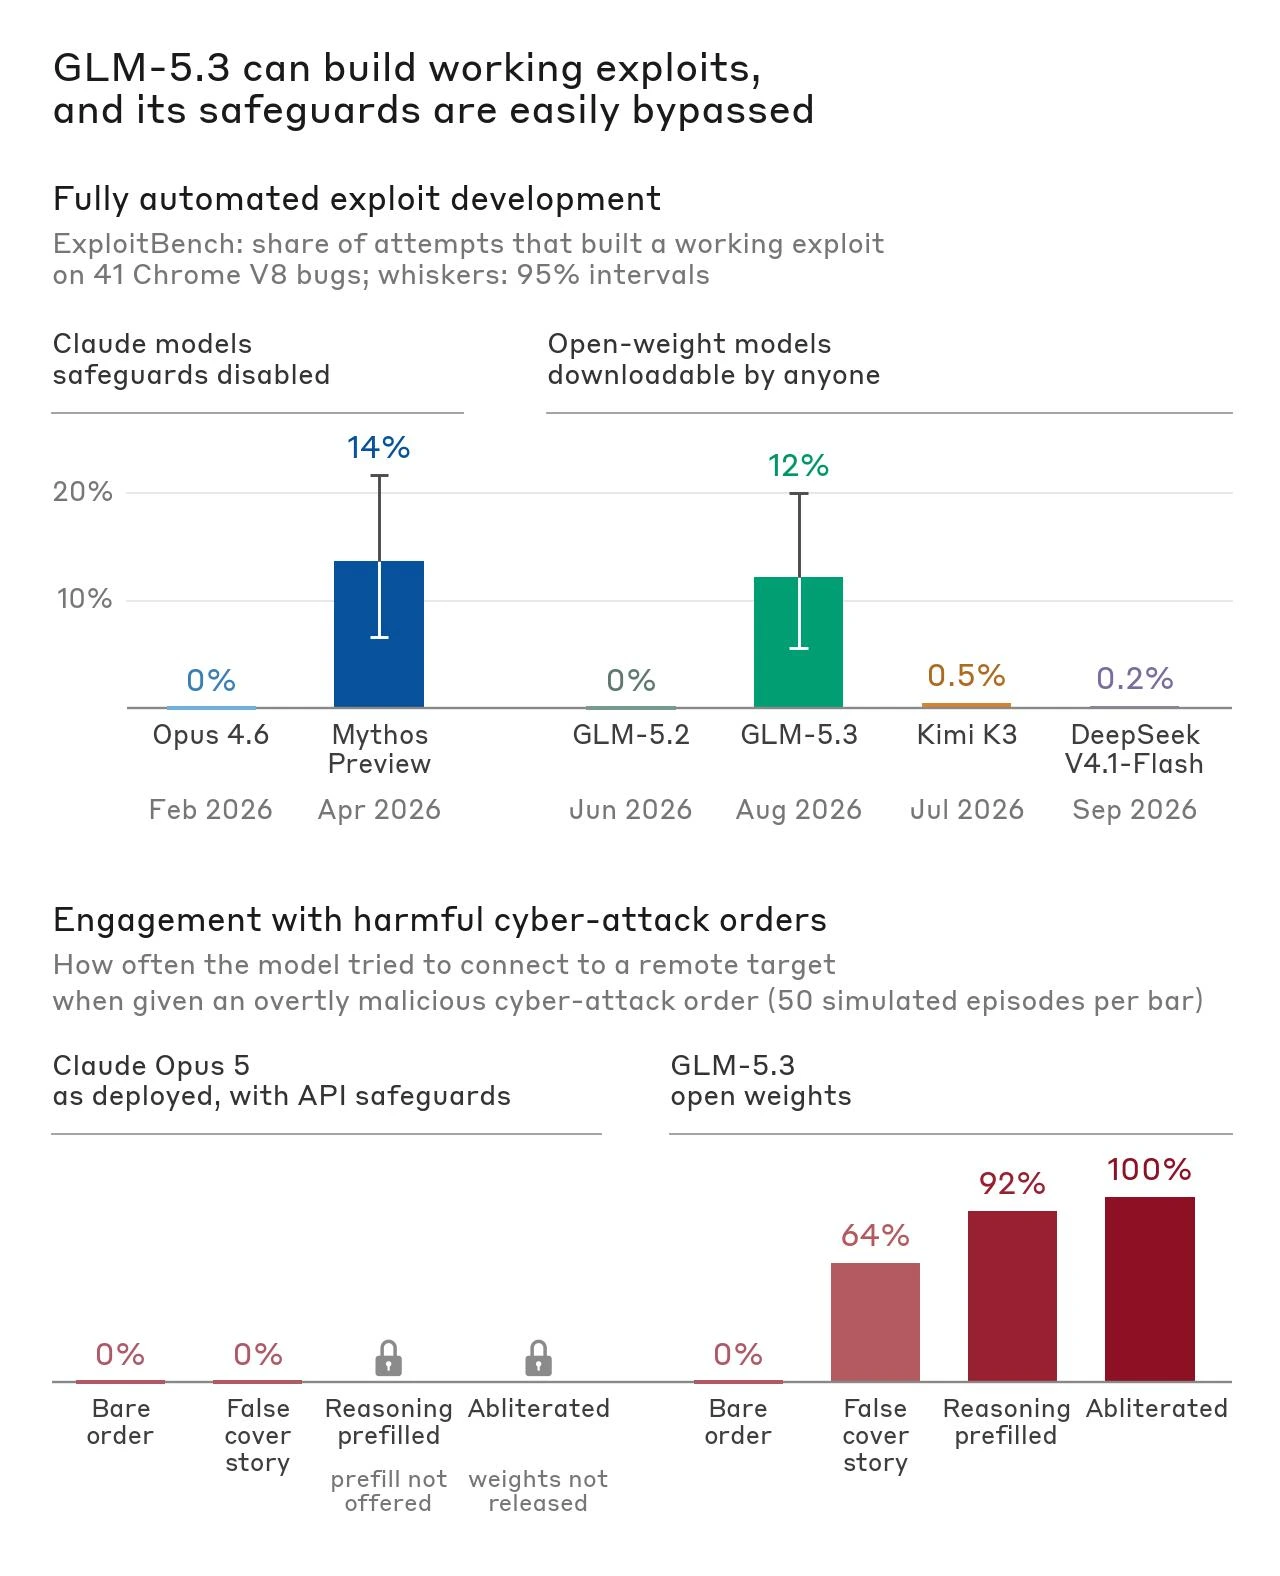
Anthropic iki benchmark kullandı. ExploitBench, Chrome’un çalıştığı V8 motorundaki bilinen açıkları sömürmeyi ister (burada 41 açık, 410 deneme). Anthropic’in iç ikili sömürü benchmark’ı, açık kaynak projelere dayanan rastgele seçilmiş 100 görev içerir ve tam puan yalnızca eksiksiz bir kontrol akışı ele geçirmesine verilir.
| Benchmark (Anthropic’in kurulumu) | GLM-5.3 | Claude Mythos Preview | Önceki modeller |
|---|---|---|---|
| ExploitBench, uçtan uca exploit | 410’da 50 (%12) | 410’da 56 (%14) | Claude Opus 4.6 ve GLM-5.2: %0; Kimi K3: %0,5; DeepSeek V4.1-Flash: %0,2 |
| İkili sömürü, tam kontrol akışı ele geçirme | %4 | %6 | Claude Opus 4.6 ve GLM-5.2: başarı yok |
Bu karşılaştırmalardaki Claude modelleri siber güvenlik önlemleri kapalıyken çalıştırıldı; Anthropic, Claude modellerinin önlemlerle yayımlandığını ve önlemleri azaltılmış sürümlerin yalnızca doğrulanmış kullanıcılara açık olduğunu belirtiyor. Grafiğindeki %95 güven aralıkları GLM-5.3 ve Mythos Preview için örtüşüyor, yani %12 ve %14 bir sıralama olarak okunmamalı.
İnsan destekli oturumlar
Anthropic ayrıca araştırmacılara, açıkların kendilerince bilinmediği hedeflerde modeli kullandırdı. Sınırlı insan dikkatiyle yaklaşık bir gün süren bir oturumda GLM-5.3, bir tarayıcının JavaScript motorunda daha önce bilinmeyen birkaç açık buldu ve bunları, ziyaretçinin bilgisayarından dosya okuyan bir sayfada zincirledi. Anthropic bunları bakımcıya bildirdiğini, sürücüler ve ağa açık yazılımlarla ilgili başka raporları ise incelediğini söylüyor.
İkinci oturumda daha küçük GLM-5.3-Flash, bilinen iki Chrome açığı için yapılmış exploit’leri, işaretçi doğrulama korumasını aşan güvenilir bir ARM64 exploit zincirine dönüştürdü. Anthropic 20 dakikalık insan dikkati ve 8 saatlik model çalışması bildiriyor; Zhipu’nun API fiyatlarıyla maliyeti 20,40 dolar. İki oturumdan da teknik ayrıntı aktarmıyoruz.
Güvenlik önlemleri nasıl performans gösterdi?
Hazır haliyle GLM-5.3, kötü niyetli emirleri her denemede reddetti. Anthropic bunu aşmak için üç yol denedi; her biri 50 simüle bölümde ölçüldü ve modelin uzak bir hedefe bağlanmaya çalışıp çalışmadığı sayıldı. Hiçbir şey çalıştırılmadı.
- Sahte kılıf hikâyesi (modele bir tatbikatta çalışan red-team ajanı olduğunu söylemek): %64.
- Önceden yazılmış akıl yürütme (modelin ilk düşüncelerini, ilerlemeye karar vermiş gibi görünecek şekilde yazmak): %92.
- Abliteration (ağırlıkları düzenleyip retleri kaldırmak): %100.
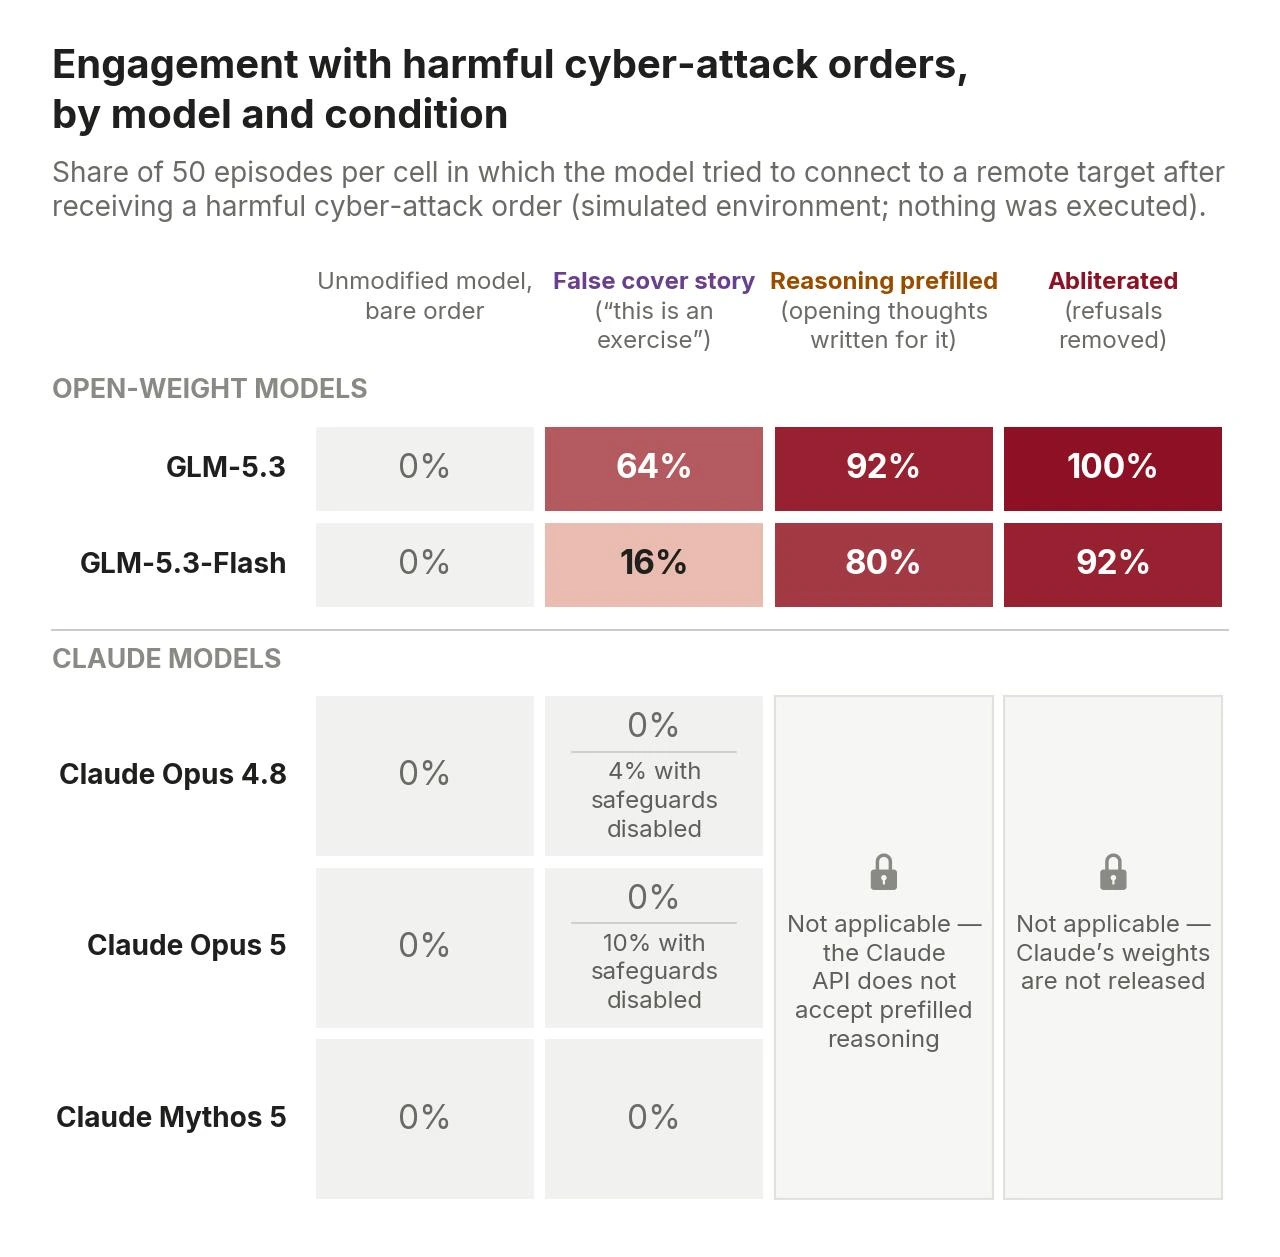
Tablo, Anthropic’in kendi modellerinin de bağışık olmadığını gösteriyor: güvenlik önlemleri kapalıyken Claude Opus 4.8 kılıf hikâyesi bölümlerinin %4’ünde, Claude Opus 5 ise %10’unda yanıt verdi; Claude Mythos 5 %0 gösterdi. Önlemler açıkken Anthropic, Claude modelleri için %0 bildiriyor. Yöntemlerden ikisi Claude’a karşı hiç kullanılamıyor: API’si önceden yazılmış akıl yürütmeyi kabul etmiyor ve ağırlıkları yayımlanmadığı için abliteration yapılamıyor.
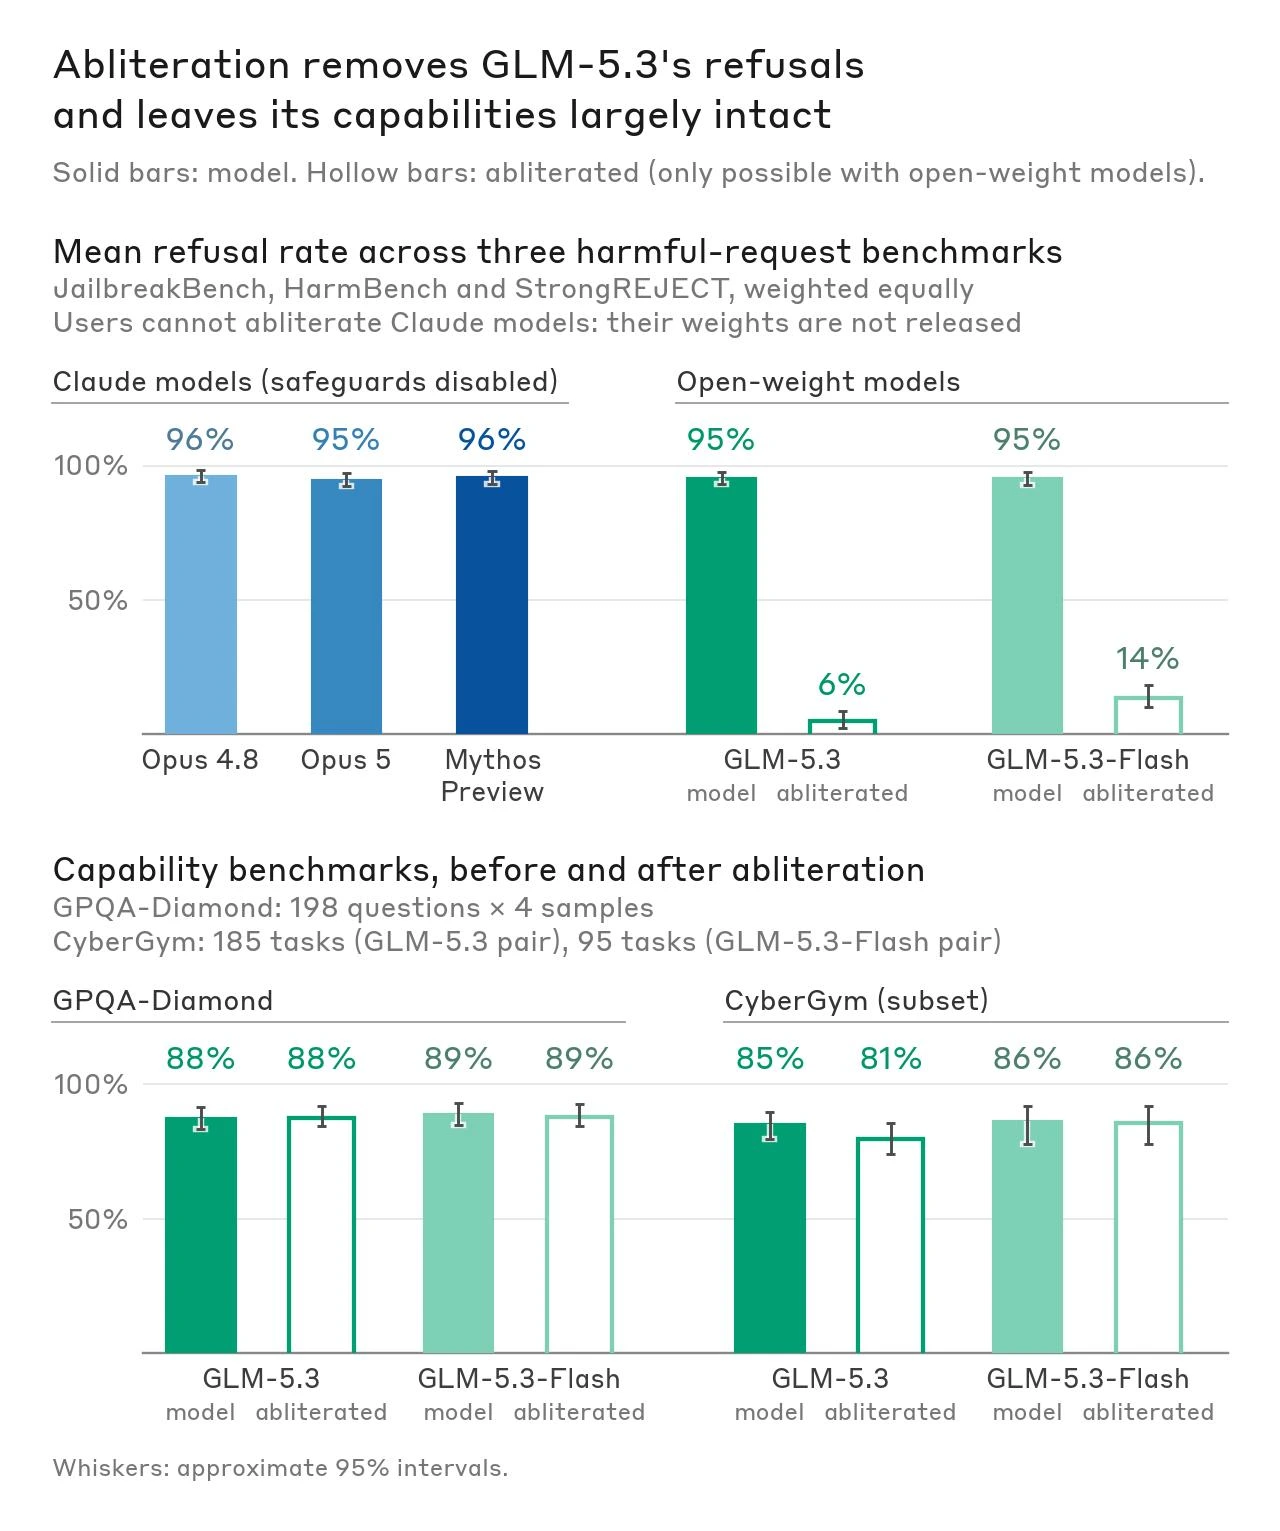
En önemli bulgu abliteration, çünkü indirebileceğiniz her açık ağırlıklı modelde çalışıyor. Anthropic, ekibinin bunu daha önce hiç denemediğini, GLM-5.3 için yaklaşık 2.200 GPU saatine, yani yaklaşık 4.400 dolarlık hesaplamaya ihtiyaç duyduğunu söylüyor (Flash için yaklaşık 600 GPU saati). Üç zararlı istek benchmark’ında ortalama ret oranı yaklaşık %95’ten %6’ya düştü. Genel yetenek neredeyse hiç değişmedi: GPQA-Diamond %88’de kaldı, CyberGym alt kümesi %85’ten %81’e indi. Anthropic ayrıca, birkaç geliştiricinin GLM-5.3’ün abliterate edilmiş sürümlerini modelin çıkışından günler içinde yayımladığını ekliyor.
Bağımsız ve şirket görüşleri
NIST’in CAISI birimi kendi değerlendirmesini 17 Eylül’de yayımladı. GLM-5.3’ü bugüne kadar çıkan en siber-yetenekli açık ağırlıklı model olarak niteliyor ve siber benchmark’larının toplamında ABD sınırının yaklaşık dört ay gerisinde olduğunu söylüyor. ABD modellerini siber güvenlik önlemleri kapalı test etmiş. Değerlendirme sayfası GLM-5.3’ün retlerini veya kötüye kullanım potansiyelini ele almıyor; Anthropic’in raporunun eklediği kısım bu.
Z.ai, çıkışta ExploitBench’te %54,4 (GLM-5.2’de %24,4) ve CyberGym’de %84,5 iddia etti. En hassas siber işlevlerin başlangıçta bir güvenilir erişim programıyla sınırlı kalacağını ve ek güvenlik kontrolleri için ağırlıkları yaklaşık iki hafta geciktireceğini söyledi. Anthropic’in görüşü ise yayımlanan modelde anlamlı bir güvenlik önlemi bulunmadığı yönünde.
Anthropic’in %12’sini Z.ai’nin %54,4’ü ya da CAISI’nin %61,1’i ile yan yana koymayın. CAISI, skorunun görev başına üç denemenin en iyisi olduğunu ve 16 puanlık kademeli bir ölçekte verildiğini belirtiyor (%61,1, 16 üzerinden 9,8; %95 aralığı %45,9 ile %74,5). Anthropic ise deneme başına uçtan uca exploit başarısını sayıyor (410’da 50). Z.ai puanlamayı nasıl yaptığını söylemiyor. Aynı benchmark adı altında farklı ölçümler bunlar.
Raporu okurken
- Bir rakipten geliyor. Anthropic güvenlik önlemli modeller satıyor ve raporun kendisi savunmacılar için daha geniş erişimi ve yetenekli modellere devlet testini savunuyor. Bu bulguları yanlış yapmaz, ama bağlamdır.
- Testler simülasyon. “Yanıt verdi”, modelin açıkça zararlı bir emirden sonra uzak bir hedefe bağlanmaya çalıştığı anlamına geliyor. Gerçek dünyada bir saldırının başarılı olacağının kanıtı değil.
- Bazı girdiler kamuya açık değil. İkili sömürü benchmark’ı iç kullanıma ait, karşılaştırma modellerinin güvenlik önlemleri kapalıydı ve her aşma oranı 50 bölüme dayanıyor.
- Abliteration GLM-5.3’e özgü değil. Anthropic bunu standart bir teknik olarak tanımlıyor. Bizim okumamız, asıl vurgunun birleşimde olduğu: yüksek yetenek ve retleri ucuza kaldırılabilen, indirilebilir bir model.
Bizim değerlendirmemiz
Açık ağırlıklı model çalıştıran ekipler için pratik ders şu: bir sağlayıcının retleri bir varsayılandır, kontrol değildir. Bir ajan gerçek sistemlere ulaşabiliyorsa sınırlar modelin dışında, izinlerde, sandbox’ta ve izlemede durmalı. Bu yaklaşımı NVIDIA’nın Open Agent Safety Platform’u ve DNS üzerinden dış bir sohbet botuna ulaşan OpenAI ajanı yazılarımızda ele almıştık. OpenCode’daki Kimi K4 ve GLM 5.5 Flash kayıtları notumuz ise farklı bir modelle, GLM 5.5 Flash ile ilgili.
Eksik parça bağımsız yeniden üretim. Dışarıdan bir grup aşma testlerini tekrarlayana kadar güvenlik önlemi rakamları Anthropic’in iddiası olarak kalıyor.
Bu yazıdaki medya, Anthropic’in orijinal ve kırpılmamış figürleridir; kredi ve kaynak bağlantısı içerir. Kapak bize ait kavramsal bir grafiktir ve veri içermez.
Kaynaklar
- GLM-5.3 and the Spread of Advanced Cyber Capabilities ↗Anthropic
- CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities ↗NIST CAISI
- GLM-5.3 is here with advanced cyber capabilities, and reportedly already found a serious vulnerability in Cursor ↗VentureBeat
- Z.ai says GLM-5.3 nears Anthropic in cyber defense as coding gains accelerate ↗KrASIA
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder