Anthropic distillation savunmaları: %90–99 iddiası ne anlama geliyor?
Anthropic, yeni önlemlerin distiller'ların topladığı veriyi %90–99 azalttığını söylüyor. Sınıflandırıcı, korunan düşünme ve yasaklar nasıl işliyor?
Bu yazıda
- Distillation saldırısı nedir?
- Anthropic’in yeni savunmaları nasıl çalışıyor?
- Rakamlar ne gösteriyor?
- %90–99 iddiasına ne kadar güvenilir?
- Anthropic, Zhipu ve Moonshot hakkında ne iddia etti?
- Bedeli ne, Anthropic başkalarından ne istiyor?
- Distillation savunmaları hakkında neler hâlâ belirsiz?
- Akılda tutulacaklar
Anthropic, Claude’u akıl yürütmesi üzerinden eğiterek kopyalamayı çok daha zorlaştırdığını söylüyor ve rakamlar yayımladı. Şirket 12 Ekim’de yeni yöntemlerin distiller’ların topladığı veri miktarını “yaklaşık yüzde 90 ila 99” azalttığını, ancak kazanımların ne kadar süreceğini bilmediğini söyledi. Yazıyı iki grafiğiyle birlikte tam okuduk. Bu yazı savunmaların ne olduğunu, rakamların neyi gösterdiğini ve neyi gösteremeyeceğini anlatıyor.
Distillation saldırısı nedir?
Bir modelin yeteneklerini izinsiz başka bir modele kopyalamaya yönelik gizli bir kampanya. Anthropic bunları, çoğu zaman sahte hesap ağlarıyla yürütülen endüstriyel ölçekli çabalar olarak tanımlıyor: distiller’lar güçlü bir modelden milyonlarca yanıt üretiyor ve daha küçük bir modeli onu taklit edecek şekilde eğitiyor. En değerli veri yalnızca nihai yanıt değil, modelin yazdığı akıl yürütme. Anthropic iki nedenle endişeli: distill edilmiş modeller orantılı güvenlik önlemleri olmadan sınıra yaklaşıyor ve yabancı askerî, istihbarat ve gözetim sistemlerini besleyebiliyor.
Anthropic’in yeni savunmaları nasıl çalışıyor?
Üç katman, hepsi Claude’un akıl yürütmesini çıkarmayı zorlaştırmaya yönelik:
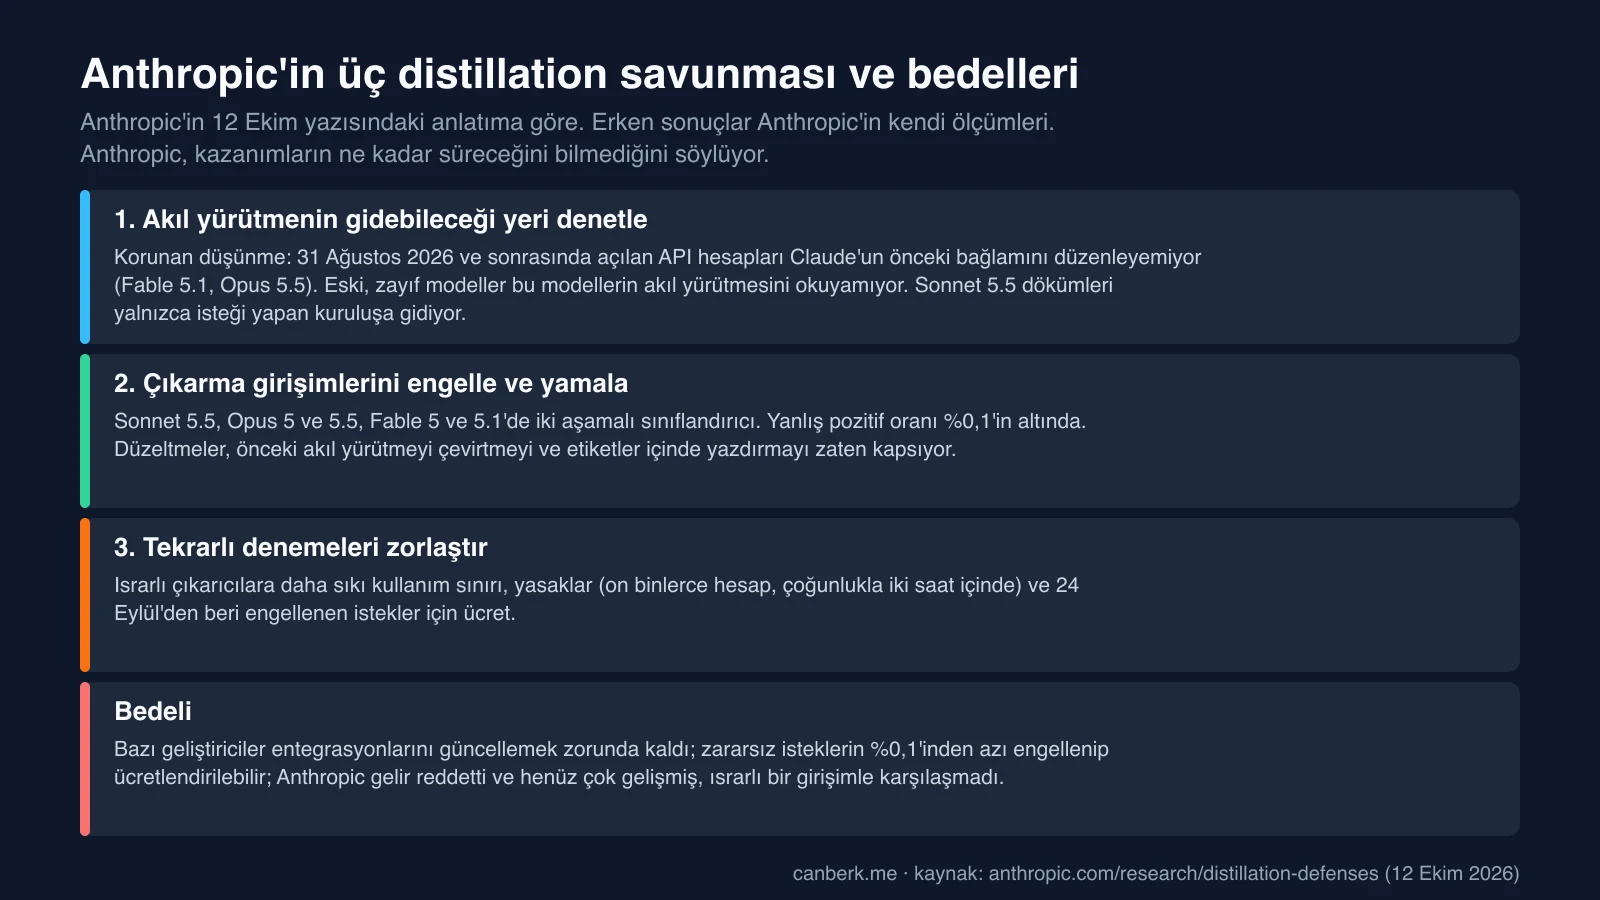
- Akıl yürütmenin gidebileceği yeri denetlemek. Anthropic, Claude Fable 5.1 ve Claude Opus 5.5 ile korunan düşünmeyi getirdi; 31 Ağustos 2026 ve sonrasında açılan API hesapları Claude’un önceki bağlamını düzenleyemiyor. Bu, proxy ağı hesaplarını tekrar tekrar kullanıp modeli korunan akıl yürütmeyi açığa çıkarmaya kandırmayı zorlaştırıyor. Ayrıca daha zayıf önlemli eski modellerin bu modellerin akıl yürütmesini okumasını engelliyor; Claude Sonnet 5.5 ile dökümlere yalnızca isteği yapan kuruluş erişebiliyor.
- Çıkarma girişimlerini engellemek ve yamalamak. Anthropic’in anayasal sınıflandırıcılar araştırmasında anlatılan türden iki aşamalı bir sınıflandırıcı artık Sonnet 5.5, Opus 5 ve 5.5 ile Fable 5 ve 5.1’de çalışıyor. Anthropic, önlemlerinin biyolojik silah yardımına karşı olanlar kadar “kabaca sağlam” olduğunu, yanlış pozitif oranının %0,1’in altında olduğunu ve düzeltmelerin Claude’a önceki akıl yürütmesini çevirtmek ya da etiketler içinde yazdırmak gibi boşlukları zaten kapattığını söylüyor.
- Tekrarlı denemeleri zorlaştırmak. Israrlı çıkarıcılar daha sıkı kullanım sınırlarıyla ve yasaklarla karşılaşıyor. Anthropic ayrıca 24 Eylül’den beri, yanlış pozitif oranının %0,1’in altında olduğu alanlarda, Claude yanıt vermeden önce önlemlerinin engellediği istekler için yeniden ücret alıyor.
Rakamlar ne gösteriyor?
Anthropic’in kendi platformunda akıl yürütme çıkarımının keskin biçimde düştüğünü, ama sıfıra inmediğini. Anthropic, distiller’ların çıkardığı akıl yürütme token’ının sınıflandırıcıdan önceye göre “tutarlı biçimde 10 ila 100 kat düşük” olduğunu, bazı günlerde miktarın ölçülemeyecek kadar küçük kaldığını tahmin ediyor.
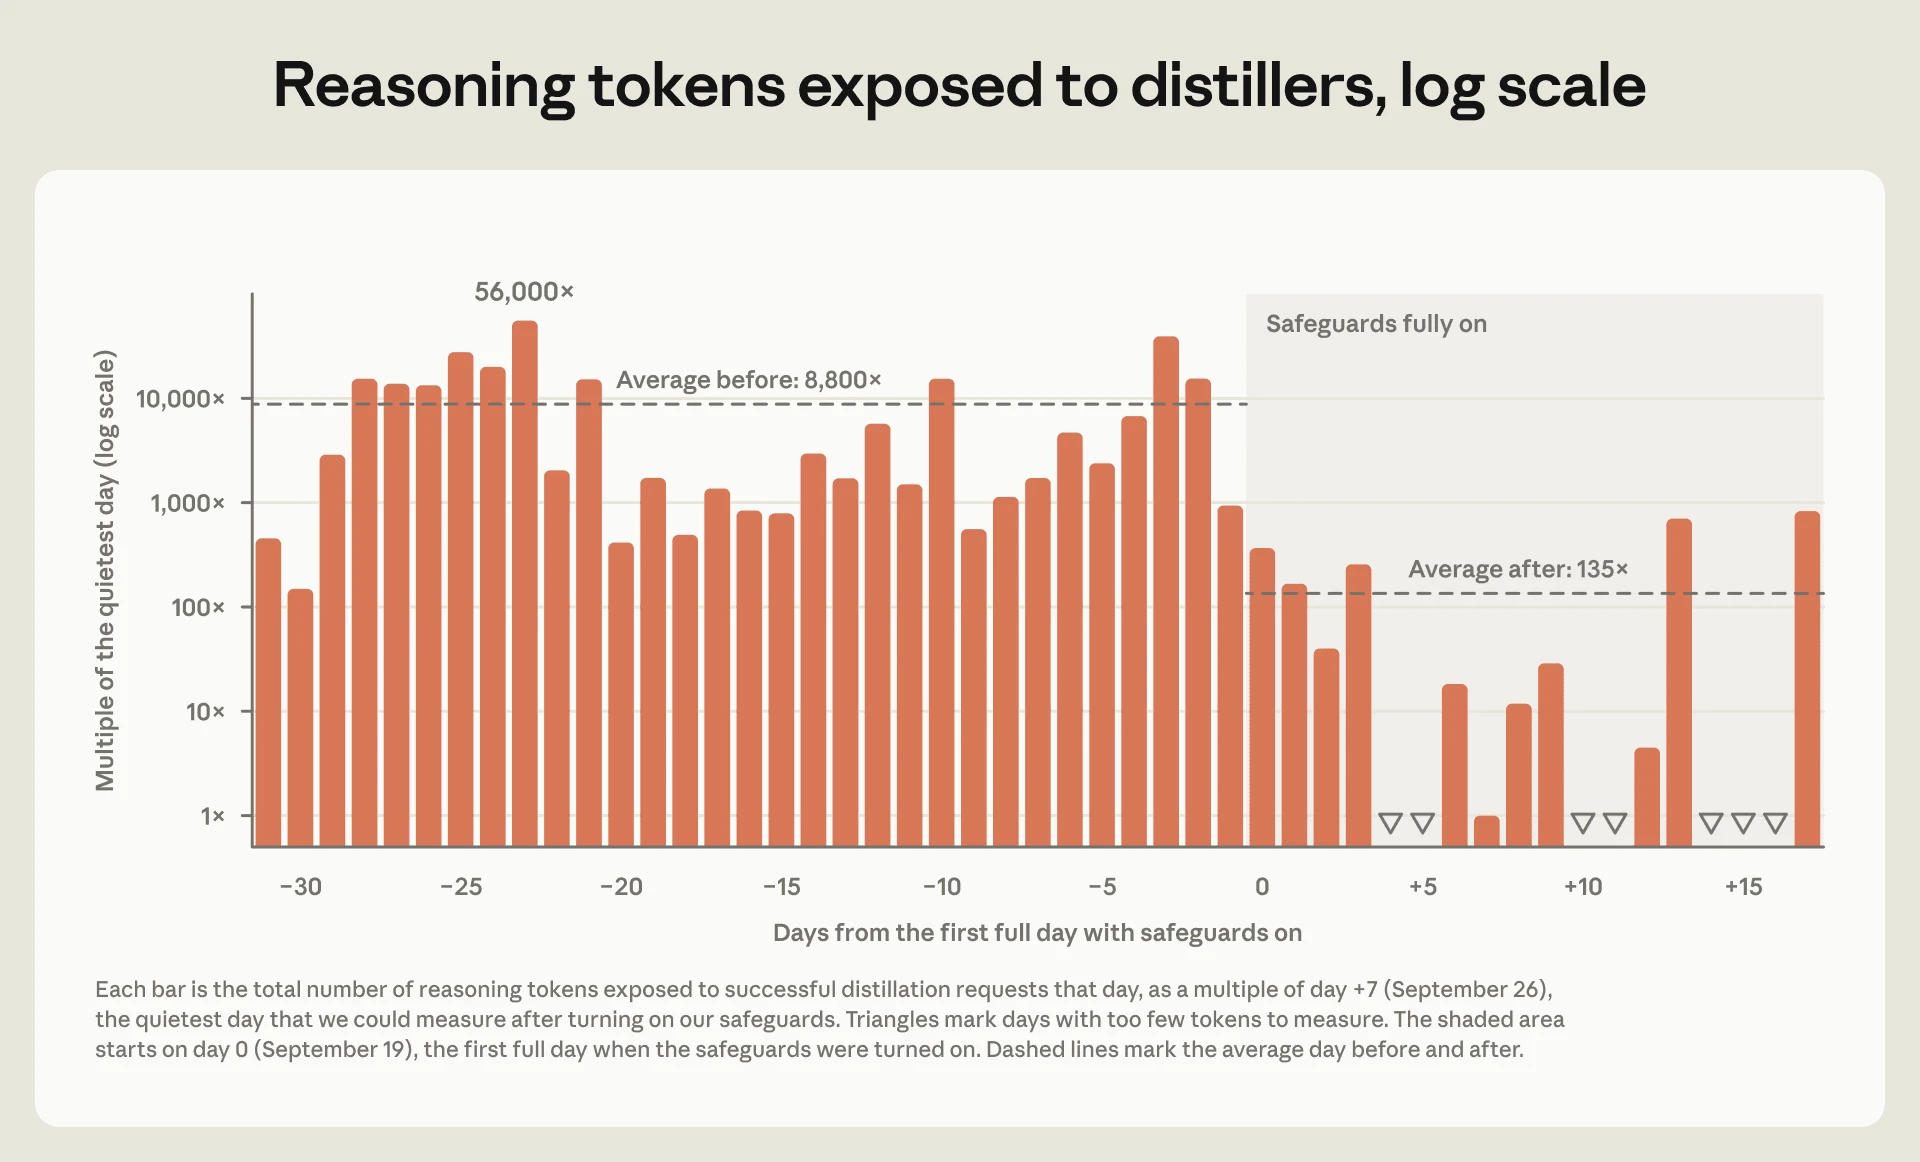
Grafik her günü, önlemler tam açıldıktan (0. gün, 19 Eylül) sonraki ölçülebilir en sakin gün olan 26 Eylül’ün katı olarak ifade ediyor. Öncesinde ortalama gün 8.800 kat, zirve 56.000 kat; sonrasında ortalama 135 kat. Bizim hesabımıza göre bu ortalama düşüş kabaca 65 kat, yani Anthropic’in 10–100 aralığının içinde. Grafik ayrıca iyileşmenin pürüzsüz olmadığını gösteriyor: lansmandan birkaç gün sonrası taban değerin birkaç yüz katına geri sıçrıyor.
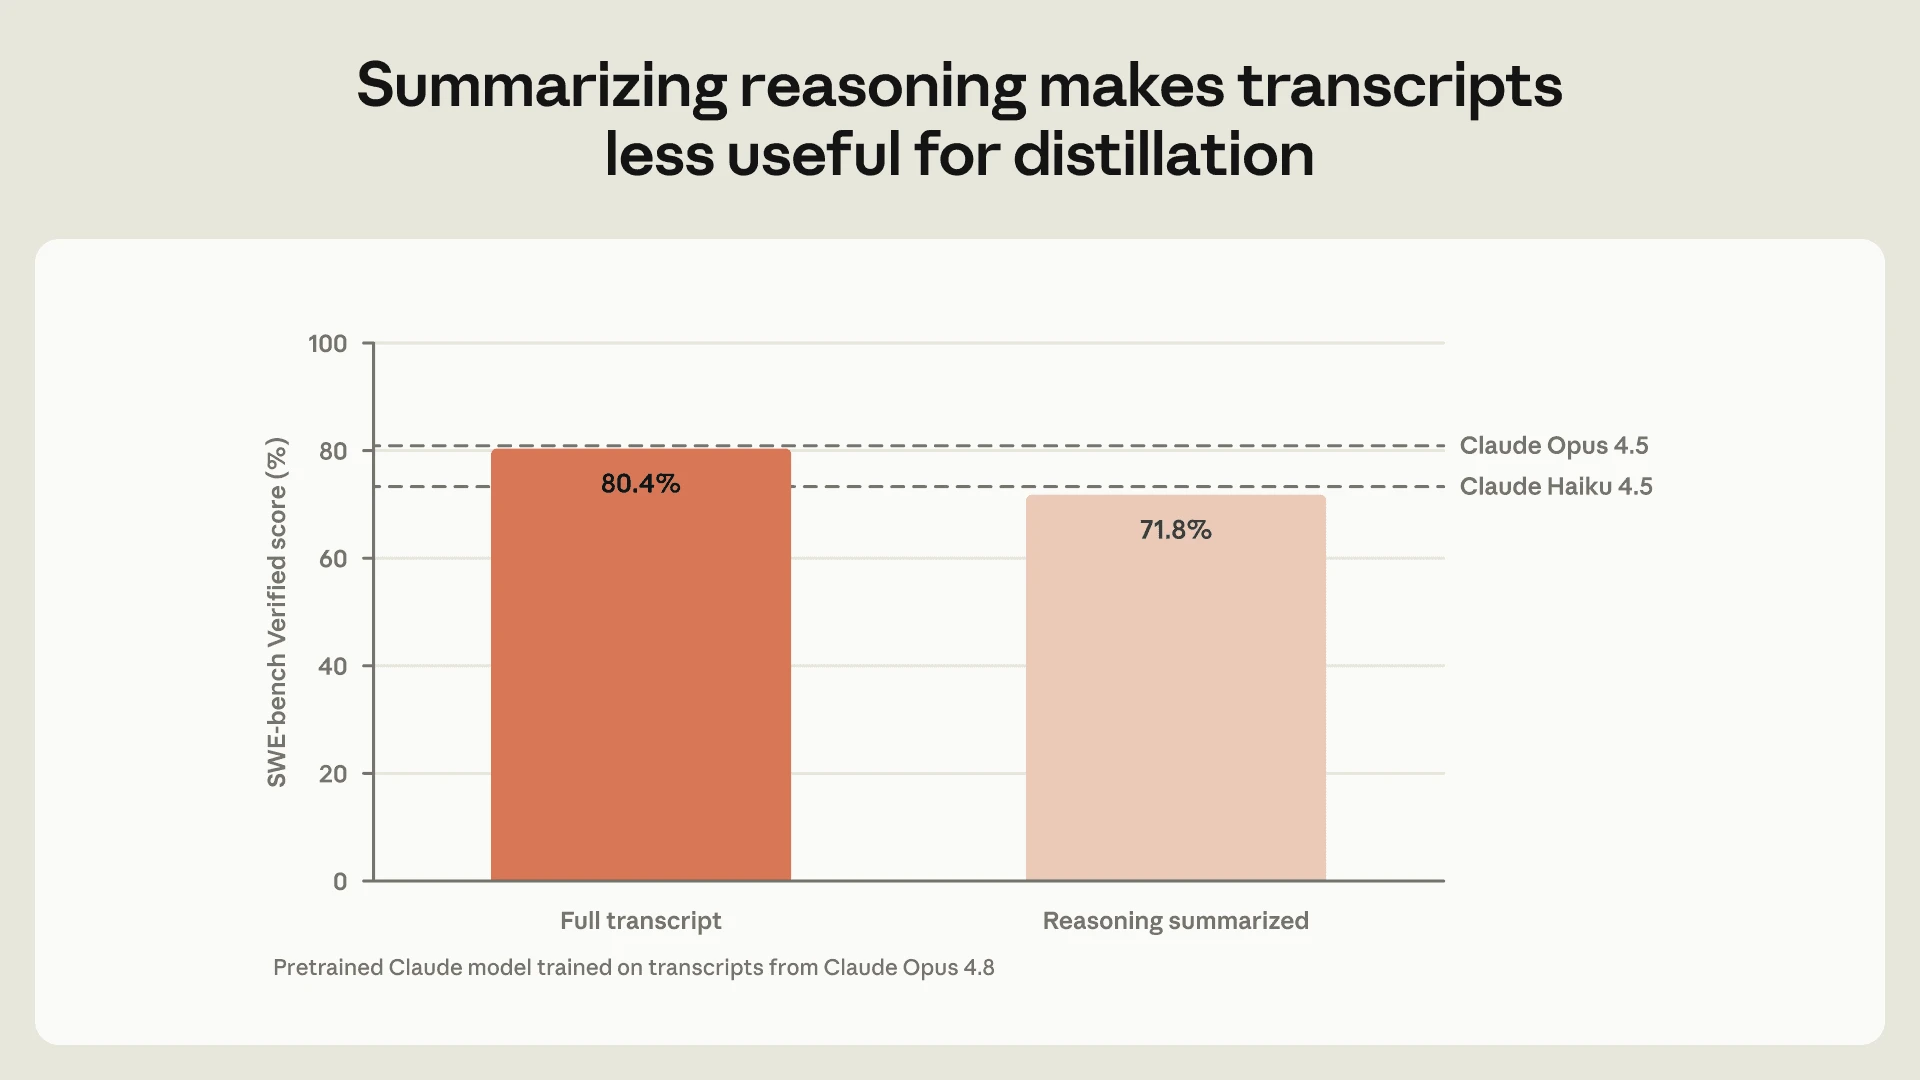
Anthropic akıl yürütmeyi özetlemenin daha önce ne yaptığını da bildiriyor. Tam Claude Opus 4.8 dökümleriyle eğitilen önceden eğitilmiş bir Claude modeli SWE-bench Verified’da %80,4 aldı; özetlenmiş dökümlerle eğitilen %71,8.
%90–99 iddiasına ne kadar güvenilir?
Güvenilir bir iç ölçüm olarak okuyun, bağımsız bir ölçüm olarak değil. Dört sınır önemli:
- Anthropic’in kendi platformunda ölçülüyor. Yazı, distiller’ların trafiği Anthropic API’sine, üçüncü taraf bulut platformlarına ve diğer çıkarım sağlayıcılara yaydığını söylüyor; başka yerlerdeki çıkarım bu rakamların dışında.
- Erken. Anthropic bu kazanımların “ne kadar süreceğini henüz bilmediğini” ve önlemleri aşmaya yönelik “son derece gelişmiş ve ısrarlı bir girişim”i henüz görmediğini söylüyor.
- Ölçü token, sonuç değil. Rakamlar açılan akıl yürütme token’ını ve toplanan veriyi sayıyor. Distill edilmiş bir modelin kötüleşip kötüleşmediğini göstermiyor.
- Hiçbiri bağımsız doğrulanmadı. Sınıflandırıcının veya Anthropic’in yasakladığını söylediği hesapların dışarıdan bir testini bulamadık.
Anthropic, Zhipu ve Moonshot hakkında ne iddia etti?
Zhipu’nun GLM-5.3’ü geliştirirken ABD modellerinin siber yeteneklerini distill ettiğini ve Moonshot’un Kimi trafiğinin gizlice Claude’a gönderildiğini. Anthropic, Zhipu’nun Claude Fable 5’i distill etmeye çalıştığını, ancak siber önlemleri saldırılarını zayıflatınca eski bir Claude modeline ve başka bir laboratuvarın modeline geçtiğini söylüyor. ABD Süper Zekâ için İnovasyon ve Standartları İlerletme Merkezi’nin (CAISSI) GLM-5.3’ü bugüne dek yayımlanan en siber-yetenekli açık ağırlıklı model olarak değerlendirdiğini ve kendi araştırmasının modelin önlemlerinin kolayca aşılabildiğini bulduğunu belirtiyor. GLM-5.3 siber raporunu daha önce ele almıştık.
Moonshot için Anthropic, Kimi modellerine gelen isteklerin Claude’a yönlendirildiği bir vakayı gösteriyor; bunlardan biri, Çin Halk Kurtuluş Ordusu’yla bağlantılı olduğuna inandığı bir kullanıcıdan, belirli bir kişinin CCTV görüntülerinin analizi için geliyor. Bunlar Anthropic’in kendi soruşturmalarından gelen iddialar. Zhipu veya Moonshot’tan kamuya açık bir yanıt bulamadık.
Bedeli ne, Anthropic başkalarından ne istiyor?
Anthropic ödünleşimleri kabul ediyor. Korunan düşünme bazı geliştiricilerin entegrasyonlarını güncellemesini gerektirdi, sınıflandırıcılar zararsız istekleri %0,1’den azında yanlış tanımlayabiliyor ve engellenen istekler artık ücretlendiriliyor. Distiller’lardan “anlamlı gelir ve trilyonlarca token değerinde ücretli trafik” reddettiğini söylüyor. Diğer geliştiricilerin ve platformların da harekete geçmesi gerektiğini savunuyor, çünkü savunmalar pahalı ve “yasadışı distiller’lar hâlâ ödeme yapan müşteriler.”
Distillation savunmaları hakkında neler hâlâ belirsiz?
- Dayanıklılık. Anthropic kedi-fare oyunu bekliyor ve henüz çok gelişmiş bir saldırı görmediğini söylüyor.
- Bağımsız doğrulama. Çıkarım rakamları, yasak sayıları ve sınıflandırıcı sonuçları yalnızca Anthropic’ten geliyor.
- Distill edilmiş modellere etkisi. Yazı, distiller’ların gerçekte ne kadar yetenek kaybettiğini göstermiyor.
- Adı geçen laboratuvarların yanıtları. Bulamadık.
- Diğer laboratuvarlarla kıyas. Anthropic, benzer önlemleri olmayan laboratuvarlar yüzünden çabalarının zayıfladığını söylüyor, ancak Zhipu örneği dışında hangilerinde eksik olduğunu belirtmiyor.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Savunma yanıtları değil, akıl yürütmeyi hedefliyor. Anthropic’in kendi SWE-bench sonucu nedenini gösteriyor: tam akıl yürütme dökümleri yaklaşık dokuz puan değerindeydi.
- Logaritmik grafiği dikkatle okuyun. Ortalama maruziyette 65 katlık düşüş büyük, ama bazı günler hâlâ geri sıçrıyor.
- Kapsam dar. Rakamlar Anthropic’in kendi platformunu ve en yetenekli modellerini kapsıyor.
- Geliştiriciler hissediyor. Korunan düşünme ve ücretli engellenen istekler entegrasyonların davranışını değiştiriyor.
Editoryal inceleme: 13 Ekim 2026 (AI). Anthropic’in araştırma yazısı (iki grafiği dahil tam okundu) ile bağlantılı Eylül tehdit istihbaratı raporu ve GLM-5.3 araştırma sayfası (tam yeniden okunmadı) esas alınarak hazırlandı. Sınıflandırıcıyı test etmedik, hiçbir hesap yasağını doğrulamadık ve Zhipu veya Moonshot ile iletişime geçmedik.
Kaynaklar
- Strengthening our defenses against distillation attacks (Anthropic, 12 Ekim 2026) ↗Anthropic
- Threat intelligence report: September 2026 (Anthropic) ↗Anthropic
- GLM-5.3 and the spread of advanced cyber capabilities (Anthropic) ↗Anthropic
- CAISSI assessment of Z.ai's GLM-5.3 cyber capabilities (NIST, Anthropic'in yazısından bağlantılı) ↗NIST
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder