Claude Opus 5.5 yayımlandı: daha düşük API fiyatları, güçlü kodlama sonuçları
Anthropic’in yeni amiral gemisi kullanıma açıldı. API fiyatları, dokuz lansman benchmark’ı, resmî kapak ve geliştiricilerin kontrol etmesi gereken entegrasyon değişiklikleri.
Anthropic, 22 Eylül’de Claude Opus 5.5’i yayımlayarak yeni 5.5 ailesini başlattı. Duyuru, daha güçlü kodlama sonuçlarını daha düşük token fiyatlarıyla birleştiriyor. Sonnet 5.5 ve Haiku 5.5 önümüzdeki haftalar için planlanıyor; bugünkü sürümün parçası değiller.
Fiyatı ne kadar?
Aşağıdaki standart API ücretleri, milyon token başına ABD doları cinsinden. Önbellekten okumanın ayrı tarifesi var; bu token’lar önbelleksiz girdi gibi hesaplanmamalı.
| Token türü | Opus 5.5 | Opus 5 | İndirim |
|---|---|---|---|
| Önbelleksiz girdi | 4 dolar | 5 dolar | %20 |
| Çıktı | 20 dolar | 25 dolar | %20 |
| Önbellekten okuma | 0,20 dolar | 0,50 dolar | %60 |
Anthropic’in ayrıca açıkladığı iş yükü maliyetinde %40 düşüş iddiası, fiyatı ve token tüketimini birlikte değerlendiriyor. Her token’a %40 indirim veya her uygulama için garanti tasarruf anlamına gelmiyor. Duyuruda 2,5 kata kadar hız sunan hızlı modun fiyatı ise girdi için 8 / çıktı için 40 dolar olarak veriliyor.
Önbelleksiz 100.000 girdi ve 20.000 çıktı token’ı içeren basit bir istek bütçesi, standart tarifeyle 0,80 dolar tutuyor; Opus 5 karşılığı 1 dolar. Bu, eşit token tüketimi üzerinden yapılan hesap; araç ve diğer hizmet ücretlerini içermiyor, ölçülmüş bir agent iş yükü değil.
Lansmandaki dokuz benchmark’ın tamamı
Değerler Anthropic’in karşılaştırma tablosundan alındı. Grafikleri bu sayısal verilerden biz çizdik; bunlar bağımsız ölçümler değil. Büyütmek için herhangi bir grafiğe tıklayabilirsin.
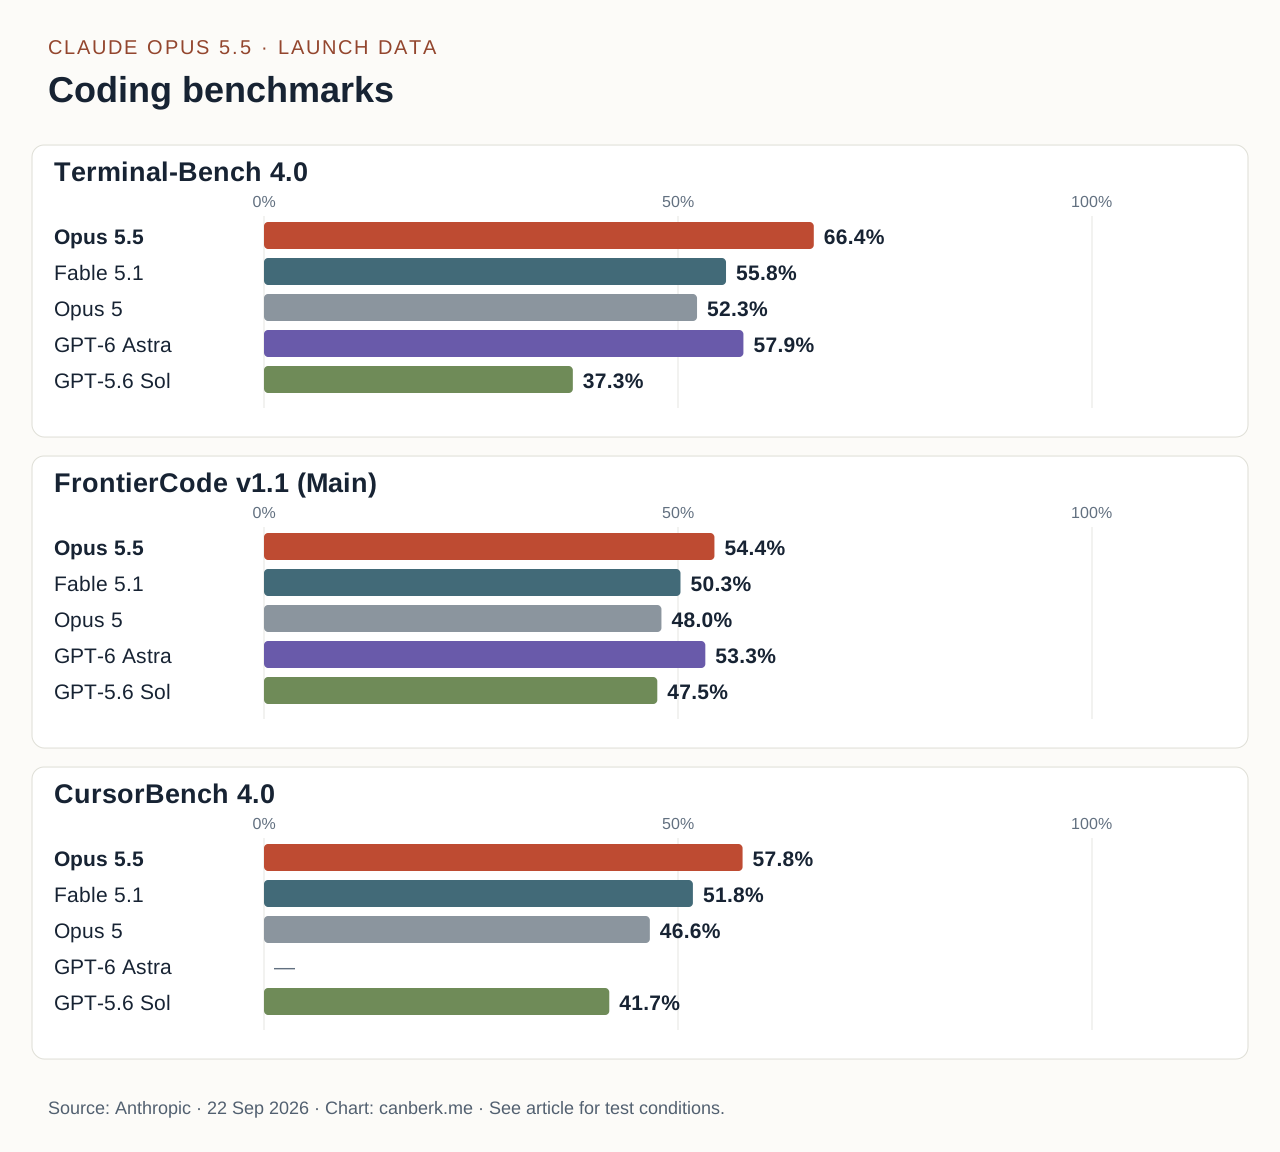
| Değerlendirme | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | %66,4 | %55,8 | %52,3 | %57,9 | %37,3 |
| FrontierCode v1.1 (Main) | %54,4 | %50,3 | %48,0 | %53,3 | %47,5 |
| CursorBench 4.0 | %57,8 | %51,8 | %46,6 | — | %41,7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | %40,0 | %31,4 | %26,9 | %41,4 | %28,8 |
| Humanity’s Last Exam (araçlarla) | %67,7 | %65,6 | %63,6 | %57,2 | — |
| Terminal-Bench-Science 0.1 | %58,7 | %52,6 | %29,0 | %64,6 | %22,4 |
| OSWorld 2.0 (kısmi) | %81,8 | %80,7 | %74,0 | — | — |
| Chartography (araçlarla) | %89,0 | %88,4 | %83,4 | — | — |
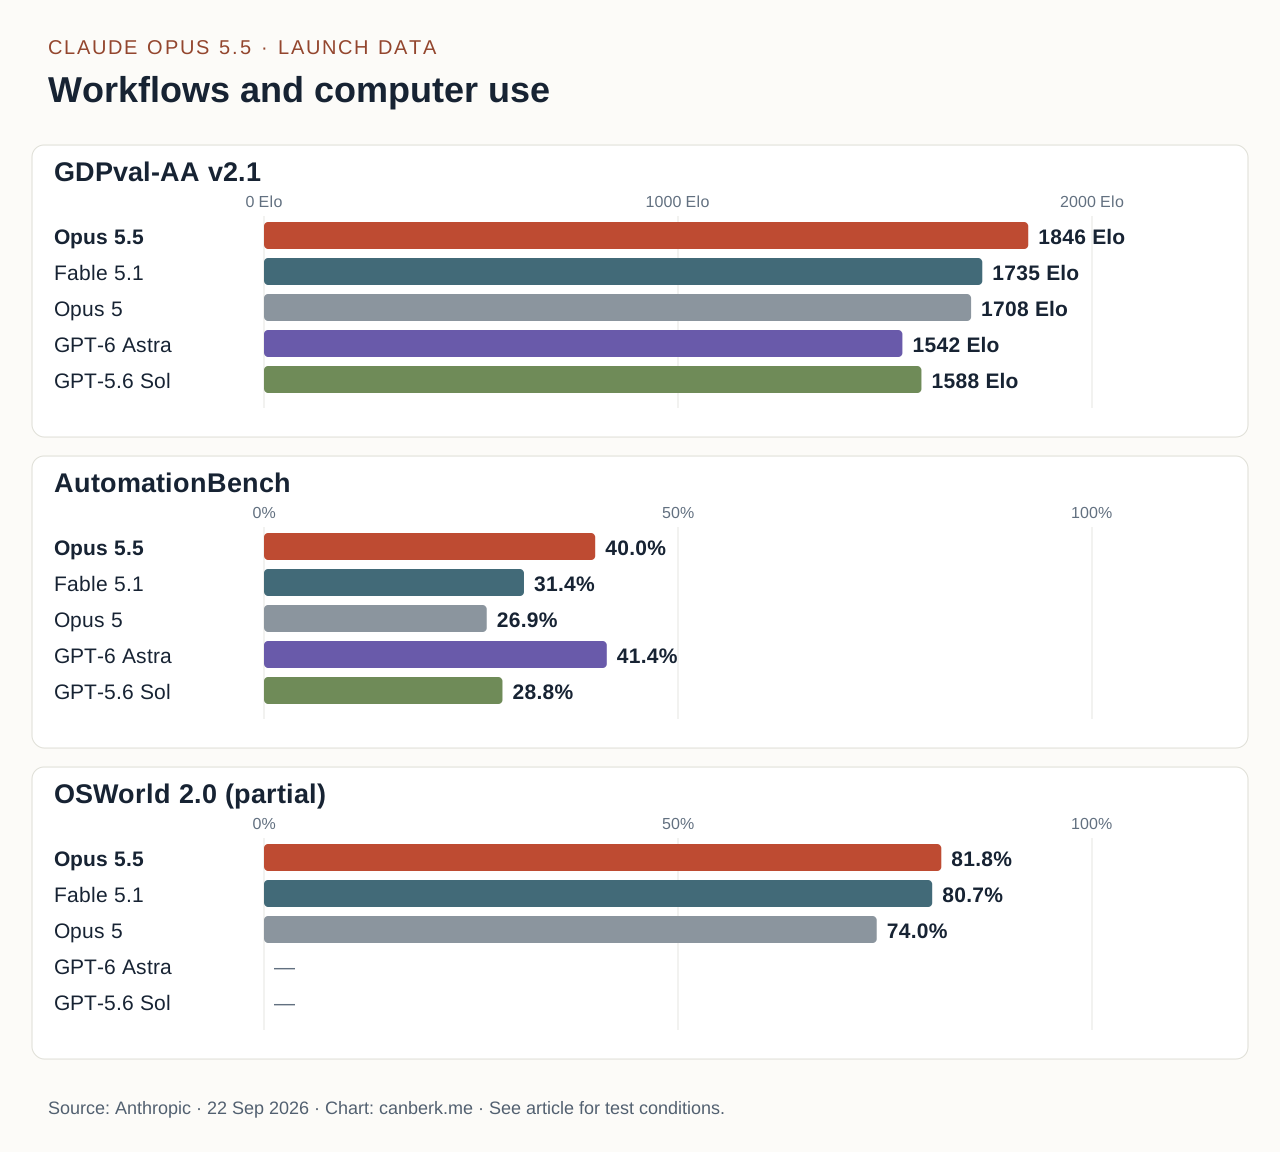
Tablo her alanda tek bir kazanan göstermiyor: AutomationBench ve Terminal-Bench-Science testlerinde GPT-6 Astra önde. Belirli bir iş için model seçerken bu istisnalar önemli.
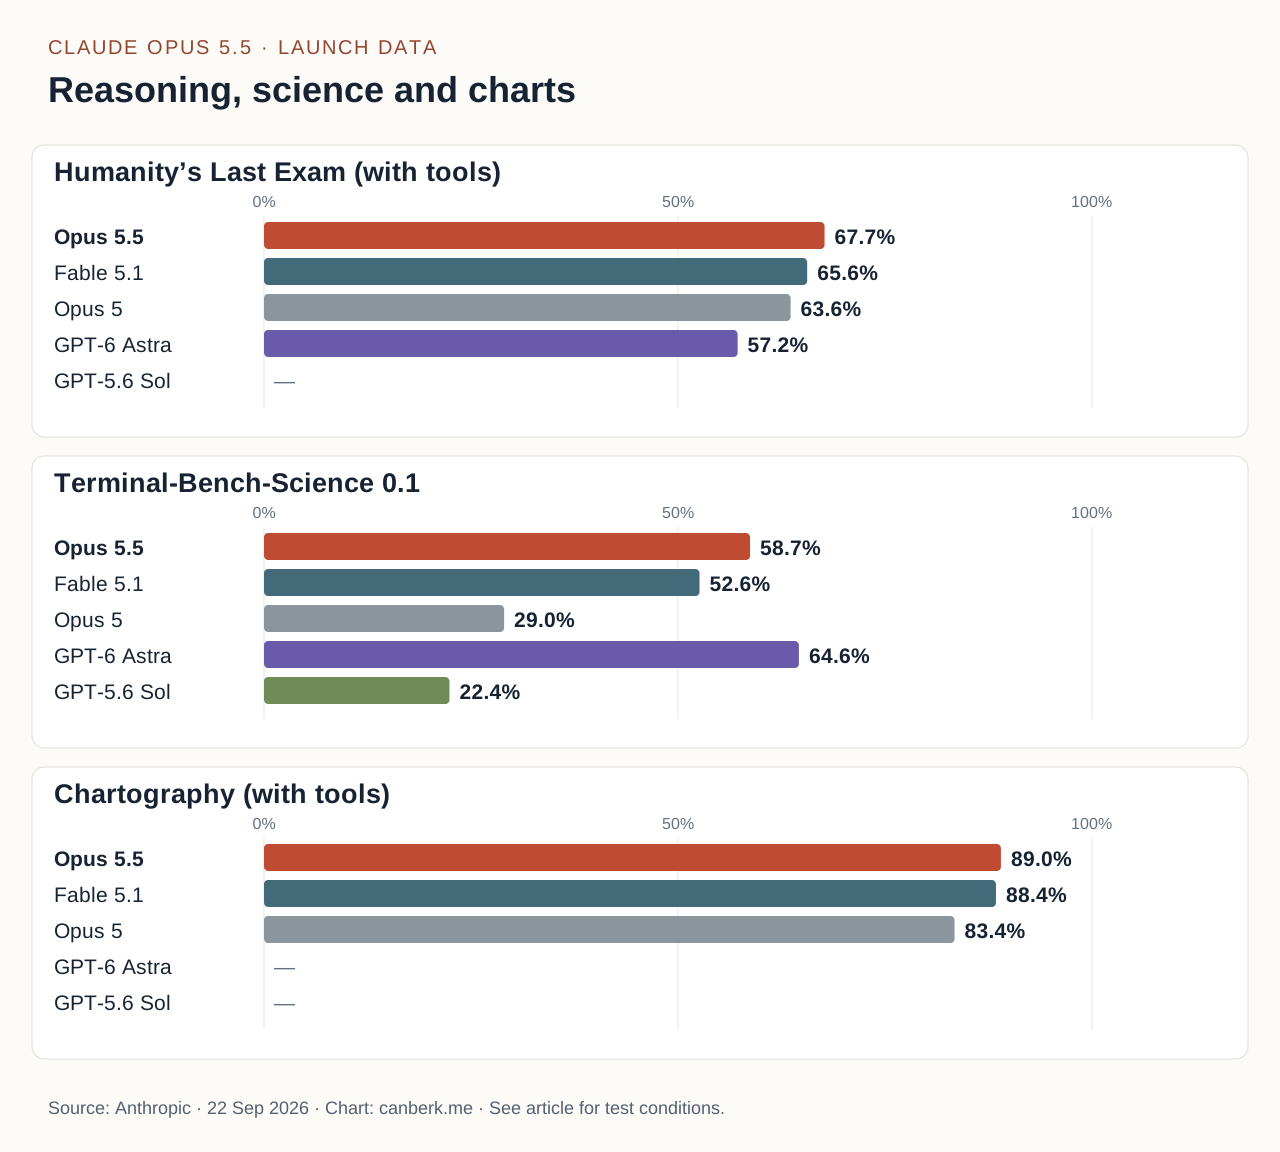
Koşullar önemli: listedeki Opus 5.5 sonuçlarının çoğu max, Terminal-Bench ise xhigh düşünme düzeyinde. Üretim güvenlik önlemleri bazı görevleri eski modellere yönlendirebiliyor. Zapier’in AutomationBench çalıştırmalarında ise güvenlik müdahaleleri başarısızlık sayılıyor. Dolayısıyla bunlar aynı varsayılan ayarlarda yapılmış birebir testler değil. Ayrıntılı yöntem ve belirsizlik notları kaynakta bulunuyor.
Model kimliğini değiştirmeden önce
Model dokümanı, claude-opus-5-5 kimliğini, 1 milyon token bağlamı, 128 bin token azami çıktıyı, metin/görsel girdiyi ve metin çıktısını listeliyor. Uyarlanabilir düşünme sürekli açık; varsayılan düşünme düzeyi medium.
Uyumluluk kontrolünde, hata döndüren zorunlu araç seçimine ve Claude API ile Google Cloud’da desteklenmeyen eski computer_20251124 aracına dikkat etmek gerekiyor. Düşünme blokları model ve konuşmaya bağlı. Bağlamı değiştiren veya önceki akıl yürütmeyi yeniden kullanan entegrasyonlar özellikle kontrol edilmeli.
Bir altyapı ekibi için ilk karşılaştırmayı, kabul ölçütleri belirli birkaç depo değişikliği ve olay analizi göreviyle yapardık. Başarılı sonuçları, tekrar denemeleri, gecikmeyi ve toplam harcamayı birlikte kaydetmek gerekir. Yüksek benchmark skoru yararlı bir veri; satın alma kararını belirleyecek olan, modelin kendi araçlarında yeniden iş yapma ihtiyacını azaltıp azaltmadığı.
Kaynaklar 22 Eylül 2026’da kontrol edildi. canberk.me modeli bağımsız olarak test etmedi. Kapak görseli Anthropic’e ait; üç veri grafiği bu içerik için hazırlandı.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder