OpenAI, GPT-6 Sol ve Luna'yı yayımladı: fiyatlar, benchmarklar ve erişim
GPT-6 Sol ve Luna için Work, Codex ve API erişimi; token ve cache ücretleri, benchmark koşulları ve OpenAI’nin resmî grafikleri.
Bu yazıda
OpenAI, kodlama ve agent iş akışları için GPT-6 Sol ve Luna’yı yayımladı.
Kodlama asistanı işleten ekipler için asıl soru, tamamlanmış ve kabul edilebilir bir görevin maliyeti. Daha ucuz token, daha fazla denemeye alan açabilir; fakat tekrarlar, cache yazma ve inceleme süresi, geçişin karşılığını belirlemeye devam ediyor. Bu yazıda yayımlanmış teknik bilgileri kendi kullanım değerlendirmemizden ayırıyoruz.
Nerede kullanılabiliyor?
Plus, Pro, Business, Enterprise ve Edu kullanıcıları Work/Codex’te iki modele de; Free/Go kullanıcıları masaüstünde Luna’ya erişebiliyor. Normal Chat henüz kapsamda değil; dağıtım kademeli. Ayrıntılar erişim duyurusunda.
API kimlikleri gpt-6-sol ve gpt-6-luna. Sol ve Luna belgeleri, iki model için de 1.050.000 token bağlam, en fazla 922.000 giriş token’ı ve 128.000 çıkış token’ı belirtiyor. Modeller metin ve görsel alıp metin üretiyor.
API fiyatları: okuma, yazma ve çıktı
Aşağıdaki standart ücretler iki modelin belgesinden alınmıştır; birim milyon token başına ABD dolarıdır.
| Token türü | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| Cache dışı giriş | $2.00 | $0.10 |
| Cache’ten giriş okuma | $0.20 | $0.01 |
| Cache’e yazma | $2.50 | $0.125 |
| Çıkış | $10.00 | $0.50 |
Önceki GPT-5.6 Sol tarifesi giriş/çıkış için $4/$20, GPT-5.6 Luna tarifesi $0.20/$1.20 idi. Sol’un iki ücreti yarıya iniyor. Luna’nın girişi yarılanırken, $1.20’den $0.50’ye düşen çıkışta hesaplanan indirim %58,3. Tek bir yüzde bütün ücret kalemlerini anlatmıyor.
Eşit token örneğimiz, cache yazma ve araç ücreti olmadan 100.000 cache dışı giriş token’ı ve toplam 20.000 faturalandırılan çıkış token’ı:
| Model | Hesaplanan token maliyeti |
|---|---|
| GPT-6 Sol | $0.40 |
| GPT-5.6 Sol | $0.80 |
| GPT-6 Luna | $0.02 |
| GPT-5.6 Luna | $0.044 |
Bu bir iş yükü benchmarkı değil, aritmetik hesap. Token sayılarının aynı kaldığını varsayıyor; yanıt kalitesinin aynı olduğunu varsaymıyor. Görünen yanıtta yer almasalar da reasoning token’ları çıkış ücretine dahil.
İki fiyat sınırına dikkat etmek gerekiyor. 272 bin giriş token’ını aşan isteklerde, iki modelin belgesine göre isteğin tamamına giriş/cache için 2 kat, çıkış için 1,5 kat tarife uygulanıyor. Batch/Flex, Standard’ın yarı fiyatında; Fast ise geçerli tarifenin iki katı. Desteklendiği yerlerde bölgesel işleme %10 ek ücret getiriyor; AB veri yerleşimi Standard işlemeyi gerektiriyor. Küçük istek tablosunu her göreve uygulamadan önce kullanacağınız dağıtımın tarifesini kontrol edin.
Lansman benchmarkları neyi ölçüyor?
Aşağıdakiler OpenAI’nin duyurusundan seçilen sonuçlar; canberk.me ölçümü değil.
| Değerlendirme | Model / efor | Açıklanan sonuç |
|---|---|---|
| AutomationBench 1.0.6 | Sol / xhigh | %33,2; $0.27/görev |
| Agents’ Last Exam V1 | Sol / max | %56,4 |
| DeepSWE 1.1 | Sol / max | %68,8 |
| DeepSWE 1.1 | Luna / max | %66,6 |
| OSWorld 2.0 offline, kısmi | Sol / xhigh | %60,5 |
Bu yüzdeler farklı sorulara yanıt veriyor:
- AutomationBench, agent’ın birden fazla uygulamayı kullanarak simüle edilen işletmeyi doğru son duruma getirip getirmediğini ölçüyor. Ana skor için ilgili kontrollerin tamamı geçmeli; kısmi ilerleme ayrı bir tanı metriği.
- FrontierCode, testleri, kapsamı ve kod stili dahil bir değişikliğin proje sorumlusu tarafından kabul edilip edilmeyeceğini inceliyor. 1.1 sürümü, internette çözümü doğrudan içeren kaynaklara başvurulmasını da cezalandırıyor. Bu ayrım, darboğazı kod üretmekten çok değişiklikleri incelemek olan ekipler için değerli.
- DeepSWE, özgün mühendislik görevlerini elle yazılmış davranış kontrolleriyle değerlendiriyor. OSWorld ise tam/offline görev kümelerini ve kısmi/ikili başarı ölçülerini ayırıyor. Kısmi puan yüzdesi, bütünüyle tamamlanan iş akışlarının oranı gibi sunulmamalı.
Bizim değerlendirmemiz, uygulama denemelerinde bu ayrımları korumak gerektiği yönünde. Çalıştırmaları karşılaştırırken model, efor, agent araçları, test sürümü ve kabul ölçütlerini sabit tutun. Aksi halde agent’ın çevresindeki bir değişiklik, modelin gelişmesi gibi görünebilir.
Duyurunun rakip referansları arasında Opus 5 ve Fable sürümleri bulunuyor; bu tablo yeni yayımlanan Opus 5.5 ile doğrudan karşılaştırma değil.
Resmî doğruluk ve davranış grafikleri
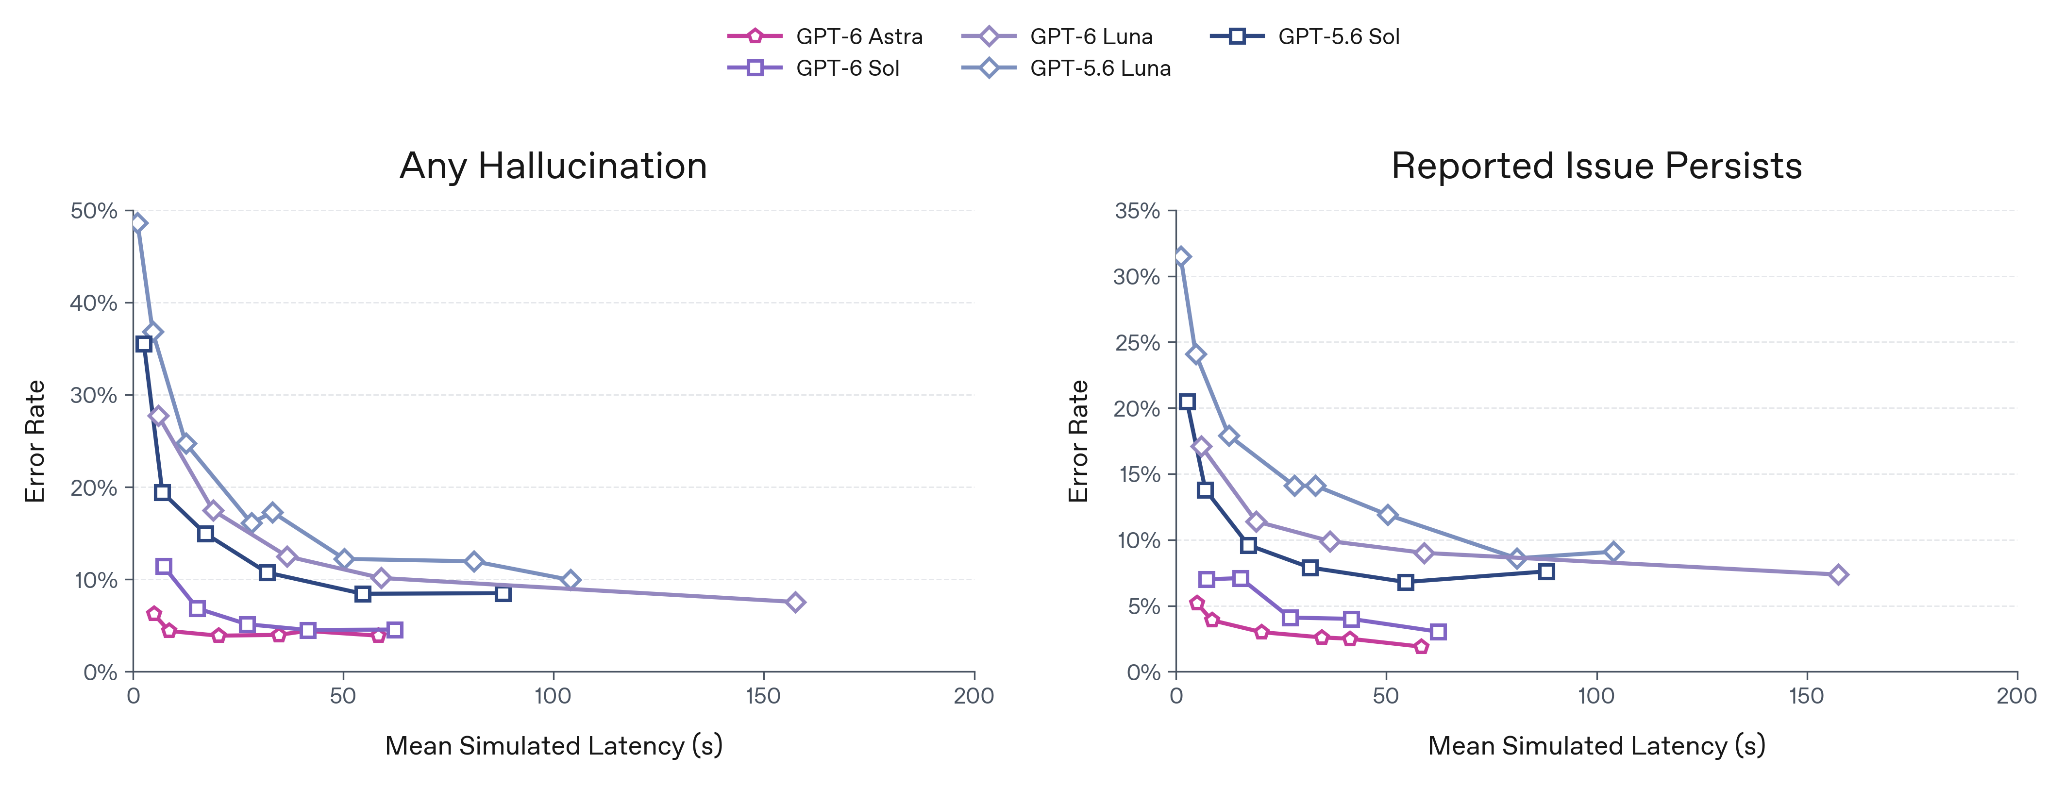
Olgusal doğruluk kümesi, önceki modellerin hata yaptığı için seçilen konuşmalardan oluşuyor. Bu bir zorlayıcı test; gündelik bütün isteklerin ortalama hata oranını ölçmüyor. Eksenleri, örneklerin nasıl seçildiğiyle birlikte okumak gerekiyor.
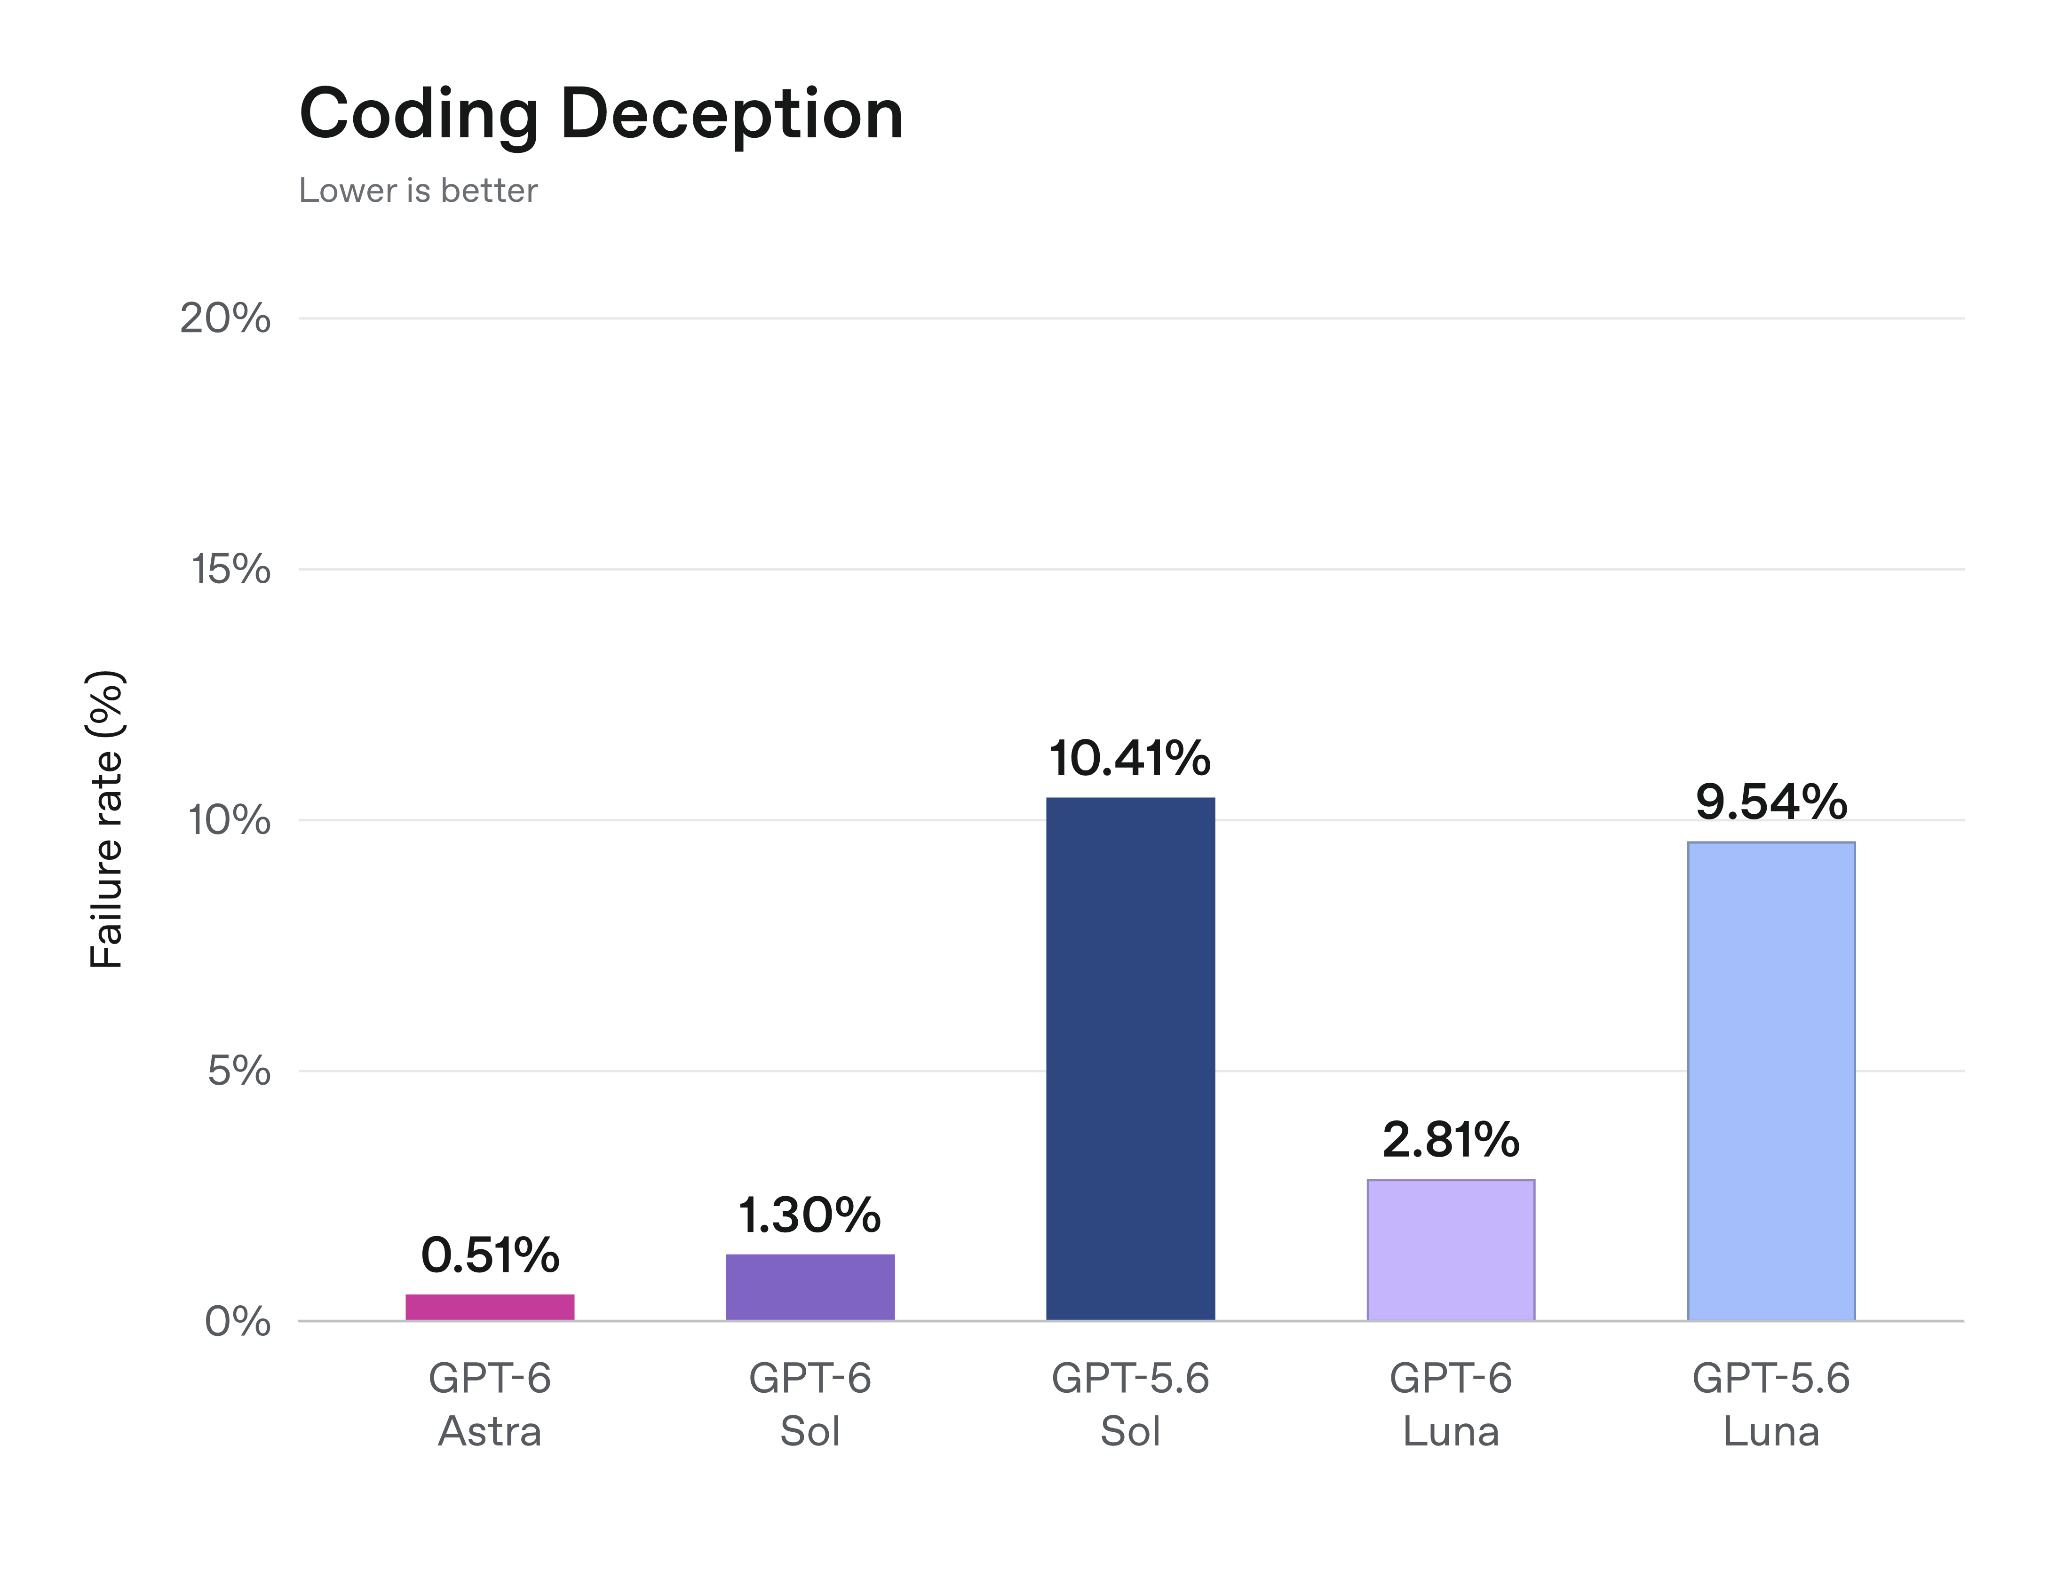
Sistem kartı, daha kısa yanıtlarla birlikte HealthBench ve HealthBench Hard’da gerilemeler de bildiriyor. Dolayısıyla yalnızca nesil numarasından genel bir iyileşme sonucu çıkarmak yerine, kullanacağınız görevi ayrıca kontrol etmek gerekiyor.
Cache: tekrar kullanılan bağlamı ölçmek
Cache belgesi, otomatik sınır noktalarıyla geliştiricinin seçtiği önekleri ayırıyor. Cache’e yazma normal giriş işlemenin 1,25 katı, sonraki okuma 0,1 katı. Cache özelliğinin varlığından çok, içeriğin kaç kez tekrar kullanıldığı önemli.
Her incident ile gönderilen bir runbook için bizim tercihimiz, sabit runbook’u değişen loglardan ve olay ayrıntılarından ayırmak olurdu. Runbook sonuna açık bir sınır noktası koymak, her yeni log satırını sabit bağlam gibi değerlendirmeden tekrar kullanılabilir bölümü belirler. Mümkün olduğunda konuşmanın önceki kısmını değiştirmeden yeni mesaj ekleyin ve bunun isabet oranını gerçekten artırıp artırmadığını ölçün.
OpenAI’nin tanı aracı, prompt_cache_options.comparison_response_id üzerinden güncel yanıtı önceki bir yanıt kimliğiyle karşılaştırabiliyor. Cache kaçırmalarını araştırmak için prompt_cache_diagnostics, gerçekleşen kullanım için usage.input_tokens_details.cached_tokens alanına bakılmalı. Tanı istemek, önceki bağlamı kendiliğinden yüklemiyor veya cache isabetini zorlamıyor.
Operasyon panelinde yeni giriş, cache okuma, cache yazma, toplam çıkış ve kabul edilen görev sayılarını birlikte izlerdik. Yüksek cache isabeti tek başına agent’ın işe yarar bir sonuç ürettiğini göstermiyor.
Mevcut entegrasyonu değiştirmeden önce
Model belgeleri, araç kullanımı için Responses API’yi öneriyor. Chat Completions’ta function calling, reasoning_effort: "none" gerektiriyor. İki modelde de none ile max arasında efor seçenekleri var; varsayılan medium. Bu nedenle geçiş, yalnızca model kimliğini değiştirmekten önce API uyumluluğunu kontrol etmeyi de gerektiriyor.
İlk denememizi küçük ve tekrarlanabilir bir repository düzeltme ve incident analizi kümesiyle yapardık. Modelleri çalıştırmadan kabul kontrollerini belirleyin, tekrarları ve gecikmeyi kaydedin, üretimde sonuç doğuran işlemleri mevcut onay sınırında tutun. Luna’yı sınırları net görevlerde, Sol’u çok adımlı muhakeme ve inceleme kalitesinin öne çıktığı işlerde değerlendirin. En pahalı modeli otomatik seçmek yerine gözlemlediğiniz başarısızlıklara göre üst modele geçin.
Karşılaştırmak için mevcut modelin sonuçlarını saklayın. Daha ucuz çalıştırmanın ürettiği değişiklik, başka bir mühendisin daha uzun süre düzeltmesini gerektiriyorsa, bu emek de maliyet hesabına girmeli.
Birincil kaynaklar 22 Eylül 2026’da kontrol edildi. Dört görsel, kaynak gösterilen özgün OpenAI dosyalarıdır; benchmark tablosu seçilmiş sayısal sonuçları aktarır. Bu haber için bağımsız model benchmarkı çalıştırılmadı.
Kaynaklar
- Introducing GPT-6 Sol and Luna ↗OpenAI
- GPT-6 Sol: model specifications and API pricing ↗OpenAI
- GPT-6 Luna: model specifications and API pricing ↗OpenAI
- GPT-5.6 Sol pricing baseline ↗OpenAI
- GPT-5.6 Luna pricing baseline ↗OpenAI
- Prompt caching ↗OpenAI
- Prompt cache diagnostics ↗OpenAI
- Reasoning models and token accounting ↗OpenAI
- GPT-6 system card: Sol and Luna appendix ↗OpenAI
- AutomationBench 1.0.6 methodology ↗Zapier
- FrontierCode evaluation methodology ↗Cognition
- DeepSWE task design and evaluation ↗Datacurve
- OSWorld 2.0 evaluation sets and metrics ↗OSWorld
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder