Claude Sonnet 5.5 yayımlandı: aynı API fiyatı, daha hızlı çıktı
Anthropic’in yeni Sonnet modeli platformlarda kullanıma açıldı. API fiyatları, yayımlanan değerlendirmeler, güvenlik önlemleri ve geçişte dikkat edilecek bir ayar.
Bu yazıda
Anthropic, Claude Sonnet 5.5’i 28 Eylül 2026’da duyurdu. Opus 5.5’ten altı gün sonra gelen model, 5.5 ailesinin ikinci üyesi. Şirket, Sonnet’i günlük ajan işleri, hata düzeltme ve özenli belge, slayt ve tablo üretimi için; Opus’u ise uzun süreli muhakeme gerektiren açık uçlu işler için konumlandırıyor. Bu, Opus 5.5 duyurusundan ayrı bir model sürümü.
Buradaki temel ayrım token birim fiyatı ile tamamlanan görevin maliyeti arasında. Anthropic birim tarifeyi sabit tutarken hız, token verimliliği ve çeşitli değerlendirmelerde ilerleme bildirdi. Aşağıdaki sayılar duyurudan ve 148 sayfalık sistem kartından geliyor; canberk.me’nin bağımsız ölçümü değiller.
Erişim, fiyat ve efor düzeyi
Anthropic’e göre Sonnet 5.5 kendi platformlarında, Amazon Web Services, Google Cloud ve Microsoft Azure üzerinden kullanıma açık. Claude Platform model kimliği claude-sonnet-5-5. Standart API tarifesi Sonnet 5 ile aynı: milyon girdi token’ı başına 2 dolar, milyon çıktı token’ı başına 10 dolar, milyon önbellekten okuma token’ı başına 0,20 dolar ve milyon önbelleğe yazma token’ı başına 2,50 dolar. Duyuru sıfır veri saklama seçeneğinin de bulunduğunu belirtiyor.
Şirket, çıktının Sonnet 5’e göre %30’dan fazla hızlı üretildiğini ve kendi testlerinde daha az token kullanıldığı için görev başına maliyetin %30’a kadar düştüğünü söylüyor. Aynı sayıda token harcayan bir istek yine aynı Sonnet tarifesine tabi. Gerçek maliyeti iş yükü, efor ayarı, önbellek isabeti, araç çağrıları ve yeniden denemeler belirler; duyuru her uygulamada %30 tasarruf vaat etmiyor.
Efor ayarı karşılaştırmayı doğrudan etkiliyor. Anthropic, Claude Code ve uygulamalarında Medium, Claude Platform’da High varsayılanını kullanıyor. Düşük düzey daha hızlı ve ucuz olabilir; yüksek düzey modele daha uzun düşünme ve kontrol olanağı verir. Modelleri farklı efor veya görev koşullarında tek bir sıralamaya koymak yanıltıcıdır.
Yayımlanan benchmark sonuçları
Anthropic’in lansman tablosu şu sonuçları veriyor. Yüzdeler görev puanı; GDPval-AA ve AA-Briefcase Elo türü puan kullanıyor. Aynı satırda yüksek sayı daha iyi, fakat satırlar farklı beceri ve koşulları ölçüyor.
| Değerlendirme | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | %70,6 | %10,3 | %66,4 |
| FrontierCode 1.1 Main | Max’te %46,2; Xhigh’da %52,1 | %42,4 | %54,4 |
| CursorBench 4.0 | %55,5 | %34,1 | %57,8 |
| GDPval-AA v2.1, Elo | 1844 | 1449 | 1846 |
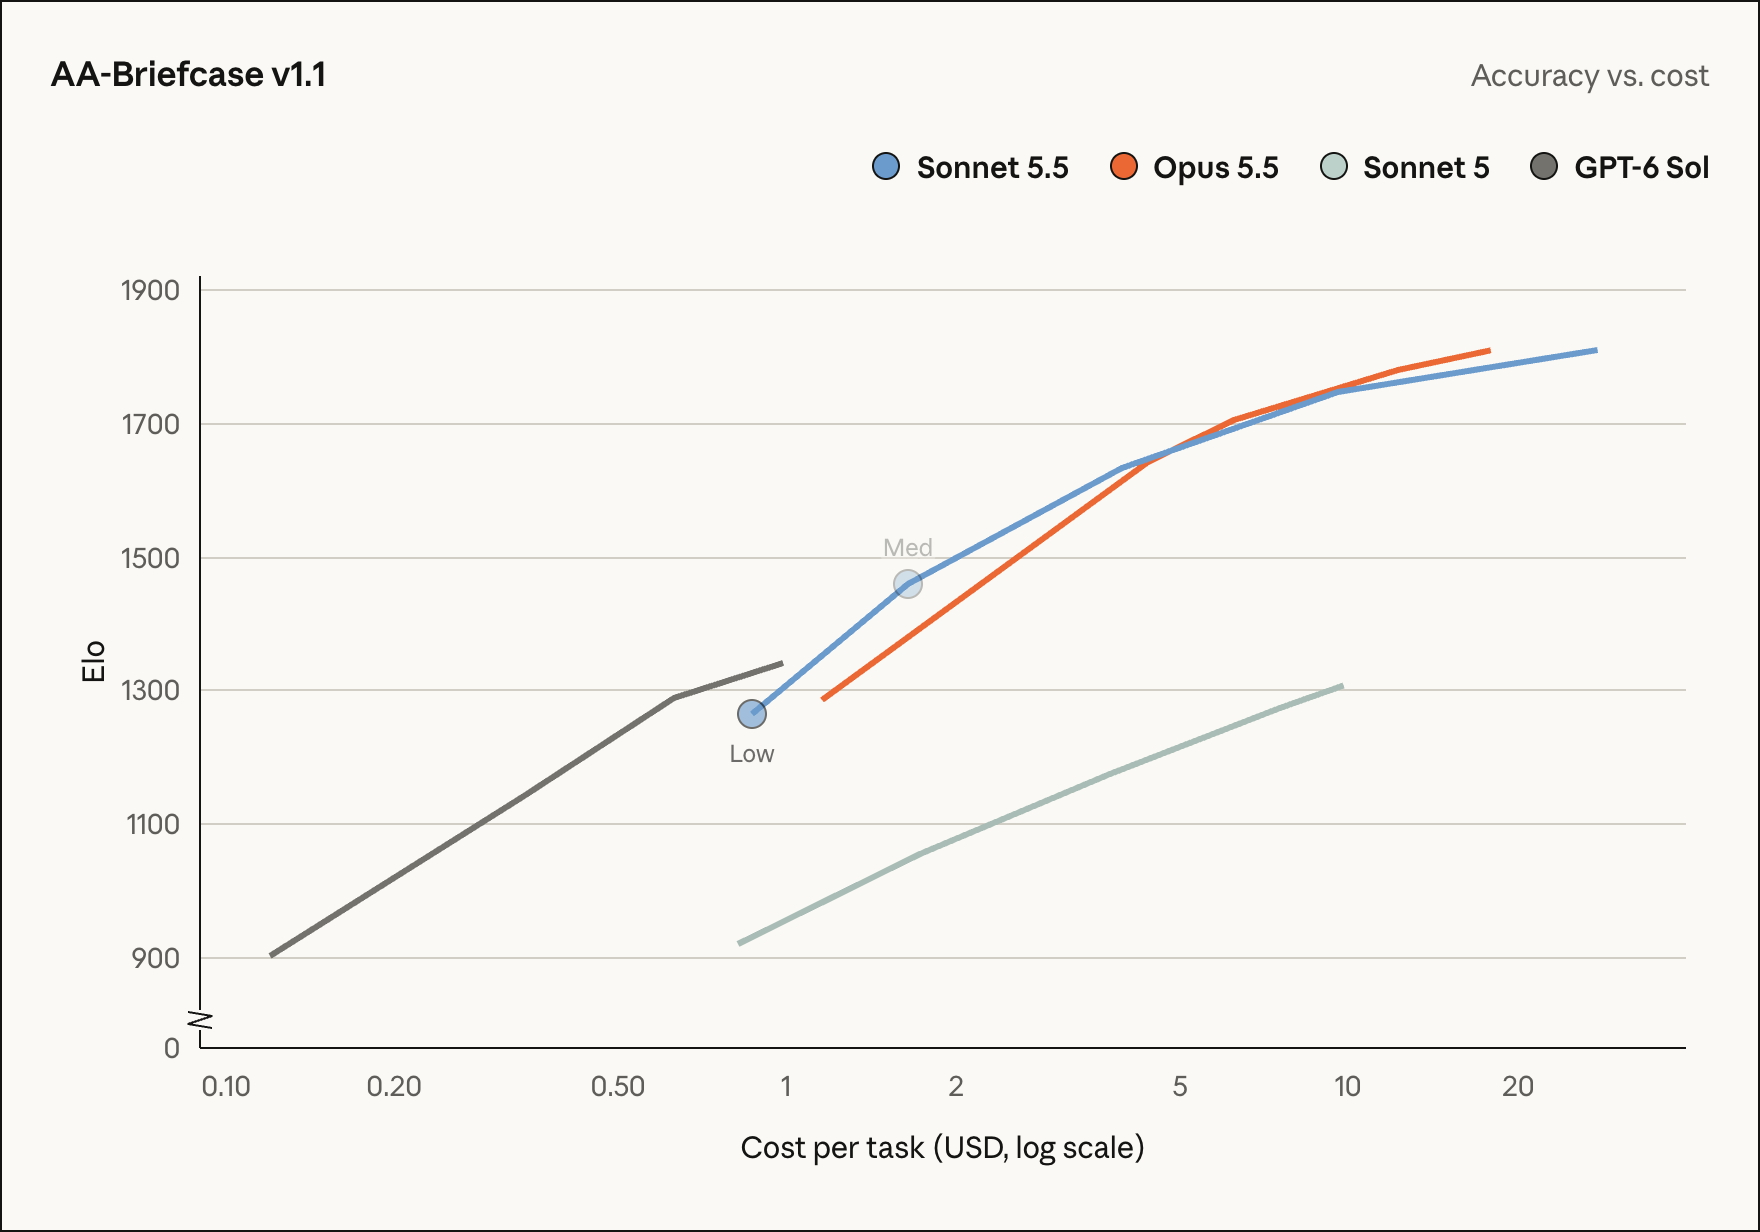
| AA-Briefcase v1.1, Elo | 1811 | 1359 | 1822 |
| Humanity’s Last Exam, araçlarla | %64,5 | %54,9 | %67,7 |
| OSWorld 2.1 | %80,1, kısmi | %57,0, kısmi | %81,8, kısmi |
| Chartography, araçsız | %61,6 | %15,6 | %64,4 |
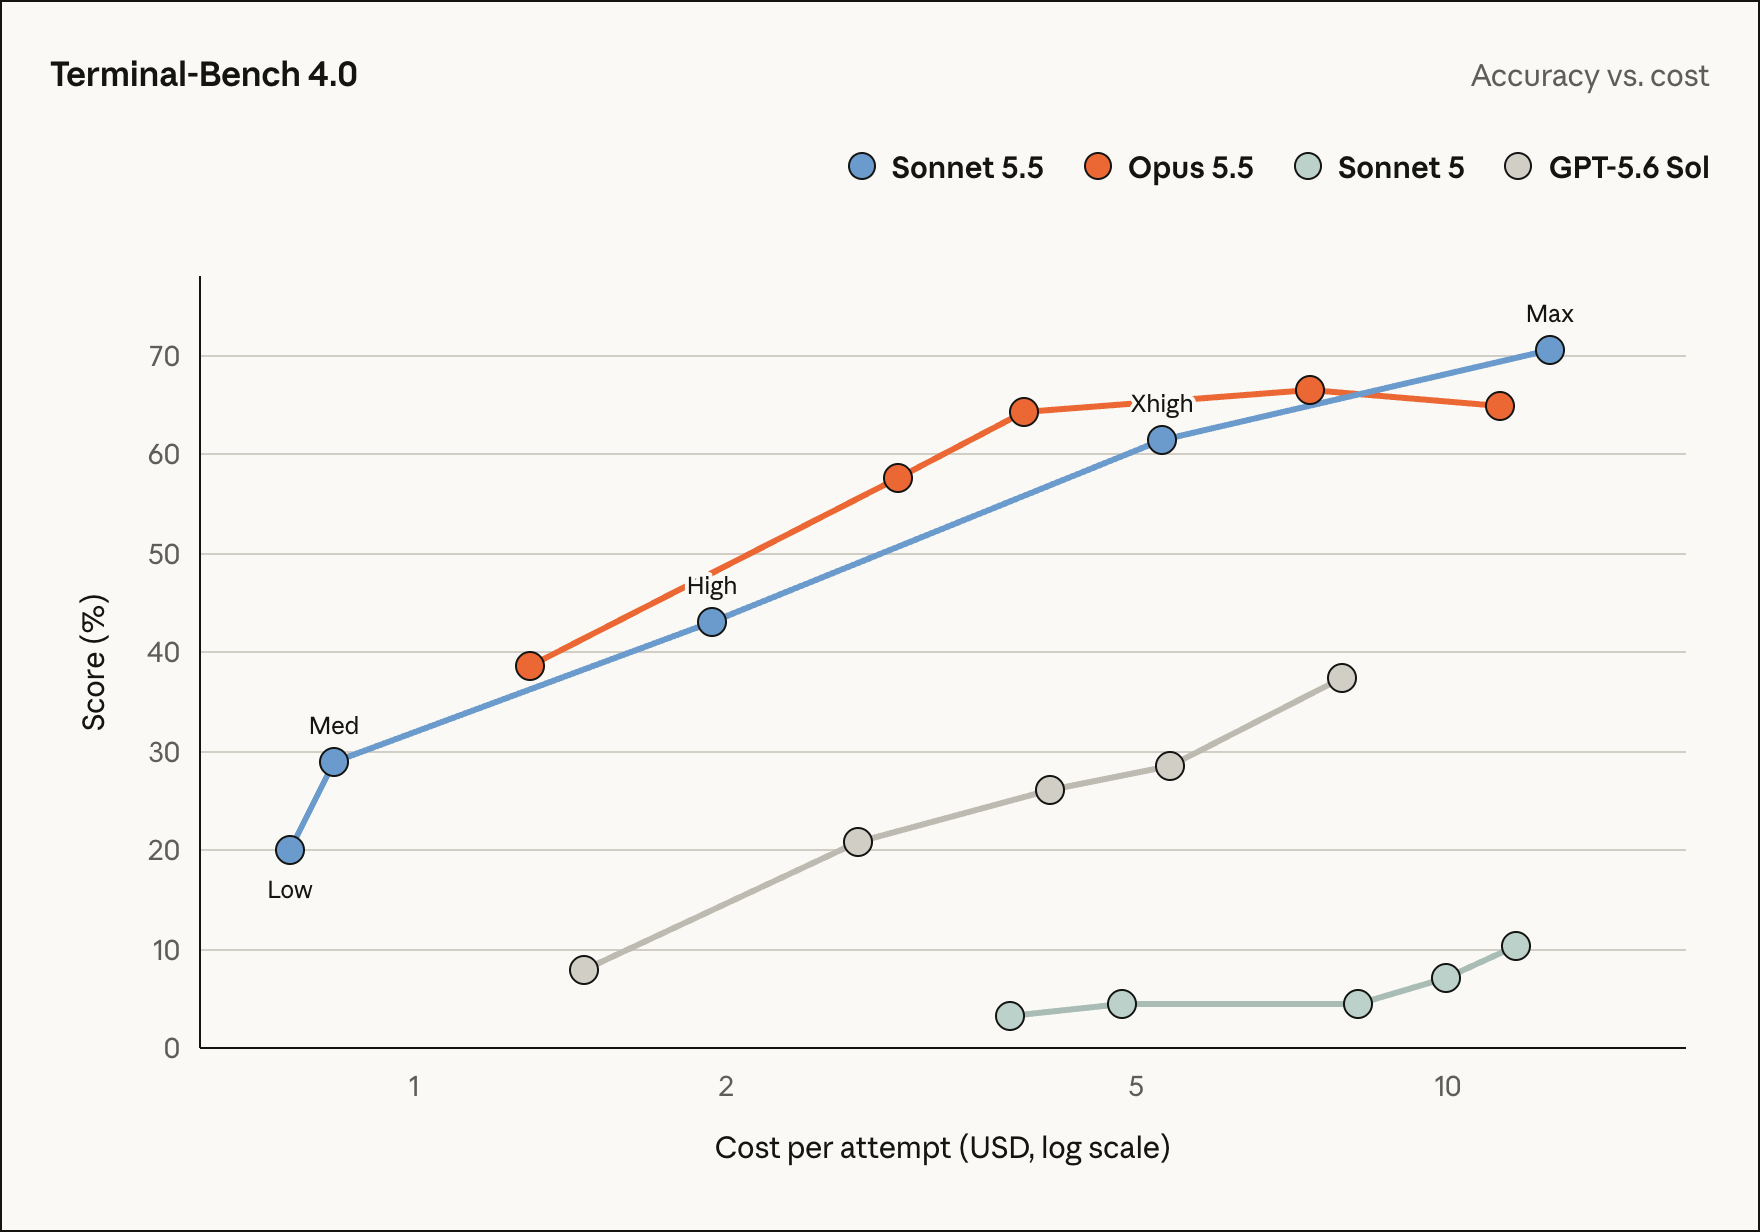
En çarpıcı sıçrama Terminal-Bench 4.0’da: %10,3’ten %70,6’ya. Sistem kartı, testin yalıtılmış terminal ortamında 66 görev içerdiğini ve Sonnet 5.5 için görev başına beş deneme yapıldığını anlatıyor. Sonnet’in %70,6 sonucu Max, karşılaştırılan Opus 5.5’in %66,4 sonucu ise Xhigh eforunda. Anthropic sırasıyla yaklaşık 2,5 ve 2,6 yüzde puanlık standart hata bildiriyor; bu küçük fark genel bir üstünlüğü kanıtlamıyor. İnternet erişimi kapalıydı, gerekli kaynaklar önceden önbelleğe alındı. Koruma ve sunucu tarafı geri dönüş açıktı; geri dönüş Sonnet isteklerinin %1,2’sini, denemelerin %1,5’ini etkiledi.
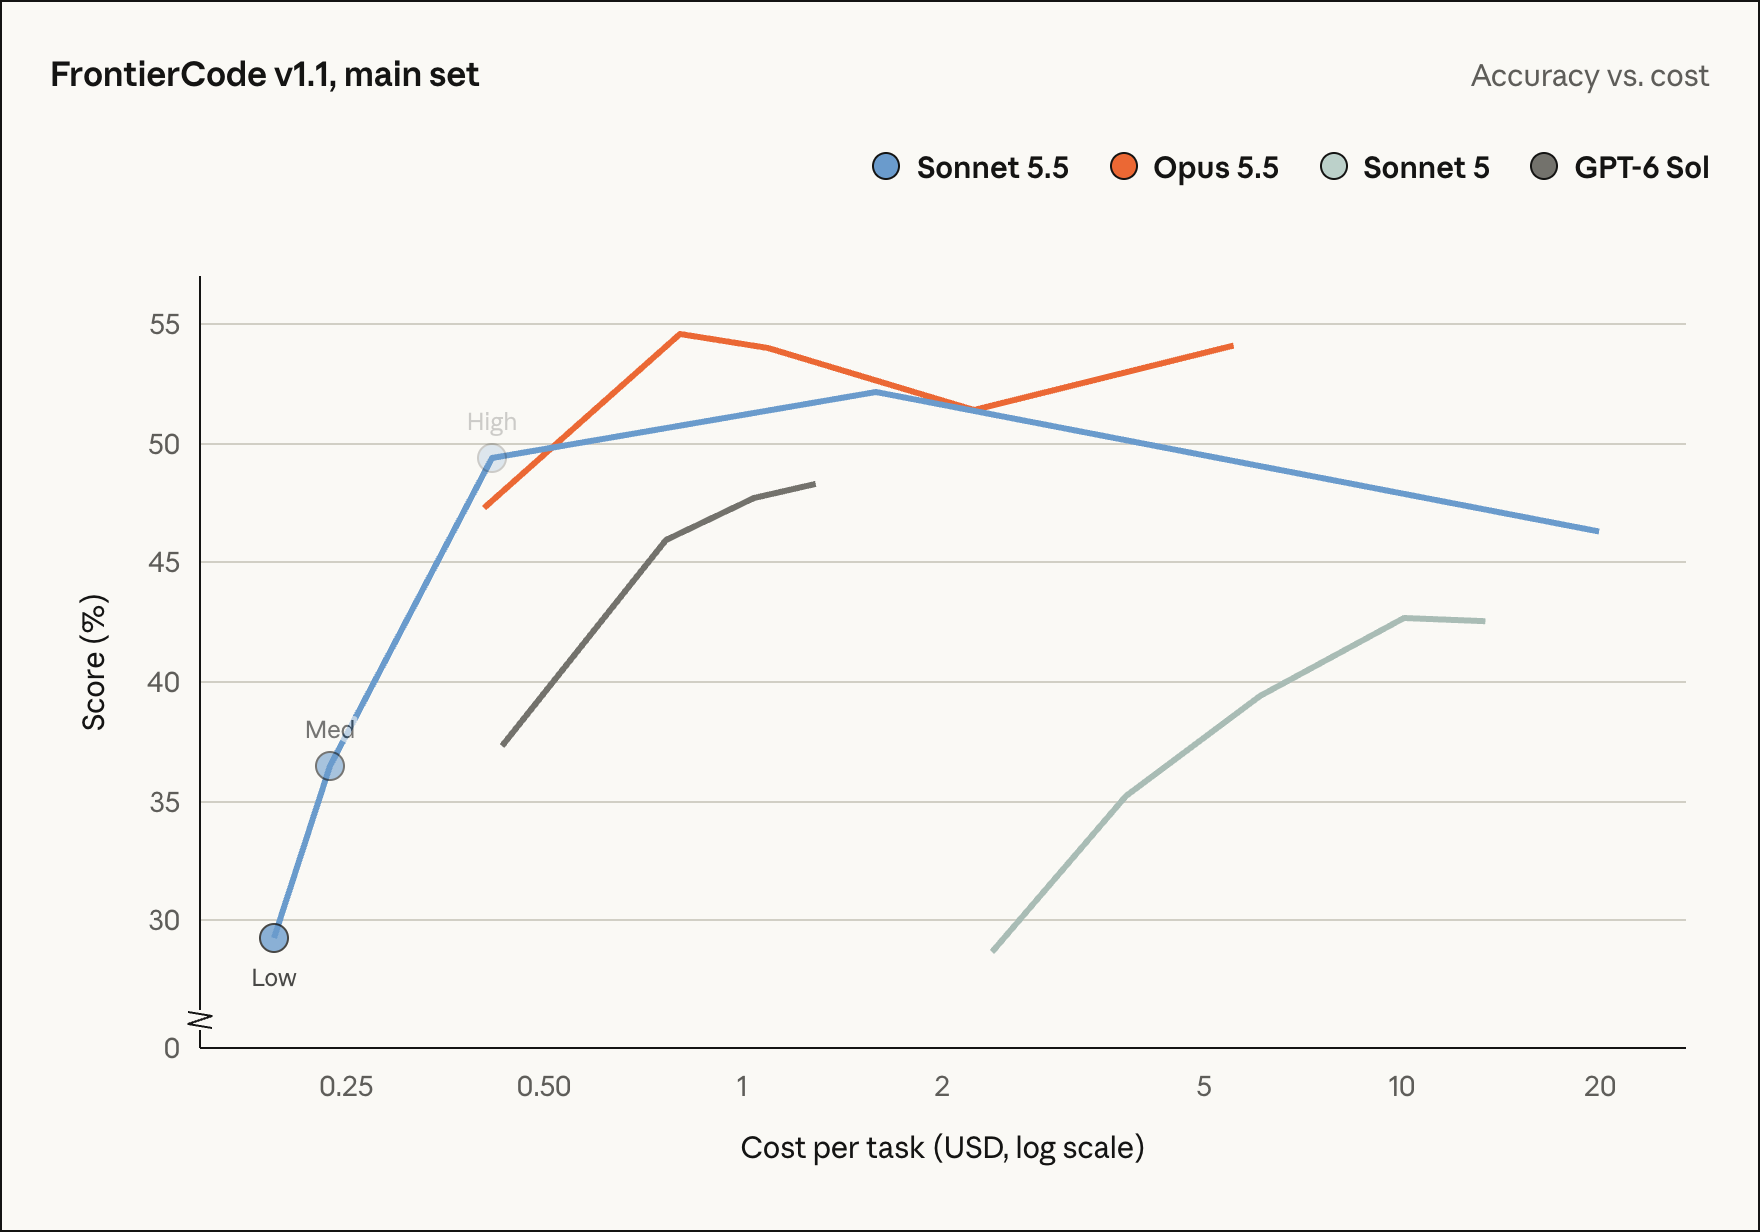
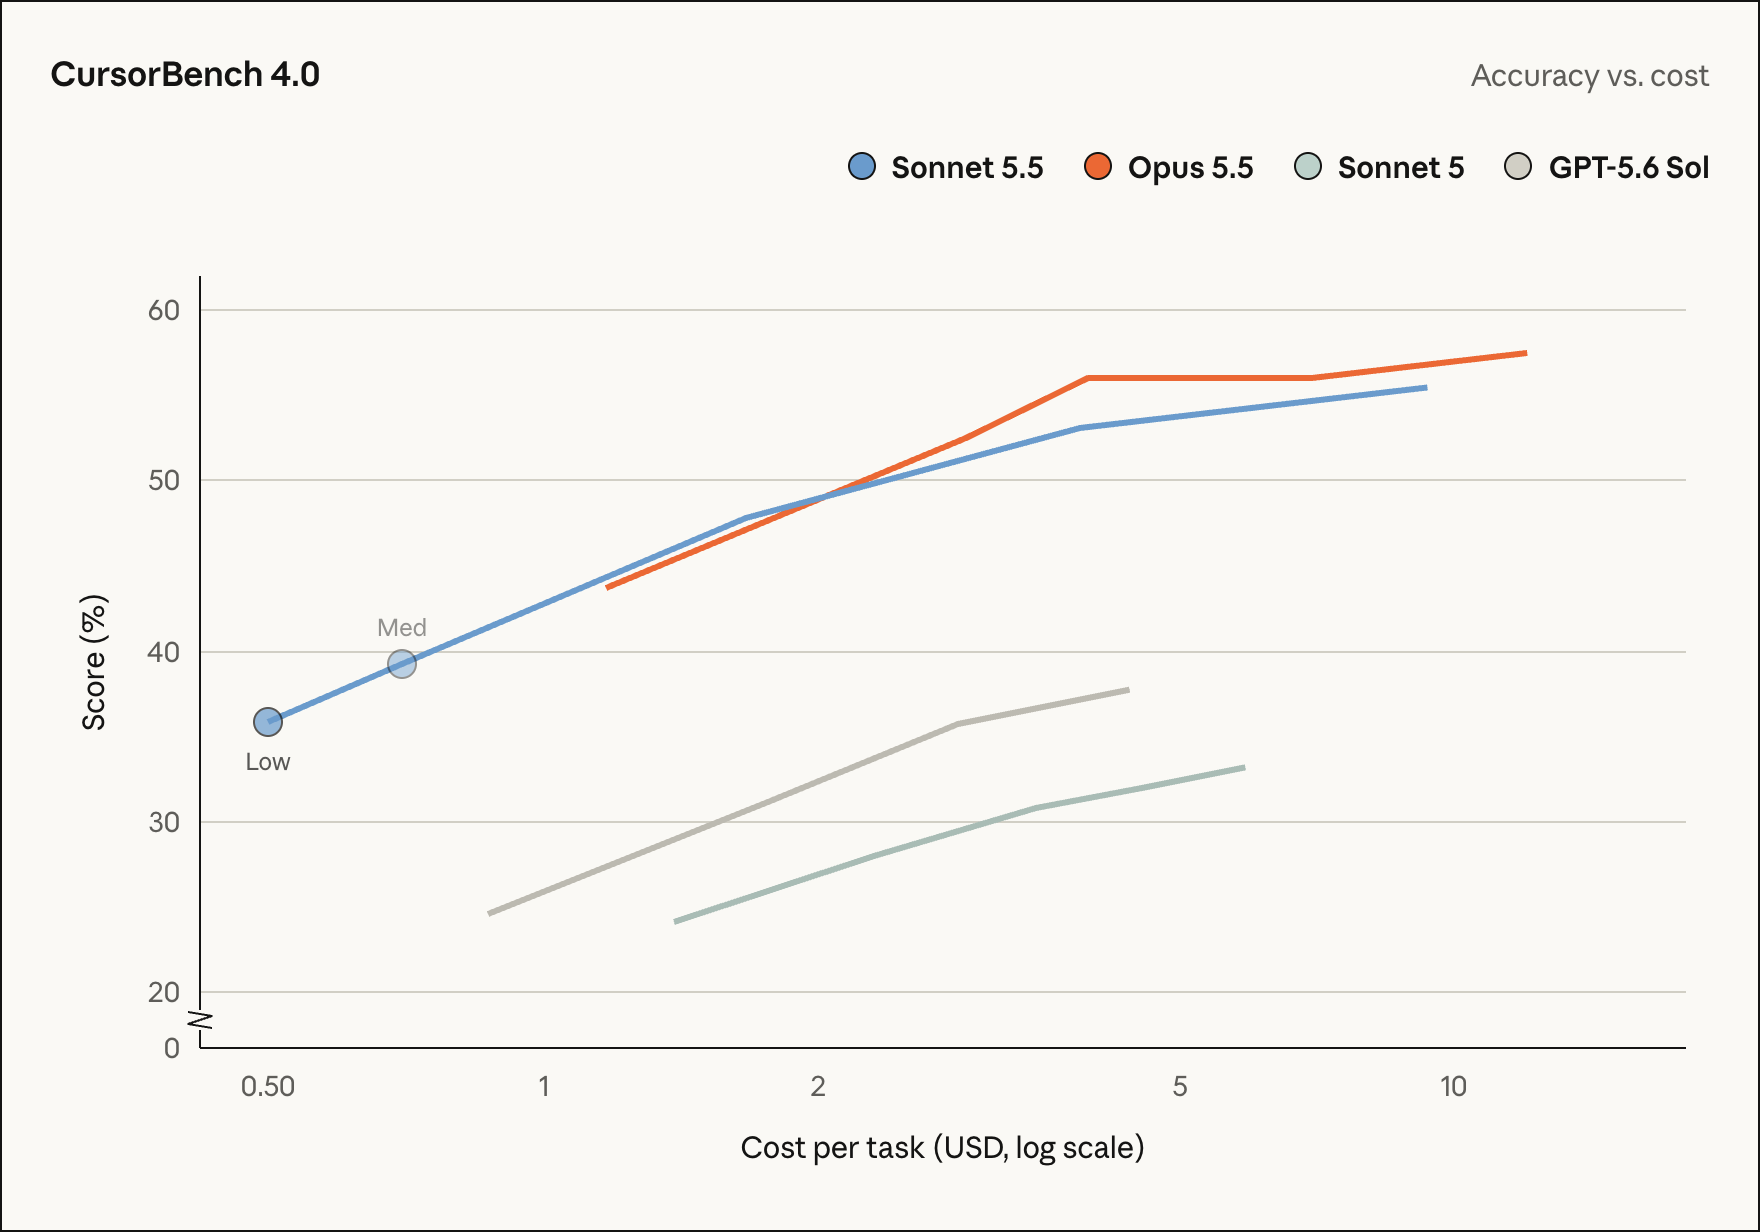
FrontierCode, bir kod değişikliğinin insan düzeltmesi olmadan birleştirilip birleştirilemeyeceğine bakıyor. Sonnet 5.5’in sonucu Xhigh’da %52,1, Max’te %46,2. Şirketin dipnotu, incelenen iki olayda ek kod incelemesinin süre aşımına veya kapsam dışı değişikliklere yol açtığını söylüyor. CursorBench’in Max eforundaki %55,5 puanı ise Cursor’ın üretim ajan düzeninde bağımsız olarak çalıştırıp ölçtüğü görevlerden geliyor; Anthropic, Sonnet 5.5’in görev maliyetini Cursor’ın token sayısından liste fiyatıyla tahmin etti. Grafiklerde puan ile maliyetin kaynağı bu yüzden aynı değil.
Bilgi işlerinde Sonnet’in GDPval-AA puanı 1844, Opus’unki 1846. Artificial Analysis bu testi ve AA-Briefcase’i, Anthropic’in yapılandırılmış çıktıları etkileyebilen bir hata bulunduğunu söylediği yayın öncesi sürümde çalıştırdı. Şirket etkinin küçük olmasını bekliyor; burada kesin etkisi ölçülmüş değil. Anthropic ayrıca karmaşık, açık uçlu işlerde Opus 5.5’in daha güçlü olduğunu belirtiyor. Tek testteki yakınlık genel eşdeğerlik anlamına gelmez.
Özgün başarı–maliyet grafikleri
Aşağıdaki görseller, duyurudaki dört etkileşimli grafik panelinin değiştirilmemiş ekran görüntüleri. Yatay eksen deneme veya görev başına tahmini doları logaritmik ölçekte, dikey eksen başarıyı gösteriyor. Her nokta bir efor düzeyi. Yukarıda ve solda kalan nokta, ilgili test varsayımları altında daha yüksek puanı daha düşük maliyetle veriyor. Paneller arasında hareket etmek ve tam açıklamaları okumak için özgün sayfayı açın. Bu görseller canlı grafik veya bağımsız test değil, kaynak sayfanın anlık görünümleri.
Anthropic, üç hareketli yan yana kodlama demosu da sunuyor: 400 sığırcığın sürü hareketi, kum tepeleri ve saatlerden oluşan bir saat. Bunlar şirketin seçtiği istemlerde iki modelin nasıl ilerlediğini gösteren görsel örnekler; kontrollü gecikme testi veya her istemde hız üstünlüğünün kanıtı değiller.
Güvenlik kartı ve geçişte dikkat edilecekler
Sistem kartı, Sonnet 5.5’in Sorumlu Ölçeklendirme Politikası değerlendirmelerinde genel olarak Opus 5.5’in altında kaldığını ve yeni bir eşiği aşmadığını bildiriyor. Siber yeteneklerin Sonnet 5’e göre artması nedeniyle Opus 5.5’e benzer üç aşamalı koruma uygulanıyor. Anthropic’in kendi ürünlerinde bazı yüksek riskli siber istekler Sonnet 5’e görünür biçimde dönebiliyor. Kart, API’de bu geri dönüşün geliştiricinin katılımına bağlı olduğunu ve başka sağlayıcılarda davranışın farklı olabileceğini belirtiyor. Olağan yazılım geliştirme işlerinin sürmesi hedefleniyor.
Kart, biyolojik kötüye kullanım sınıflandırıcılarının önceki dağıtıma benzer olduğunu; yönetici özetinde ise bazı çok turlu zararsızlık testlerinde gerileme, özellikle kodlama ve tarayıcı ortamlarında istem enjeksiyonuna karşı daha güçlü direnç görüldüğünü söylüyor. Anthropic’in yaklaşık 1.850 senaryolu otomatik davranış denetiminde Sonnet 5.5 çoğu ölçütte Sonnet 5’e eşit veya daha iyi; Opus 5.5 ise genel olarak biraz daha iyi. Bunlar şirket değerlendirmeleri, hatasız çalışma güvencesi değil. Duyuru ayrıca gizli akıl yürütmenin çıkarılmasına karşı korumaları ve hesaplar arasında konuşma taşınmasını etkileyebilen korunmuş düşünme kapsamını genişletiyor.
Sonnet’i düşünme kapalı çalıştıran geliştiriciler için geçiş rehberi, Sonnet 5.5’e geçmeden önce between_tools ayarını istiyor. Uygulamanız geri dönüş veya korunmuş düşünme davranışına dayanıyorsa bunları da sınayın.
En yararlı yerel karşılaştırma, kendi işlerinizden seçilmiş bir grupta aynı başarı ölçütlerini kullanmak: tamamlanan görev, insan düzeltmesi, toplam token, önbellek kullanımı, araç çağrısı, gecikme ve kabul edilen sonuç başına dolar. Gerçekten kullanacağınız efor düzeylerinde deneyin. Böylece duyurudaki hız ve görev maliyeti kazanımlarının kendi istemleriniz ve araçlarınızda sürüp sürmediğini görebilirsiniz.
Kaynaklar 28 Eylül 2026’da kontrol edildi. canberk.me, Sonnet 5.5’i bağımsız olarak ölçmedi. Kapak ve grafik görüntüleri, editoryal haber kapsamında gösterilen Anthropic materyali; özgün etkileşimli grafikler ve diğer hareketli demolar Anthropic sitesinde bulunuyor; gömülü örnek Anthropic sunucusundaki animasyonları istek üzerine yüklüyor.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder