Grok 4.7 tanıtıldı: API fiyatları, kodlama testleri ve Fast seçeneği
xAI'ın 21 Eylül'de duyurduğu Grok 4.7: resmî grafikler, 500K bağlam, API fiyatları, Fast erişimi ve kaynaklardaki önemli tutarsızlıklar.
Bu yazıda
xAI’ın API sürüm notlarına göre Grok 4.7, 21 Eylül 2026’da yayımlandı. Yeni sürüm, kodlama ajanlarını ve bilgi yoğun işleri hedefliyor. Geliştirici belgelerinde 500 bin token bağlam penceresi ve herkese açık API için grok-4.7 model kimliği doğrulanıyor.
Sürüm numarasından daha belirleyici sorular var: akıl yürütme düzeyi kodlama sonucunu ne kadar değiştiriyor, uzun bağlam tarifesi nerede başlıyor ve hızlı seçenek gerçekten hangi ürünlerde kullanılabiliyor? Duyuruyu geliştirici belgeleri, model kartı ve Cursor’ın kendi değerlendirme tablosuyla karşılaştırdık.
Grok 4.6’ya göre ne değişti?
Duyuruda, daha büyük bir temel model ve daha uzun bir pekiştirmeli öğrenme süreci anlatılıyor; odakta tamamlanması saatler sürebilen zor görevler var. xAI ayrıca modelin yaptığı işi kontrol etme ve uzun görevlerde gerekli bağlamı koruma becerilerinin geliştiğini belirtiyor. Bunlar geliştiricinin açıklamaları; canberk.me tarafından yürütülmüş bir model testinin sonuçları değil.
Bu yönelim, mühendislik ekipleri için depo geçişleri, hata ayıklama ve birkaç deneme gerektiren araştırmalarda anlamlı. Bizim değerlendirmemiz, ısrarcı çalışmanın ancak ilerleme doğrulanabiliyorsa yararlı olduğu yönünde: yanlış dosyayı tekrar tekrar değiştiren uzun bir çalışma yine başarısızdır. Testler, kabul edilen değişiklikler ve başarısız komutlardan sonra toparlanma hâlâ yararlı ölçütler.
Nereden erişiliyor, API neleri destekliyor?
Geliştirici rehberi, xAI API, Grok Build, Cursor ve OpenRouter, Vercel, Cloudflare gibi aracı platformları listeliyor. Grok 4.7 Fast, aynı modelin daha hızlı altyapıda sunulan hâli. Yalnızca Cursor ve Grok Build’de var; Grok Build’in ücretsiz katmanına ve herkese açık xAI API’sine dahil değil.
Model kartında tüketici web, mobil ve Grok-in-X erişimi daha sonraya bırakılıyor. Dolayısıyla bu duyuru, modelin tüm bireysel hesaplara şimdiden açıldığı anlamına gelmiyor.
| Özellik | Yayımlanan değer |
|---|---|
| API kimliği | grok-4.7 |
| Bağlam penceresi | 500.000 token |
| Girdi / çıktı | Metin ve görsel / metin |
| Araç ve biçim desteği | Fonksiyon çağırma ve yapılandırılmış çıktılar |
| Akıl yürütme düzeyi | low, medium, high, xhigh; varsayılan high |
| API arayüzleri | Responses ve Chat Completions |
| Batch API | Model sayfasında desteklenmiyor olarak belirtiliyor |
Kaynaklar: model özellikleri ve geliştirici rehberi. Rehber ayrı bir metin çıktısı sınırı belirtmiyor; bu, bağlam penceresini, istek bütçelerini veya pratik çalışma sınırlarını kaldırmıyor. Görsel girdi desteği de modelin kendi başına görsel ya da video ürettiği anlamına gelmiyor.
Fiyatlandırma: bağlam eşiği önemli
Aşağıdaki tutarlar milyon token başına ABD doları. Fiyat sayfası şu katmanları ayırıyor:
| Sunum seçeneği | İstek girdisi | Girdi | Önbellekten girdi | Çıktı |
|---|---|---|---|---|
| Standart API | 200 binin altında | $2,00 | $0,50 | $6,00 |
| Standart API | 200 bin ve üzeri | $4,00 | $1,00 | $12,00 |
| Fast | 200 binin altında | $4,00 | $1,00 | $12,00 |
| Fast | 200 binin üzerinde | $6,00 | $1,50 | $18,00 |
Standart eşiğe ulaşıldığında yeni tarife istekteki tüm tokenlara uygulanıyor. Fast bölümü “200 binin üzerinde” ifadesini kullanıyor; listelenen uzun bağlam ücretlerini genel bir 2× hesabıyla değiştirmemek gerekiyor. Cursor, Fast kullanımını kendi planı üzerinden faturalandırıyor. Akıl yürütme ve araç kullanımı da toplam faturayı etkiliyor.
Basit hesap örneğimiz: önbelleksiz 100 bin girdi tokenı ve faturalandırılan 20 bin çıktı tokenı, standart kısa bağlam tarifesiyle, araç ücretleri hariç 0,32 dolar tutuyor. Bu bir token bütçesi hesabı; gerçek görevin ne kadar token gerektireceğine ilişkin tahmin değil. İkinci deneme, uzayan konuşma veya farklı akıl yürütme düzeyi toplamı değiştirir.
Kodlama testleri: aynı akıl yürütme düzeyini karşılaştırın
Aşağıdaki resmî duyuru grafiği, yayımlanan şeklin doğrudan görüntüsüdür; yeniden çizilmedi. Yatay maliyet ekseni soldaki pahalı sonuçlardan sağdaki ucuz sonuçlara ilerliyor.
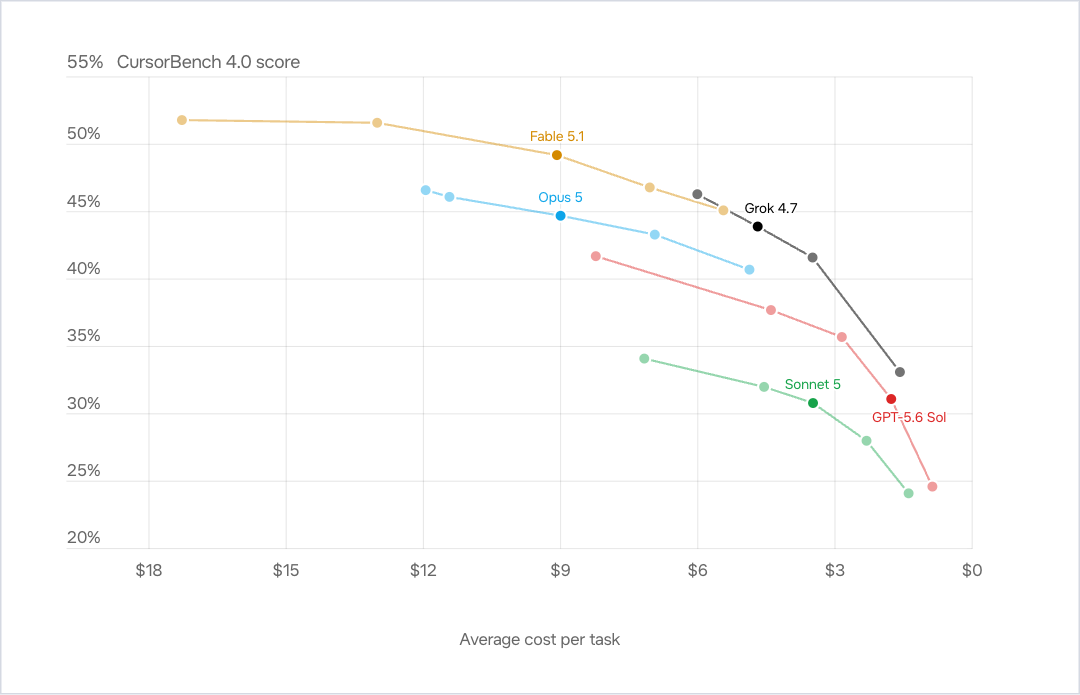
23 Eylül’de kontrol ettiğimiz Cursor’ın kendi sonuçları, karşılaştırmayı netleştiriyor:
| Model / akıl yürütme | CursorBench 4.0 | Ortalama görev maliyeti |
|---|---|---|
| Grok 4.6 / high | %40,4 | $5,20 |
| Grok 4.7 / high | %43,9 | $4,69 |
| Grok 4.6 / xhigh | %41,4 | $6,10 |
| Grok 4.7 / xhigh | %46,3 | $6,01 |
| Opus 5.5 / high | %56,0 | $3,97 |
Hesabımıza göre Grok’taki artış high düzeyinde 3,5 yüzde puan, xhigh düzeyinde 4,9 puan. 4.7/xhigh ile 4.6/high karşılaştırması iki farklı ayarı karıştırıyor. Canlı tabloda duyuru grafiğinde bulunmayan Opus 5.5 gibi yeni rakipler de var. Bu sonuçlar genel bir liderlik iddiası kurmaya yetmiyor.
Cursor, ajanları gerçek oturumlardan gelen çok dosyalı görevlerde değerlendiriyor ve küçük puan farklarının istatistiksel olarak anlamlı olmayabileceğini belirtiyor. Maliyetler kullanılan tokenlar ve yayımlanan tarifeler üzerinden hesaplanıyor; abonelik fiyatı veya sizin deponuz için verilmiş bir teklif değil.
Ofis işleri ve görünür tutulması gereken tutarsızlıklar
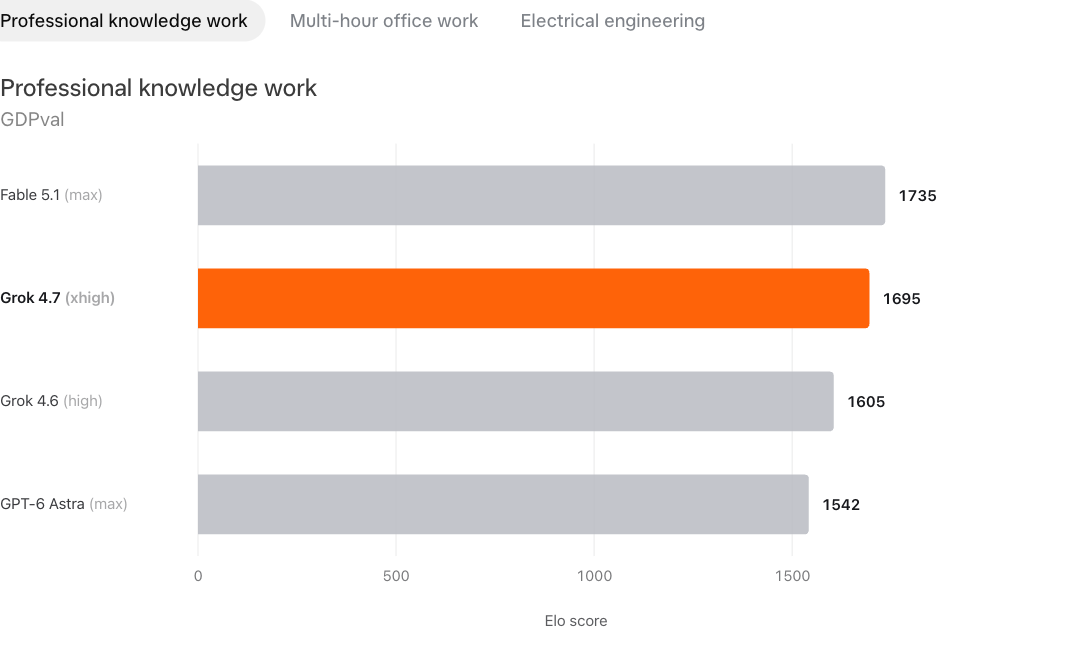
Duyuru tablosunda DeepSWE v1.1 için high düzeyinde %71,0 veriliyor. Aynı tablo Grok 4.7’yi Terminal-Bench 4.0’da %37,6, EEBench’te %64,0 gösterirken model kartı xhigh için sırasıyla %38,0 ve %66,0 bildiriyor. Kontrol edilen kaynaklar iki farkı da açıklamıyor; bu nedenle tek bir değeri sessizce seçmedik.
Güncellik konusunda da belge farkı var: geliştirici rehberinde bilgi kesim tarihi Mayıs 2026; model kartında ön eğitim verisi Haziran 2026, ek eğitimde kullanılan veri ise Ağustos 2026 olarak anlatılıyor. Bu açıklamaları koşulsuz tek bir bilgi kesim tarihine dönüştürmemek gerekiyor.
Model kartı, koruma mekanizmalarını ve güvenlik değerlendirmelerini de belgeliyor. Operasyon açısından çıkarımımız, daha yetenekli bir ajana geçerken inceleme ve araç yetkilerini korumak. Benchmark belirli bir kurulumun sonucunu ölçer; modele üretim ortamını bağımsız değiştirme yetkisi vermez.
Entegrasyonda sonucu değiştirebilecek ayrıntılar
Akıl yürütme rehberine göre bu özellik tamamen kapatılamıyor. Grok 4.7, Responses üzerinde şifreli akıl yürütme öğelerini otomatik döndürüyor; konuşma geçmişini kendiniz yönetiyorsanız bu öğeleri sonraki isteğe değiştirmeden aktarmalısınız. Bu veri, okunabilir bir düşünce zinciri değil, konuşma durumudur.
Tekrar kullanılan depo bağlamı için önbellek rehberi, Responses’ta sabit bir prompt_cache_key, Chat Completions’ta ise x-grok-conv-id kullanılmasını öneriyor. Amaç isteklerin yeniden kullanımı mümkün kılacak biçimde yönlendirilmesi. Her tekrarlanan isteğin indirim aldığı varsayımı yerine gerçekten önbellekten gelen tokenları ölçmek gerekiyor.
Ayrı bağlam sıkıştırma API’si, uzun ajan döngülerinde biriken geçmişi küçültebiliyor. Konuşma hâlâ bağlam penceresine sığarken çalıştırılmalı; zaten sınırı aşmış bir isteği kurtaramıyor. Dönen kapalı durum öğesi, devam ederken değiştirilmeden korunmalı.
İşleme konumu gereksinimi olan ekipler için ABD bölgesel uç noktası, token tarifesine %10 ekliyor. Kapsamı Files, Collections ve sunucu taraflı araçları içermiyor; bölgesel adres seçimi tüm bağlı servisleri kapsayan bir garanti değil. Ayrıca API güvenlik belgesi, varsayılan 30 günlük saklama süresini açıklıyor ve API girdi/çıktılarının izin olmadan eğitimde kullanılmadığını belirtiyor. Veri saklama ile eğitimde kullanım farklı kararlar.
İlk değerlendirmede Grok 4.6 ve 4.7’yi aynı küçük depo düzeltmeleri grubunda, aynı akıl yürütme ayarı, araçlar ve kabul testleriyle eşleştirirdik. Kabul edilen değişiklikleri, tamamlanma süresini, tekrarları ve toplam maliyeti kaydeder; ardından en iyi adayı aynı görevlerle yeni GPT-6 modelleri ve Opus 5.5 ile karşılaştırırdık. Duyuru verileri denemeyi gerekçelendiriyor; denemenin yerini tutmuyor.
Kaynaklar 23 Eylül 2026’da kontrol edildi. Kapak yapay zekâyla üretilmiş editoryal illüstrasyondur. Yazı içindeki üç görsel, kaynak belirtilerek kullanılan resmî görsel veya resmî grafiklerin doğrudan görüntüleridir. Bu haber için bağımsız model benchmark’ı çalıştırılmadı.
Kaynaklar
- Introducing Grok 4.7 ↗SpaceXAI
- API sürüm notları — 21 Eylül ↗SpaceXAI
- Grok 4.7 geliştirici rehberi ↗SpaceXAI
- Grok 4.7 model özellikleri ↗SpaceXAI
- API ve Grok 4.7 Fast fiyatları ↗SpaceXAI
- Grok 4.7 model kartı — 2026-09-21 revizyonu ↗SpaceXAI
- CursorBench 4.0 sonuçları ve yöntemi ↗Cursor
- Akıl yürütme düzeyi ve şifreli akıl yürütme durumu ↗SpaceXAI
- Prompt önbelleğinden yararlanma ↗SpaceXAI
- Bağlam sıkıştırma ↗SpaceXAI
- Bölgesel API uç noktaları ↗SpaceXAI
- API güvenliği ve veri saklama ↗SpaceXAI
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder