Yapay zekâ kodu insansız inceleyebilir mi? CRBugBench, en iyi ajanın bilinen hataların %71,9'unu yakaladığını gösteriyor
1.800 kod inceleme görevinden oluşan bir benchmark: en iyi ajan ilk beş bulgusunda bilinen hataların %71,9'unu yakalıyor; özel kodda daha azını.
Bu yazıda
Kodu bir yapay zekâ ajanı yazıp bir diğeri inceliyorsa, inceleyici gerçekte kaç hatayı yakalıyor? Yeni bir ön baskı buna bir sayı koyuyor. Chenyang Yang, Hao He, Ti-Chung Cheng, Jenna Butler, Emerson Murphy-Hill, Carmen Badea ve Christian Bird (Carnegie Mellon Üniversitesi, Microsoft ve Microsoft Research; arXiv, 9 Ekim) CRBugBench’i kurdu ve en iyi inceleme ajanının ilk beş bulgusunda bilinen hataların %71,9’unu yakaladığını, özel kodda ise keskin bir düşüş olduğunu buldu. Tam metni ve tablolarını okuduk; hiçbir şeyi yeniden çalıştırmadık ve sayfada hakem değerlendirmesi durumu yok. Bu yazı, kodlama ajanlarında alt ajanlara ve kodlama benchmark’larını denetlemeye dair önceki yazılarımızın yanına oturuyor.
CRBugBench nedir?
Bir inceleme ajanının, bir insanın zaten doğruladığı hataları bulup bulmadığını soran bir benchmark. Yazarlar, yapay zekânın kod yazdığı ve neredeyse hiç insan gözetimi olmadan incelediği “ışıksız” bir yazılım fabrikası fikrinden yola çıkıyor ve çoğu kod inceleme benchmark’ının bir yapay zekânın yorumlarını insan yorumlarıyla karşılaştırdığını, bunun da güvenilmez bir referans olduğunu savunuyor. CRBugBench bunun yerine insanların doğruladığı hataları alıyor ve onları getiren pull request’e (PR) kadar izliyor. İnceleme ajanı yalnızca o PR’ı, yalıtılmış bir depoda görüyor, bir hata olduğu söylenmiyor ve sıralı bir bulgu listesi yazıyor.
Nasıl kuruldu?
Depo geçmişinden, iki akışta ve ardından denetlenerek. Yazarlar Python, Rust, C#, JavaScript/TypeScript ve Java’daki yerleşik depoları seçti (her biri 2.000’den fazla PR ve 200 katkıcı, her dilde uygulama alanı başına bir depo). Birleştirme öncesi akış, 1.436.120 inceleme dizisi olan 304.601 birleştirilmiş PR’dan başlıyor, 472.039 aday diziye süzüyor, depo başına 90 örnekliyor ve bir LLM filtresinden sonra 865 doğrulanmış hata tutuyor. Birleştirme sonrası akış 195.075 hata düzeltme PR adayından başlıyor, SZZ algoritmasıyla izlenen ve LLM’lerle süzülen 689 düzeltme ve getiren PR çiftiyle bitiyor ve her akış 500 göreve indiriliyor. Bu, 98 depoda 1.000 açık kaynak görevi ve büyük bir şirketteki iki sektör monorepo’sundan 800 görevi (açık kaynak depolarda yaklaşık 3.000 kaynak dosyasına karşılık ortalama 100.000’den fazla) veriyor. Örneklenen 40 hatanın elle kontrolünde 37’si geçerliydi (%92,5, %95 aralığı %80,1-97,4).
Puanlama üç LLM yargıç panelini (gpt-5.5, claude-opus-4.8 ve gemini-3.1-flash) ve çoğunluk oyunu kullanıyor; insanların etiketlediği 40 örnekle uyum kappa 0,89. Ölçüt recall@k, yani bilinen hatanın ajanın ilk k bulgusu arasında göründüğü görevlerin payı. Ana koşum takımı, resmî /review istemi ve mevcut en yüksek akıl yürütme çabasıyla copilot-cli 1.0.74’tü. Ajanlar internet erişimi kısıtlanmış ve hile yapmamaları söylenmiş bir Docker anlık görüntüsünde çalıştı; yazarlar, yörüngelerin yapay zekâ destekli bir denetiminde hile bulunmadığını söylüyor.
Ajanlar kaç hata yakaladı?
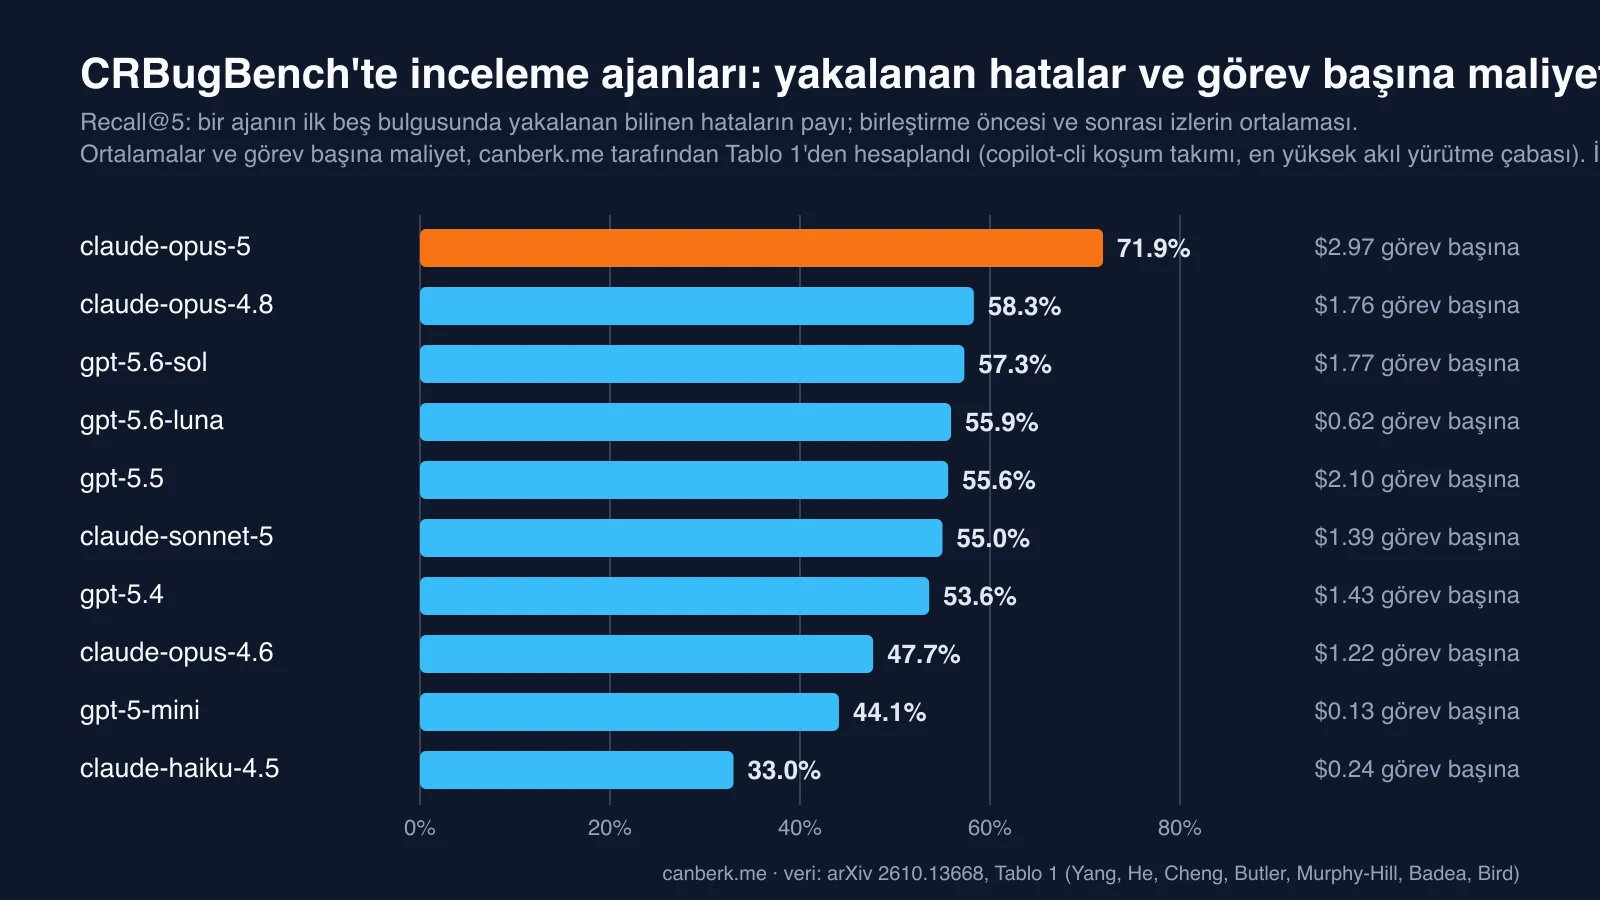
En iyi ajan yaklaşık %72 buldu ve beş ayda keskin biçimde yükseldi. İlk beş bulgusunda claude-opus-5, insanların birleştirmeden önce bulduğu hataların %79,6’sını ve sonradan bulunanların %64,2’sini yakaladı; ortalama %71,9. Yazarlar claude-opus-4.6 için %47,7 ve Şubat’tan Temmuz 2026’ya %71,9’a bir yükseliş bildiriyor. Görev başına ortalama $2,97’ye mal oldu, ortalama gecikme 9,8 dakikaydı ve bulunan hataların %89’u ilk üç maddede çıktı.
Daha ucuz modeller iyi değer verdi. gpt-5.6-luna, claude-opus-5’in performansının yaklaşık %78’ine maliyetin yaklaşık %21’iyle ulaştı. Yazarlar ajanları insanlarla da karşılaştırıyor ve benchmark’a yerleşik bir çekinceyle: görevler insanların birleştirmeden önce yakaladığı ve sonraki düzeltmelere kaçan hataların karışımından kurulduğu için, insanlar tek başına yapı gereği yaklaşık %50 yakalıyor, en iyi ajan %71,9 ve ikisi birlikte %82,1. %50, insan inceleyiciler için genel bir oran değil.
Ajanlar hataları neden kaçırıyor?
Çoğunlukla hata diff’te görünmediği için ve ajanlar çalıştırmaktan çok okuduğu için. Tüm incelemeler üzerinde bir regresyonda daha büyük diff’ler (odds oranı 0,591), daha heterojen diff’ler (0,795) ve hata düzeltme PR’ları (0,521) yakalama şansını düşürdü; kullanılabilirlik hataları da öyle (0,454); diff’te görünen hatalar ise çok daha kolaydı (2,621) ve ciddi hatalar bir miktar daha kolaydı (1,906). Diff boyutu hesaba katıldığında dilin ve depo boyutunun anlamlı etkisi yoktu. İnsanlar bakım yapılabilirlik sorunlarında daha iyiydi (2,702), ajanlara göre ciddi hatalarda (0,450) ve güvenilirlik sorunlarında (0,591) daha kötüydü.
Davranışta ajanlar tipik olarak git işlemleriyle başladı, ardından turlarının yaklaşık %75’ini okuyarak (%39) ve arayarak (%36), yaklaşık %8’ini kod çalıştırarak geçirdi. claude-opus-5 turlarının %9,7’sinde kod çalıştırdı, gpt-5.6-sol’da bu %6,9’du ve döngüde daha uzun kaldı: çalıştırmalarının yarısı 35. turda bitti, gpt-5.6-sol’da 17. turda. Tüm çalıştırmaların %95,6’sı hatayı barındıran dosyayı inceledi, %80,2’si hakkında bir bulgu üretti ve %56,2’si hatayı yakaladı; claude-opus-5 için bu rakamlar bulgu için %91,9 ve doğru teşhis için %75’ti. Yazarlar aşırı güven vakalarını anlatıyor: bir Selenium görevinde hem bir kod yorumu hem de PR açıklaması amaçlanan davranışı ileri sürdüğü için her model hatalı koşulu onayladı ve bir Elasticsearch görevinde claude-opus-5 hatalı satırı doğruluk ölçütü olarak gösterdi.
Özel kodda ne oldu?
Performans %25,5’e kadar düştü. Özel görevler diff’te yerel olarak görünen çok daha az hata içeriyor (GitHub’da %46,1’e karşılık %22,8) ve proje bağlamı, alan bilgisi ya da çalışma zamanı kanıtı gerektiren çok daha fazlasını. Yazarlar yalnızca hata görünürlüğünü ayarlamanın farkın yaklaşık %20’sini açıkladığını söylüyor. Özel kodun hiçbir modelin eğitim verisinde kesinlikle yer almadığını ve bunun herkese açık sonuçlar için yararlı bir çapraz kontrol olduğunu ekliyorlar.
Neyin ek recall getirdi, maliyeti neydi?
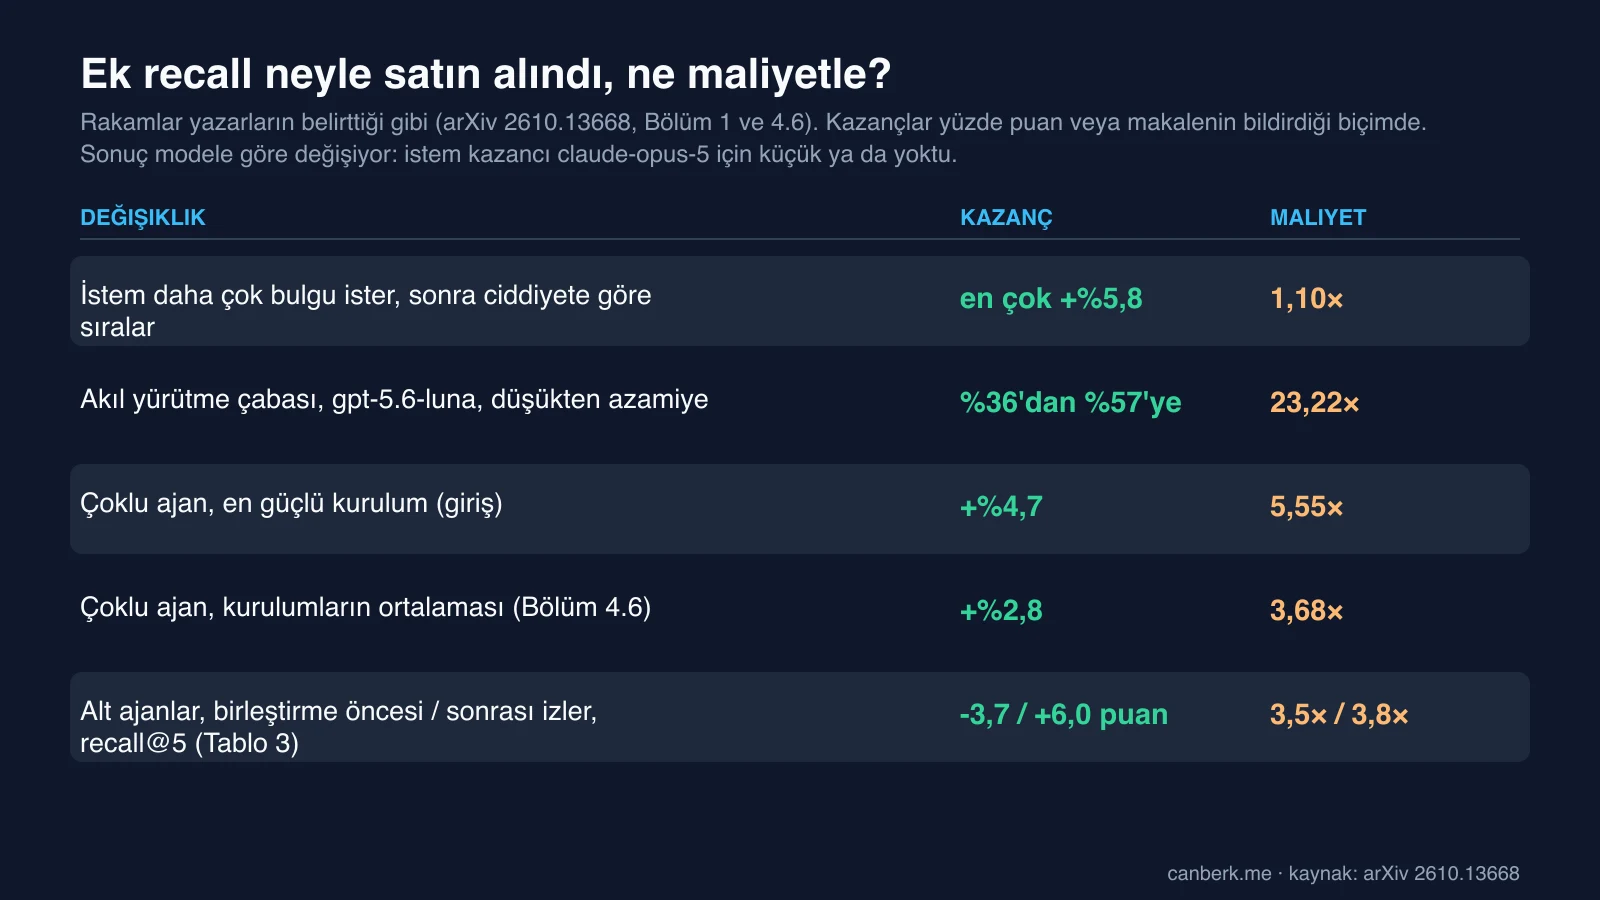
İstem en ucuz kaldıraçtı, çaba ve ajan sayısı pahalıydı. Yazarlar, ajanlardan daha kapsamlı bulgular isteyip sonra ciddiyete göre sıralamanın 1,10× maliyetle en çok %5,8 kazandırdığını bildiriyor; gpt-5.6-sol için ortalama kazanç %5,3’tü, claude-opus-5 için ise küçük ya da yoktu. gpt-5.6-luna’nın akıl yürütme çabasını düşükten azamiye çıkarmak onu yaklaşık %36’dan %57’ye 23,22× maliyetle getirdi. Çoklu ajan kurulumları girişte 5,55× ile %4,7, Bölüm 4.6’da ortalama 3,68× ile %2,8 kazandırdı; makale söylemiyor, ama biz bunları en güçlü kurulum ve ortalama olarak okuyoruz. gpt-5.6-sol için çoklu ajan tablosunda recall@5’te alt ajanlar birleştirme öncesi izde recall’u 3,7 puan düşürdü ve sonrası izde 6,0 puan artırdı.
Koşum takımı seçimi de önemliydi: yazarların testlerinde copilot-cli, claude-code’u geçti. claude-opus-5’i claude-code ile eşleştirmek maliyeti keskin biçimde artırdı; çünkü copilot-cli’da hiç olmayan çalıştırma başına yaklaşık 9,0 alt ajan kullandı ve makale bunu Anthropic’in belgelerinde claude-opus-5’in önceki modellerden daha kolay alt ajanlara devrettiğini söyleyen ifadeye bağlıyor. Yazarlar geliştiricilere bir model değiştiğinde bu tür maliyet artışlarına dikkat etmelerini söylüyor.
Yani bir yazılım fabrikası ışıksız çalışabilir mi?
Yazarlara göre henüz değil. Mevcut kanıtın ışıksız işletimi yalnızca dar kapsamlı, düşük sonuçlu PR’lar için desteklediğini ve sonuçlu değişikliklerde ajanların, son kararı hesap verebilir bir insanın verdiği ölçeklenebilir akranlar olarak ele alınmasının daha iyi olduğunu yazıyorlar. Önerileri: inceleme çabasını PR karmaşıklığına göre ölçeklemek, ajanları proje önceliklerine göre yönlendirmek (örneğin kullanılabilirlik ya da bakım yapılabilirlik hakkında açıkça sormak), depo bilgisi sağlamak, modelleri PR özelliklerine göre yönlendirmek ve modeller değiştikçe inceleme kalitesini izlemek. Ayrıca ekiplerin makalenin yöntemiyle kendi depolarından kendi benchmark’larını kurmasını öneriyorlar.
Sınırlılıklar neler?
Yazarlar sıralıyor. Benchmark, genel inceleme yararlılığını değil bilinen hataların geri kazanımını ölçüyor. Referans yanlış olabilir (denetimde örneklenen 40 görevin 3’ü geçersizdi) ve yargıçlar LLM; bunların arasında test edilen ailelerden modeller de var ve üç modelli bir panelle hafifletiliyor. Ajan çalıştırmaları rastgele, regresyonlar gözlemsel ve nedensellik değil ilişki gösteriyor, seçim olgun, etkin, popüler projeleri öne çıkarıyor; bu yüzden sonuçlar daha küçük ya da genç projeler, yaygın olmayan diller ve yapılandırma ağırlıklı kod için farklı olabilir. Yazarlar Microsoft, Microsoft Research ve Carnegie Mellon’da, ana koşum takımı Microsoft bağlantılı copilot-cli ve özel depolar adı verilmeyen tek bir büyük şirkete ait; bunu bir bulgu olarak değil bağlam olarak anıyoruz.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Bilinen hataların recall’u bir alt sınır, hüküm değil. Bir ajan kimsenin kaydetmediği hataları da bulabilir, gürültü de ekleyebilir; benchmark ikisini de puanlamıyor.
- %71,9’u karışımıyla okuyun. Birleştirme öncesi ve sonrası bir izin ortalaması ve yalnızca ilk beş bulguyu sayıyor. En iyi ajan için yalnızca birleştirme sonrası iz %64,2.
- Önemli olan benchmark sizin deponuz. Özel koddaki düşüş ve yazarların özel benchmark kurma tavsiyesi, bir skora güvenmeden önce kendi geçmişinizde ölçmeye işaret ediyor.
- Kaliteyle birlikte maliyeti izleyin. Çaba ve çoklu ajan ayarları mütevazı kazançlar için maliyeti kat kat artırdı ve bir model-koşum takımı eşleşmesi harcamayı alt ajan kullanımıyla değiştirdi.
Editoryal inceleme: 12 Ekim 2026 (YZ). arXiv 2610.13668’in (v1, 9 Ekim; HTML sürümü, Tablo 1-3 ve tartışma dahil) tam metninden hazırlandı. Hiçbir deneyi yeniden çalıştırmadık, bir çoğaltma paketi aramadık ve yazarların iddialarını bağımsız olarak doğrulamadık. Grafikteki model başına ortalamalar ve görev başına maliyet Tablo 1’den bizim hesaplarımız; diğer tüm rakamlar yazarlara ait. “Akılda tutulacaklar” bizim.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder