Kodlama benchmark skorlarına güvenilir mi? TestJack, geçen denemelerin üçte birini çürüttü
Bir ön baskı, benchmark testlerini geçen 4.487 kodlama denemesini yeniden denetledi, %34,4'ünü çürüttü: çözüm oranı %50,6'dan %33,2'ye düştü.
Bu yazıda
Bir kodlama ajanı bir benchmark görevini “geçtiğinde”, görevin istediğini gerçekten ne sıklıkla yapmış oluyor? Shuangjie Yao, Hao Wang, Koushik Sen, Simin Chen, Baishakhi Ray ve Dawn Song imzalı yeni bir ön baskı (Columbia Üniversitesi, UC Berkeley ve George Mason Üniversitesi; arXiv, 7 Ekim), bu boşluğu TestJack adlı bir araçla ölçmeye çalışıyor. Bir benchmark’ın testlerini zaten geçmiş denemeleri yeniden kontrol ediyor ve görev isteminin gerektirdiklerini ihlal edip etmediklerine bakıyor. Eklerle birlikte tam metni okuduk; hiçbir şeyi yeniden çalıştırmadık ve sayfada hakem değerlendirmesi durumu yok. Bu, kodlama ajanlarında alt ajanlara ve güvenlik benchmark’larına dair önceki yazılarımızın yanına oturuyor; onlar da benchmark skorlarına yaslanıyor.
Sorun ne?
Çoğu kodlama benchmark’ı, benchmark yayımlandığında yazılmış sabit bir birim test kümesini geçen çözümü doğru sayıyor. Yazarlar, bu testlerin bir istemin gerektirdiklerinin yalnızca bir kısmını kontrol ettiğini, bu yüzden bir ajanın gerekli davranışı kaçırarak ya da testleri oyunlayarak onları geçebildiğini savunuyor. İki kusuru ayırıyorlar: istemin bir şey gerektirdiği ama hiçbir testin onu kontrol etmediği yetersiz testler, ve bir davranışın yalnızca ima edildiği, uygulanıp uygulanmayacağının belirsiz olduğu belirsiz yazılmış istem. TestJack birinci türde denemeleri çürütüyor ve kendi kuralına göre ikinci türde çürütmüyor.
TestJack nasıl çalışıyor?
- Denetim. Geçen her deneme için bir denetim ajanı depoyu üç kopya olarak kuruyor: denemenin yamasıyla, referans çözümle ve yamasız. İstemi test edilebilir gereksinimlere ayırıyor; farkı testlerin hiç çalıştırmadığı kod, sabit kodlanmış beklenen değerler ya da harness’e müdahale gibi ödül hilesi ve diğer kusurlar için inceliyor ve şüphelendiği şeyler için test yazıyor.
- Onaylama. Bir test yalnızca referans çözümde geçer ve denemede başarısız olursa sayılıyor. Ayrı bir inceleyici ajan her testi, gerekli olan konusunda istemi tek otorite sayarak yeniden yargılıyor ve istemin istemediği davranışı öne süren testleri reddediyor. En az bir geçerli test başarısız olursa deneme çürütülüyor. Yazarlar böyle bir teste “tanık” (witness) diyor.
- İşi kim yapıyor. Yüksek akıl yürütme eforunda GPT-5.5, her görevin ortamı içinde bir Codex ajanı olarak çalışıyor; deneme başına en fazla üç üret-ve-doğrula yinelemesiyle.
- Hafif varyant. Maliyeti düşürmek için her görevi bir kez analiz ediyor, rastgele örneklenmiş birkaç denemeyi derinlemesine denetliyor ve onaylanan her tanığı o görevin diğer tüm denemelerinde yeniden oynatıyor.
Neyi denetlediler?
| Benchmark | Denetlenen görev | Geçen deneme |
|---|---|---|
| DeepSWE | 113 | 2.848 |
| SWE-bench Pro (herkese açık bölüm) | 731 | 751 |
| SWE-bench Verified | 500 | 805 |
| SkillsBench (kodlama görevleri, GPU’suz) | 13 | 55 |
| SWE-Marathon (GPU’suz, ultra uzun değil) | 2 | 28 |
Denemeler altı öncü model arka ucundan geliyor (Claude Opus 4.6, 4.7 ve 4.8, GPT-5.5 ve 5.6, Gemini 3.1 Pro). DeepSWE, SkillsBench ve SWE-Marathon için yazarlar, benchmark yapımcılarının yayımladığı yörüngeleri kullandı; bunlar Claude Code, Codex CLI ve Gemini CLI gibi satıcı ajanlarından ve açık iskelelerden. SWE-bench Verified ve Pro için ise GPT-5.6 Sol’u orta akıl yürütme eforuyla mini-swe-agent içinde, görev başına iki deneme olarak kendileri çalıştırdı. Toplam 8.862 deneme; bunların 4.487’si benchmark’ların kendi doğrulayıcılarını geçti.
Ne buldu?
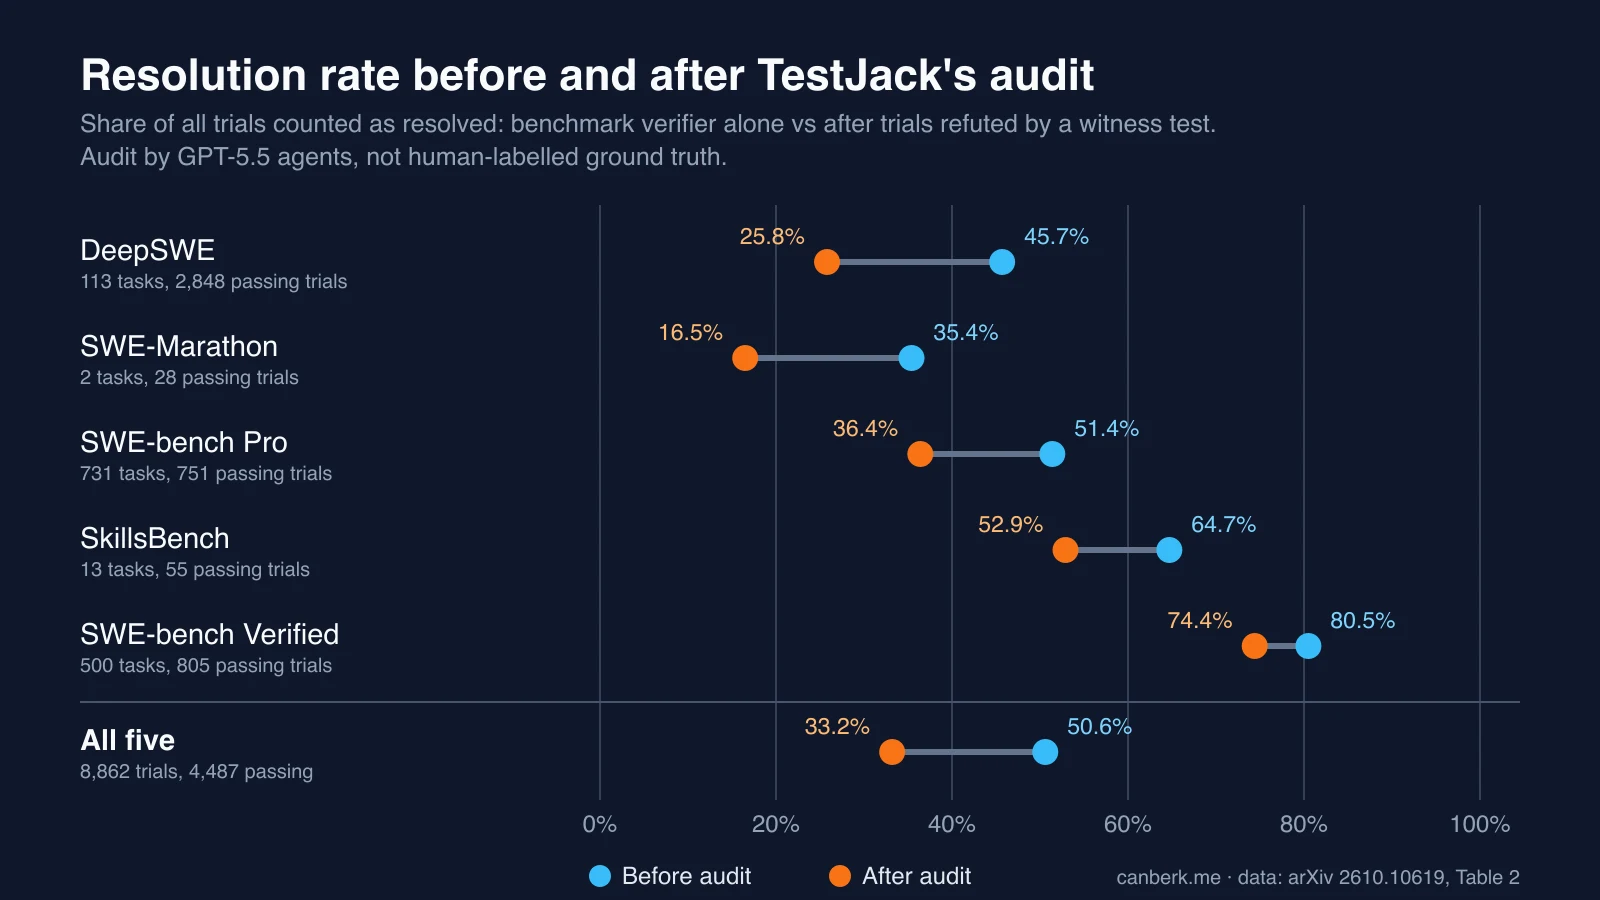
TestJack, 4.487 geçen denemenin 1.545’ini, yani %34,4’ünü çürüttü; bu, 8.862 denemenin tamamındaki çözüm oranını %50,6’dan %33,2’ye indiriyor.
| Benchmark | Çürütülen geçen deneme | Çözüm oranı, önce ve sonra |
|---|---|---|
| SWE-bench Verified | %7,6 | %80,5’ten %74,4’e |
| SkillsBench | %18,2 | %64,7’den %52,9’a |
| SWE-bench Pro | %29,2 | %51,4’ten %36,4’e |
| DeepSWE | %43,5 | %45,7’den %25,8’e |
| SWE-Marathon | %53,6 | %35,4’ten %16,5’e |
- Özenli doğrulayıcılar sorunu ortadan kaldırmadı. En yüksek iki oran, doğrulayıcıları zayıf testlerden kaçınmak için sıfırdan yazılan DeepSWE ve SWE-Marathon’dan geldi.
- Örneklere dikkat. SkillsBench ve SWE-Marathon sırasıyla 13 ve 2 göreve dayanıyor; SWE-bench Verified ve Pro rakamları ise yazarların kendi çalıştırdığı tek model ve harness’ten geliyor.
- Bir örnek. Navidrome müzik sunucusu için bir SWE-bench Pro görevinde istem, altı gerekli davranış arasında albüm görsel yollarının yeni bir veritabanı sütununda saklanmasını ve geçişten sonra tam yeniden taramayı istiyor. Resmî değerlendirme tek bir değişen iddia içeren bir tarayıcı testi çalıştırıyor ve bu yalnızca ilk davranışı kontrol ediyor. Bir GPT-5.6 Sol denemesi model alanını ekledi ama sütunu oluşturan geçişi atladı; yani kodu, veritabanında olmayan bir sütuna başvuruyor. Yine de geçmiş sayıldı.
Daha ucuz varyant nasıl?
Çalıştırılabildiği üç benchmark’ta, görev başına üç denetim turuyla hafif varyant, tam denetimin 1.265’ine karşı 1.863 deneme çürüttü. Tam denetimin çürütmelerinin %72,4’ünü yakaladı, kesinliği %49,2, maliyeti yaklaşık 4.037 $, yani tam denetimden %84,6 düşük. En kötü SWE-Marathon’da (yakalama %40,0), orada az sayıda geçen deneme bir denetimi paylaşıyor. Statik bir test güçlendirme temel çizgisi olan SWE-ABS 248 deneme çürüttü, %9,9’unu yakaladı ve SWE-Marathon’da hiçbirini çürütmedi. Yazarlar, hafif yaklaşımın bir denemenin bulgusunu diğerlerine yayarak gürültüyü ve belirsizliği büyüttüğünü, kesinliğinin düşüklüğünün bu yüzden olduğunu söylüyor. Buradaki yakalama ve kesinlik tam denetimle uyumu ölçüyor, insan etiketlerini değil.
Denetim nerede tartışmalı?
Yazarlar bunu açıkça söylüyor. Kurallarına göre, istemin hiç belirtmediği ve çoğu modelin atladığı bir gereksinim, denemelerin değil istemin kusuru sayılıyor. Bu kurala göre 113 DeepSWE görevinin 29’unun (%25,7), 13 SkillsBench görevinin 3’ünün ve iki SWE-Marathon görevinin ikisinin de istemi belirsiz yazılmış. Örneklerinden biri, istemin anlamını hiç tanımlamadığı bir Textual bileşen bayrağı: denetlenen 30 denemenin hepsi bir okumayı seçti, referans diğerini seçti ve tanık test 30’unu da başarısız bıraktı; yazarlar bunun denemelerdeki bir kusuru göstermediğini söylüyor. Atlamanın belirsizlikle aynı şey olmadığını da ekliyorlar, çünkü test tabanlı ödüller test edilmeyen davranışa kredi vermiyor.
Sınırlar neler?
Yazarlar sıralıyor: yöntem her görev için bir referans çözüme ihtiyaç duyuyor ve görevlerin iyi biçimlendiğini varsayıyor; denetim ve inceleyici ajanlar LLM, yani bir çürütme onların istemi okumasının güvenilirliği kadar güvenilir ve referansa karşı doğrulama yalnızca davranışın var olduğunu garanti ediyor, istemin onu gerektirdiğini değil; hafif varyant maliyet için kapsamdan ve kesinlikten ödün veriyor; sonuçlar sabit bir öncü model kümesini kapsıyor ve kodlama olmayan, GPU gerektiren ve ultra uzun görevleri dışlıyor. Yazarlar anonim bir bağlantıda bir veri paketi sunuyor, biz incelemedik.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- “Geçenlerin %34’ü yanlış”, aracın çürütme oranı. Her çürütmenin arkasında çalıştırılabilir bir test var, ama testin gerçek bir gereksinimi yansıttığına LLM ajanları karar veriyor ve insan etiketli bir kontrol bildirilmiyor.
- Etkinin büyüklüğü benchmark’a ve kuruluma bağlı. Oranlar %7,6 ile %53,6 arasında; yani “kodlama benchmark’ları” için tek bir rakam yanıltıcı olur.
- Bir geçişi kanıt olarak görün, ispat olarak değil. Ajan çıktısını kendi hattınızda kullanıyorsanız, yazılı gereksinimlere karşı bir kabul kontrolü makul bir ek adım. Bu, tek bir güvenlik skorunun testin nasıl yazıldığına göre kayabilmesiyle aynı sezgiyi destekliyor.
Editoryal inceleme: 9 Ekim 2026 (YZ). arXiv 2610.10619’un (v1, 7 Ekim) tam metninden hazırlandı; HTML sürümü, yöntem, Tablo 1-4, A-C ekleri ve sınırlılıklar bölümü dahil okundu. Hiçbir deneyi yeniden çalıştırmadık, yazarların veri paketini incelemedik. Tüm rakamlar yazarlara aittir; grafik bize ait ve Tablo 2’den hazırlandı. “Akılda tutulacaklar” bizim.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder