EPFL ve Apple çalışması: minimal bir kodlama ajanı karmaşık ML harness'lerine denk
EPFL ve Apple araştırmacılarına göre sade bir kodlama ajanı dört karmaşık ML harness'ine denk geldi, ama içlerinden birinden yaklaşık altı kat pahalıya.
Bu yazıda
Güçlü bir kodlama modelinin etrafına karmaşık bir harness kurmanız gerekiyor mu? Yeni bir makale, makine öğrenmesi mühendisliği görevlerinde çoğunlukla gerekmediğini söylüyor. Apple bağlantılı EPFL araştırmacıları, tek bir minimal kodlama ajanı oturumunun aynı model, donanım ve süreyle bu iş için kurulmuş dört açık kaynaklı harness’e denk geldiğini ya da onları geçtiğini bildiriyor. Makale Apple’ın makine öğrenmesi araştırma sitesinde listelenmiş, ancak üç yazarı da EPFL ve Apple bağlantısıyla yazılmış, biri çalışmayı Apple’da stajyerken yapmış; yani bir Apple ürün duyurusu değil. Makalenin tamamını okuduk; deneyleri yeniden çalıştırmadık.
Araştırmacılar neyi test etti?
Malena adını verdikleri minimal tek oturumlu bir ajanı, ajanı arama ağaçları, alt ajanlar ve bellek mekanizmalarıyla saran harness’lerle karşılaştırdılar. Malena, OpenCode çerçevesi üzerinde, tüm zaman bütçesi boyunca çalışan tek bir kodlama ajanı oturumu; üç küçük aracı var: biri teslimi kaydediyor, biri donanımı ve kalan zamanı bildiriyor, biri arka plan işleri çalıştırıyor. Karşılaştırıldığı dört açık kaynaklı harness MLEvolve, AiScientist, Arbor ve ScienceFlow.
- Modeller: GLM 5.2, Kimi K3, DeepSeek V4 Flash ve Gemma 4 31B; hepsi açık ağırlıklı, yerelde vLLM ile çalıştırıldı.
- Görevler: MLE-bench’ten (Kaggle tarzı ML problemleri) 30 ve bilimsel araştırma kıyaslaması NatureBench’ten 40 görev.
- Düzen: ajan başına bir A100 80GB GPU, 24 saatlik bütçe, MLE-bench’te 17 harness-model çifti ve bootstrap ile %95 güven aralıkları.
Ne buldular?
- Asıl kaldıraç ortam. Modelin sohbet penceresinde yanıt vermek yerine bir kabukta kod okuyup yazıp çalıştırabilmesi, ölçülen en büyük etkiydi; daha küçük Gemma 4 bile kazandı.
- Arama stratejisi neredeyse fark etmedi. Dört ağaç arama biçimi (zincir, açgözlü, UCB1, best-of-N) arasında istatistiksel olarak anlamlı fark yoktu. En büyük fark, UCB1 ile best-of-N arasındaki 2,71 yüzdelik puan, aralığı yaklaşık −1,4 ile +6,6.
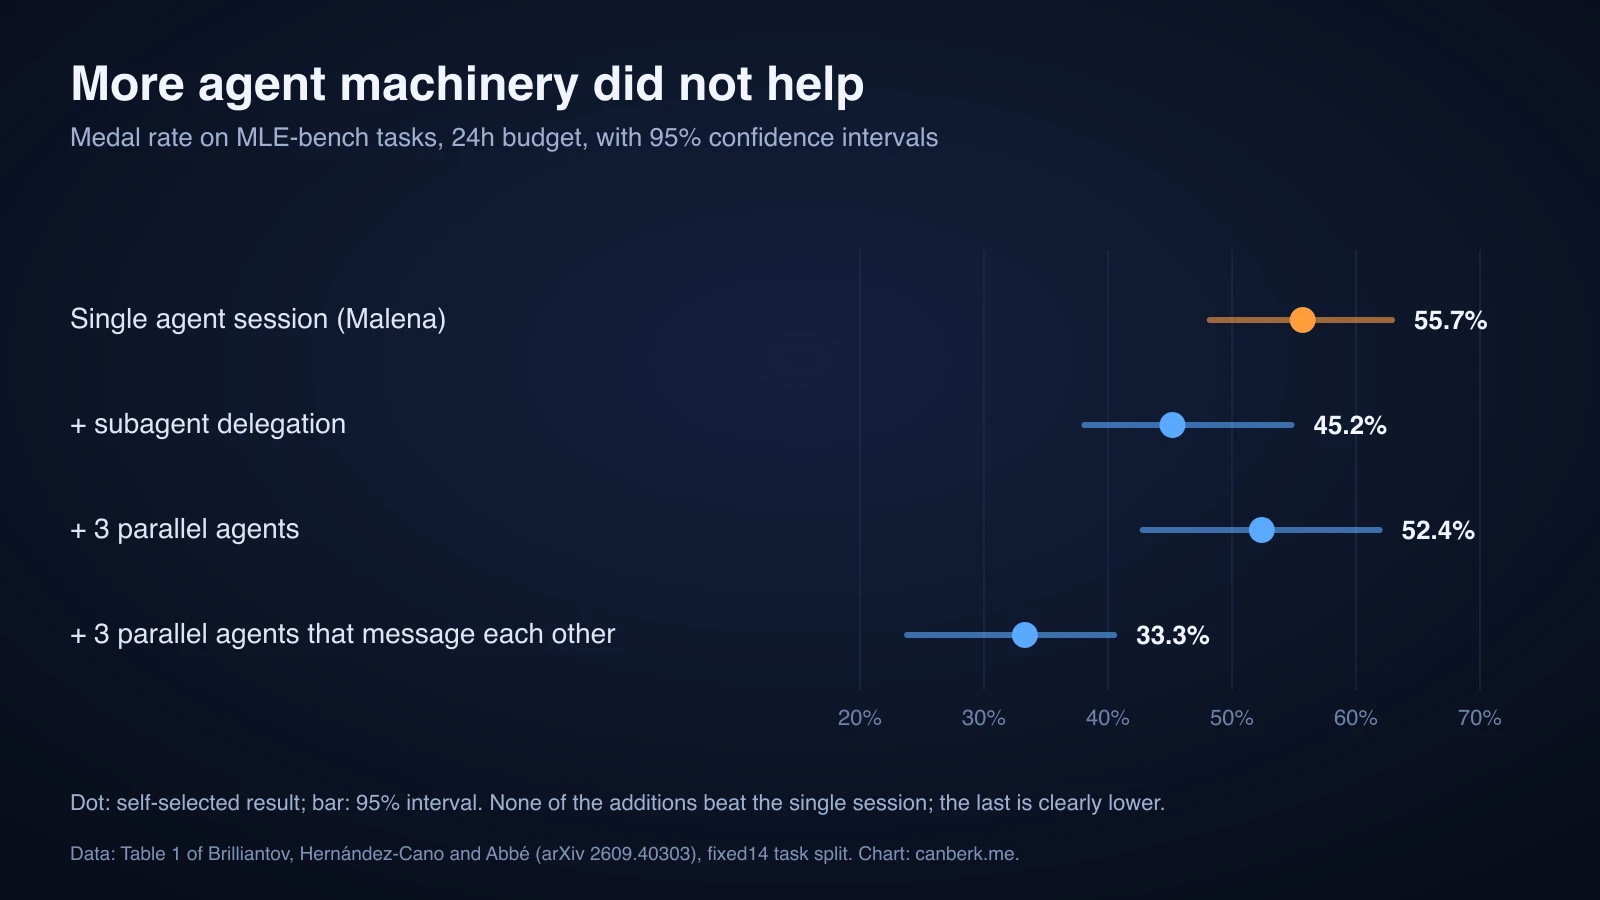
- Daha çok ajan yardımcı olmadı. 14 görevlik bir kümede madalya oranı tek oturumda %55,7, alt ajan devriyle %45,2, üç paralel ajanla %52,4 ve birbirine mesaj atan paralel ajanlarla %33,3’tü (kendi seçtikleri sonuçlar; ilk üçünün aralıkları örtüşüyor).
- Tam harness’lere karşı da dayandı. Yazarlar, tek oturumun denenen her çiftte her harness’e denk geldiğini ya da onu geçtiğini söylüyor. GLM 5.2 ile NatureBench’te yayımlanmış en iyi sonucu geçen görev oranı sade ajanda %21,7, AiScientist’te %17,5, MLEvolve’de %10,8; Kimi K3 ile %26,7, %27,1 ve %11,7. İstisna küçük Gemma 4 modeliydi; orada MLEvolve ortalamada öndeydi, ancak aralıklar örtüştü.
Daha ucuz muydu?
Hayır. Yazarların GLM 5.2 ile modellediği çıkarım maliyeti tek oturum için 12,12 $, AiScientist için 1,95 $ idi; yaklaşık 6,2 kat fazla, çünkü sürekli büyüyen tek oturum bağlamını yeniden gönderiyor ve maliyeti neredeyse tamamen önbellek okuma token’ları belirliyor. 24 saatlik A100 süresinin sağlayıcıya göre 24 ile 85 $ arasında olduğunu da not ediyorlar.
Yazarlar neden çalıştığını düşünüyor?
Ajanların izlerini inceleyip yetenekli bir kodlama ajanının harness’lerin sabit kodladığı aramayı kendi başına yaptığı sonucuna varıyorlar: tek bir genel boru hattı kuruyor, sonra çalışmayı kod yamalarıyla iyileştirerek, kontrol noktalarını ve kodu yeniden kullanarak geçiriyor ve çalışmanın sonuna doğru birleştirme (ensembling) ve sahte etiketleme gibi hilelere kayıyor. Görece nadir teknikleri denemeyi sürdürdüğünü de bildiriyorlar. Bu, izlerin yazarlarca yorumu; mekanizmanın kontrollü bir testi değil.
Sınırları neler?
Yazarlar dört sınır sayıyor: MLE-bench’in bilinen hazırlık sorunları var ve herkese açık Kaggle yarışmalarından türetilmiş, dolayısıyla veri sızıntısı olası (görevleri düzelttiler, sızıntıyı kontrol ettiler ve NatureBench’i eklediler); bazı güven aralıkları etki büyüklüğü hakkında güçlü iddialara izin vermeyecek kadar geniş, yani “daha kötü değil” iddiaları “daha iyi” iddialarından daha iyi desteklenmiş; müdahalelerin çoğu tek işçi içinde çalışıyor, bu yüzden gelişmiş çok ajanlı koordinasyon açık bırakılmış; ve ayar çabası farklı olabilir, çünkü kazanan yazarların kendi sistemi; bunu dış harness’lerdeki hataları ve yapılandırmaları düzelterek dengelemeye çalışmışlar.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Açık ağırlıklı modellerle ML mühendisliği ile ilgili. Sonuçlar Claude, GPT ya da Gemini hakkında ya da gündelik yazılım işi hakkında bir şey söylemiyor; buradaki “harness” ajanın araçları değil, dıştaki orkestrasyon programı.
- “Minimal” de bir harness. Malena, kabuk, dosya sistemi ve üç araçla bir ajan çerçevesi içinde çalışıyor. Bulgu, ek katmanların az şey kattığı; iskelenin gereksiz olduğu değil. Pi gibi minimal harness’lerin yönüyle uyumlu.
- Maliyet önemli. Tek uzun oturuma geçerseniz bağlamı yeniden gönderme faturasına dikkat edin.
Editöryal inceleme: 5 Ekim 2026 (AI). Makalenin tam metni (arXiv 2609.40303, 30 Eylül 2026’da gönderildi; yöntem, sonuçlar, sınırlar ve ek A.4’teki model listesi dahil baştan sona okundu) ve Apple’ın araştırma sayfası (aynı gün okundu; tarihi yalnızca Ekim 2026 olarak veriyor) hazırlanırken kullanıldı. Hiçbir deneyi yeniden çalıştırmadık. Tüm rakamlar yazarlara aittir; grafik, makalenin Tablo 1’inden ürettiğimiz kendi grafiğimizdir. “Akılda tutulacaklar” bölümü bize aittir.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder