Alt ajanlar kodlama ajanlarına yardım ediyor mu? Codex, Claude Code ve Kimi Code'da 2.124 çalıştırma
Bir ön baskı, alt ajanlar açık ve kapalıyken 2.124 kodlama görevi çalıştırdı: Claude Code SWE-bench Verified'da 24 puan kaybetti, token 1,4-3,3 kat arttı.
Bu yazıda
Bir kodlama ajanı kendi kendine alt ajan açmalı mı? Claude Code’un dinamik iş akışları, Codex’in çoklu ajan modu ve Kimi Code’un ajan sürüsü hepsi evet diyor. Han Li, HanHaoNing Li, Ziqian Jiang ve Yiling Lou imzalı yeni bir ön baskı (Nanjing Üniversitesi, Central University of Finance and Economics ve UIUC; arXiv, 7 Ekim) bunu basit bir anahtarla sınıyor: aynı ajan ve aynı model, alt ajanlar açık ve kapalı. Tam metni okuduk; hiçbir şeyi yeniden çalıştırmadık ve sayfada hakem değerlendirmesi durumu yazmıyor. Bu, minimal bir ajanın karmaşık harness’lere denk gelip gelemeyeceğine baktığımız yazının sorusunu genişletiyor.
Ne test ettiler?
Yazarlar, her biri kendi yerel alt ajan özelliğiyle üç ajanı karşılaştırdı: GPT-5.4 ile Codex (multi_agent seçenekleri), Claude Opus 5 ile Claude Code (ultracode ile açılan dinamik iş akışları) ve Kimi K3 ile Kimi Code (swarm_mode). Çiftler Temmuz 2026’da, en yüksek akıl yürütme eforuyla seçildi; sıralı modda alt ajan araçları kapatıldı, yani hiç alt ajan oluşturulamadı. Model, istem, ortam ve zaman bütçesi iki modda aynıydı. Makale yazılım sürüm numarası vermiyor.
Beş benchmark’tan her birinin %20-25’i kadar, toplam 354 görev örneklediler: SWE-bench Verified’dan 100 (kısa, sınırlı hata düzeltmeleri) ve bütün depoları isteyen dört uzun ufuklu set: RepoZero (150 görev), ProgramBench (50), NL2Repo (26) ve LoopsBench (28, sürekli çok adımlı geliştirme). Bu, 2.124 çalıştırma ve yaklaşık 11,2 milyar token, yani standart API tarifeleriyle 20.780,02 $ ediyor.
Alt ajanlar başarı oranını artırdı mı?
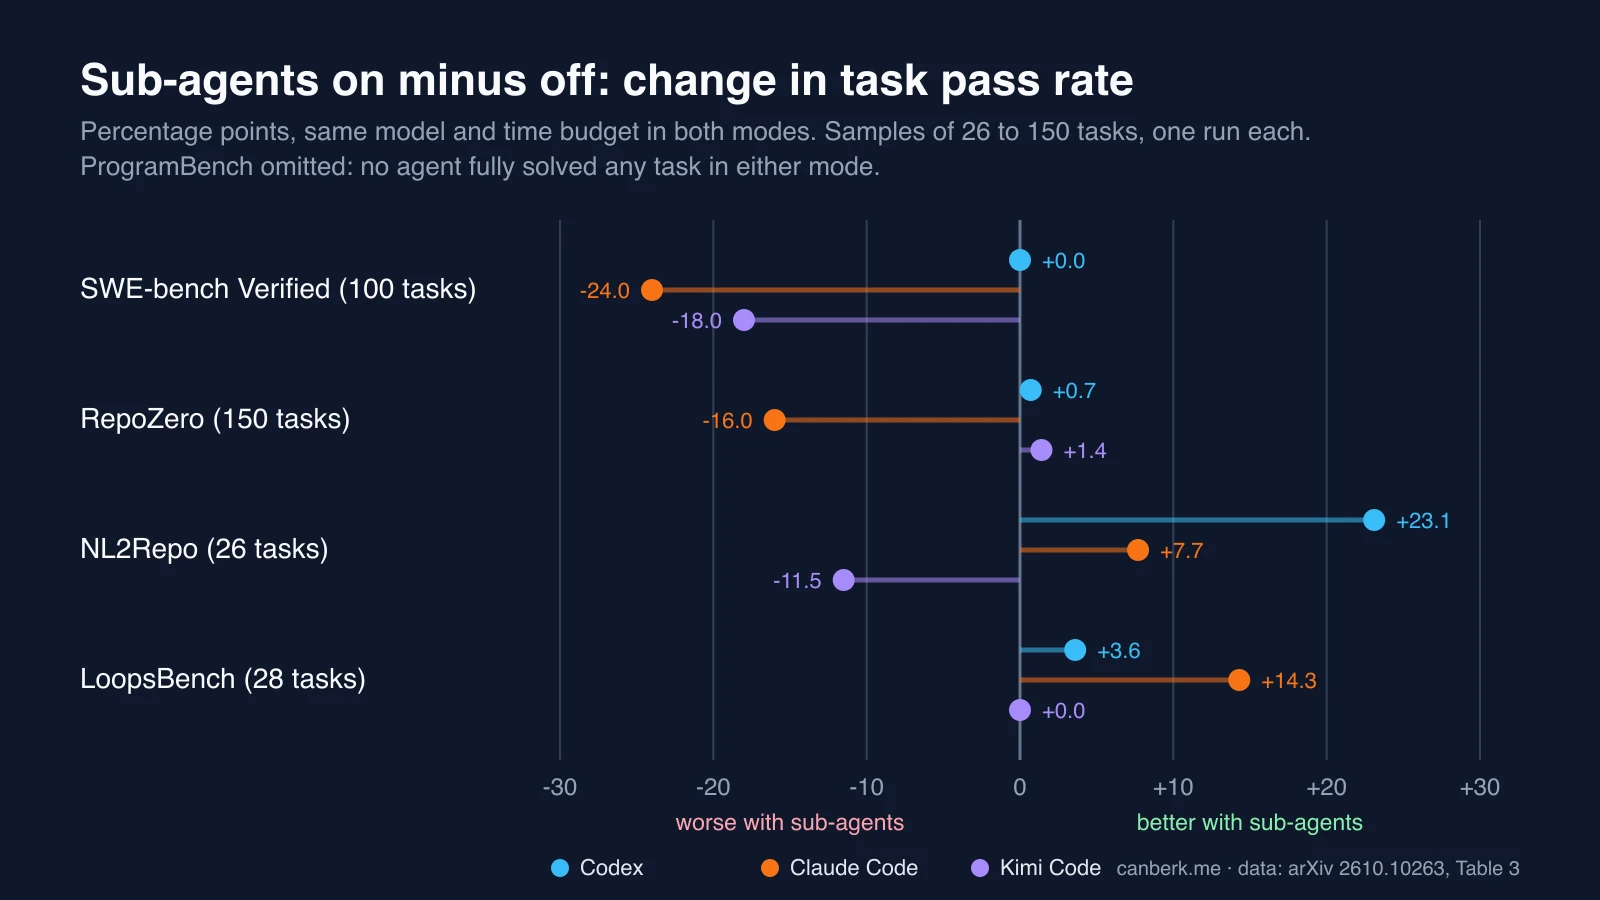
Güvenilir biçimde değil. Tamamen çözülen görevlerin payı, alt ajanlar açık / kapalı:
| Benchmark | Codex | Claude Code | Kimi Code |
|---|---|---|---|
| SWE-bench Verified (100) | 71,0 / 71,0 | 59,0 / 83,0 | 59,0 / 77,0 |
| RepoZero (150) | 40,7 / 40,0 | 26,7 / 42,7 | 38,7 / 37,3 |
| NL2Repo (26) | 57,7 / 34,6 | 65,4 / 57,7 | 46,2 / 57,7 |
| LoopsBench (28) | 25,0 / 21,4 | 21,4 / 7,1 | 25,0 / 25,0 |
Hiçbir ajan ProgramBench’te iki modda da tek bir görevi tamamen çözemedi; yine de alt ajanlar Codex ve Kimi Code için geçen test payını artırdı.
- Örüntü görev uzunluğuna bağlı. En büyük kazanç en uzun görevlerin olduğu LoopsBench’teydi. Üç ajanın ortalamasında test geçme farkı RepoZero’da −8,3 puandan NL2Repo’da −0,04’e, ProgramBench’te +1,2’ye ve LoopsBench’te +4,3’e çıktı; yani beklenen çıktı büyüdükçe eşzamanlılığın sonucu iyileşti.
- Kısa görevler kötüleşti. SWE-bench Verified’da Claude Code 24, Kimi Code 18 puan kaybetti; Codex değişmedi.
- İstatistik. Uzun ve kısa görevleri birleştirince yazarlar, Claude Code’un düşüşünün (p ≈ 5×10⁻⁷) ve Kimi Code’un düşüşünün (p ≈ 0,013) istatistiksel olarak anlamlı, Codex’in küçük kazancının (p ≈ 0,23) ise anlamlı olmadığını bildiriyor.
- Küçük örnekler. Claude Code’un LoopsBench’teki %7,1’den %21,4’e çıkışı, iki göreve karşı altı görev demek; yazarlar yalnızca alt ajanlarla çözülen dört görev sayıyor. NL2Repo’daki dalgalanmalar 26 göreve dayanıyor.
- Alt ajanlar bazen sıralı koşuların çözemediğini çözüyor. Ajan-benchmark çiftlerinin çoğunda, ortalama iyileşmese bile yalnızca eşzamanlı modda çözülen bazı görevler vardı.
Maliyeti ne oldu?
| Codex | Claude Code | Kimi Code | |
|---|---|---|---|
| Görev başına token, SWE-bench Verified (M), açık / kapalı | 3,37 / 1,34 | 2,14 / 1,02 | 1,01 / 0,98 |
| Görev başına token, LoopsBench (M), açık / kapalı | 51,65 / 11,45 | 21,73 / 15,52 | 41,49 / 11,29 |
- Token: ajanlara göre sıralı düzeyin 1,41-3,31 katı. Başarısız çalıştırmaları çözülen görevlere böldüğünüzde, Codex alt ajanlarla çözülen görev başına 24,12 milyon, alt ajansız 7,69 milyon token kullandı.
- Süre: paralel çalışma ortalamada çalıştırmaları hızlandırmadı. 15 ajan-benchmark çiftinin 14’ünde süre uzadı; Claude Code SWE-bench Verified görevi başına alt ajanlarla 27,8, alt ajansız 17,5 dakika sürdü.
- Zaman kazandığı durumlar: iki modda da çözülen 366 görevin 102’sinde (%27,9) eşzamanlı mod daha hızlıydı, 46’sında (%12,6) en az %20 daha hızlıydı.
Ajanlar nasıl görev dağıtıyor?
Alt ajan sayısı zorlukla arttı: kolay görev başına ortalama 6,69, orta görevde 7,53, zor görevde 15,84 alt ajan oluşturuldu. En zor LoopsBench görevlerinde Claude Code görev başına 133,69, Kimi Code 67,00 alt ajan oluşturdu; Codex küçük gruplar tuttu (ortalama tepe değerleri 1,21-3,00). Codex dağıtıma en erken başladı, çalıştırmanın medyan %4,0’ında (Claude Code %22,1, Kimi Code %26,0), ama çalıştırmalarının %24,3’ünde oluşturduğu alt ajanlar hiç birbirine çakışmadı. En uzun süreli çakışmayı Claude Code sürdürdü, çalıştırmanın medyan %52,7’sinde.
Neden başarısız oldu?
Ekip, eşzamanlı 1.062 çalıştırmanın hepsini elle etiketledi, her biri üç etiketleyiciden ikisi tarafından (Cohen κ = 0,77) ve 650’sinde, toplam 804 örnekte hata buldu. Sınıflandırmaları dört kategori, 13 alt kategori ve 28 örüntüden oluşuyor:
- Ortak durum ve birleştirme, %33,2: çoğunlukla eşzamanlı yazmalar; örneğin bir ajanın başkasının teslimini ezmesi (120 vaka).
- Yürütme yönetişimi, %29,0: sonuçların yanlış zamanda gelmesi, çoğunlukla alt ajanların bitmeden sonlandırılması (128 vaka).
- Görev orkestrasyonu, %28,5: yük dengesizliği, esas olarak zaman bütçesini tüketen dallanma (154 vaka).
- Global bağlam, %9,3: alt ajanların eksik yönlendirilmesi ya da doğrulanmadan bitmiş ilan edilen iş.
Makaledeki bir örnek: Kimi Code, seqtk aracının yeniden inşasını 40 dakikalık bütçede 20 alt ajana böldü, iki saatlik bir zaman aşımı varsaydı ve tüm grubu bekledi; birleştirme hiç yapılmadı ve program 440 testin 92’sini geçti.
Ne zaman işe yaradı?
Eşzamanlılığın kazandığı 131 çifte bakan yazarlar üç koşul buldu: tamamlayıcı iş, örneğin sekiz alt ajan dosyaları ve kontrolleri yaparken ana ajanın çekirdek algoritmayı yazması (bir Kimi Code vakasında 734 saniye 468’e indi); alternatif denemeler, yani iki inşanın karşılaştırılıp birleştirilmesi (Codex 391 testin 292’sini geçti, sıralı modda 0); ve bağımsız doğrulama, yani bir alt ajanın bulgusunun ana ajanı düzeltmesi. Eşzamanlılığı seçici, yani zor, uzun ve bölünebilir görevlerde açmayı ve maliyetle tartmayı öneriyorlar.
Sınırlar neler?
Yazarlar kendileri sıralıyor: sonuçlar üç ajan ve beş benchmark ile sınırlı; çalıştırmalar rastgele ve maliyet yüzünden her koşul bir kez çalıştırıldı, ama LoopsBench’teki sıralı Codex sayıları o benchmark için ilk bildirilenlere yakın; elle etiketleme öznel olabilir. Yörüngeleri, kod kitabını ve betikleri GitHub’da yayımladılar; biz incelemedik.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Tek bir andaki varsayılanları ölçüyor. Ajan ve model çiftleri Temmuz 2026’dan, araçlar hızla değişiyor; bunu bir ürün sıralaması değil, anlık görüntü olarak okuyun.
- Tek bir ajan hakkında hüküm değil. Claude Code’un büyük düşüşü, koşul başına tek çalıştırmayla 100 görevlik sınırlı bir örnekte; aynı ajan en uzun görevlerde kazandı.
- Günlük kullanımda en net sinyal maliyet tarafı. Başarı korunsa bile token kullanımı birkaç kat arttı. Eşzamanlılığın uzun ve bölünebilir işte işe yarayıp küçük düzeltmelerde yaramaması, EPFL ve Apple çalışmasının paralel ajanlarla gördüğüyle uyumlu, ama görevler ve modeller farklı. Alt ajan özellikleri ayrıca kodlama ajanı güvenlik benchmark’larının incelediği yüzeyi genişletiyor.
Editoryal inceleme: 8 Ekim 2026 (YZ). arXiv 2610.10263’ün (v1, 7 Ekim) tam metninden hazırlandı; HTML sürümü, tablolar, sınıflandırma, fayda analizi ve geçerlilik tehditleri dahil okundu. Hiçbir deneyi yeniden çalıştırmadık, yayımlanan veriyi incelemedik, ajanları kendimiz test etmedik. Tüm rakamlar yazarlara aittir; grafik bize ait ve Tablo 3’ten hazırlandı. “Akılda tutulacaklar” bizim.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder