DeepInfer: DeepSeek, V4.1 Flash çıkarım motorunu açık kaynak yaptı
DeepSeek, V4.1 Flash'ın arkasındaki DeepInfer motorunu Apache-2.0 ile açtı. Neler var, neler eksik ve günde 155 trilyon token iddiası.
Bu yazıda
DeepSeek, V4.1 Flash’ı üretimde çalıştırdığını söylediği motoru açık kaynak yaptı. Adı DeepInfer, Apache-2.0 lisanslı ve hem NVIDIA hem Huawei donanımında çalışıyor. Ama depo tüm servis sistemini değil çıkarım çekirdeğini sunuyor ve DeepSeek’in kendi kümesine dair rakamlar kendi iddiaları. README’yi ve depodaki dağıtım Q&A belgesini GitHub API üzerinden okuduk. Bu yazı bugün neyi çalıştırabileceğinizi, DeepSeek’in neyi elinde tuttuğunu ve hangi iddiaların bağımsız doğrulanamadığını anlatıyor.
DeepInfer nedir?
DeepSeek modelleri için büyük ölçekli bir çıkarım çatısı; Apache-2.0 ile GitHub’da yayımlandı. README onu “DeepSeek’in büyük ölçekli üretim hizmetlerine güç veren yüksek performanslı çıkarım çatısı” olarak tanımlıyor ve bu sürümün büyük ölçekte servis için gereken çekirdek özelliklerle çevrimdışı çıkarım sunduğunu söylüyor. GitHub’a göre depo 16 Ekim’de oluşturulmuş ve ilk herkese açık commit 20 Ekim’de (04:09 UTC) gelmiş. Çok yeni bir sürüm: okuduğumuzda commit geçmişinde üç commit vardı, etiketli sürüm ve katkıcı listesi yoktu. Teşekkür bölümüne göre öncelikle vLLM üzerine kurulmuş, SGLang ve TensorRT-LLM’den esinlenmiş.
Bugün neyi çalıştırabilirsiniz?
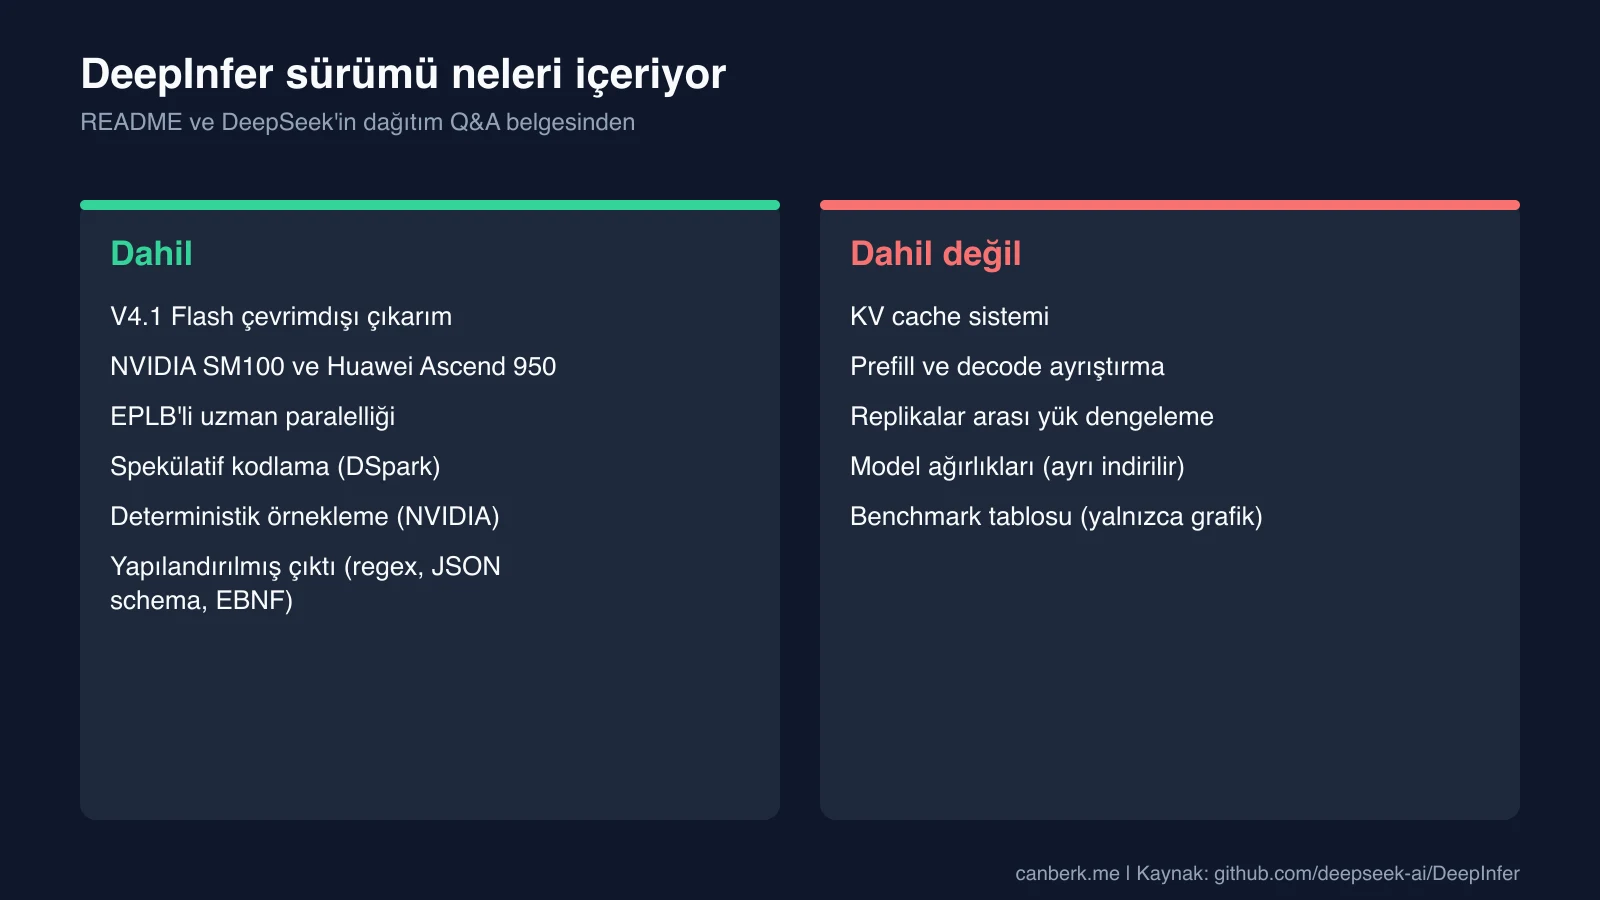
İki tür hızlandırıcıda DeepSeek-V4.1-Flash için çevrimdışı çıkarım. Desteklenen model V4.1 Flash; varsayılan checkpoint deepseek-ai/DeepSeek-V4.1-Flash-1017, ilk çalıştırmada Hugging Face’ten indiriliyor. Desteklenen donanım NVIDIA SM100 GPU’lar ve Huawei Ascend 950 NPU’lar. Derlemek için Linux, GCC 13 veya üstü, Python 3.12 ve NVIDIA’da CUDA 13, Ascend’de CANN 9.2 gerekiyor. Listelenen özellikler:
- Çekirdekler ve çalışma zamanı: optimize çekirdekler, model ve örnekleyici çalışma zamanı; entegrasyon olarak FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect ve özel TileLang çekirdekleri.
- Paralellik: dengeli bağlam paralelliğiyle attention veri paralelliği ve uzman yük dengelemeli (EPLB) MoE uzman paralelliği.
- Kodlama: DSpark ve güven puanlı doğrulama (varsayılan en fazla taslak uzunluğu 5) ve decoder prefill işini azaltan “SWA bounded replay”.
- Zamanlama: varsayılan olarak açık asenkron zamanlama.
- Tekrarlanabilirlik: yalnızca NVIDIA’da batch-invariant çıkarım ve deterministik örnekleme.
- Yapılandırılmış çıktı: üretimi regex, JSON schema veya EBNF gramerine kısıtlama.
DeepSeek ayrıca eşlik eden bir proje olan deepseek-recipe’i (üretim düzeyinde bir token kodlama ve çözme bileşeni) açtığını söylüyor. Biz onu açmadık.
Neler dahil değil?
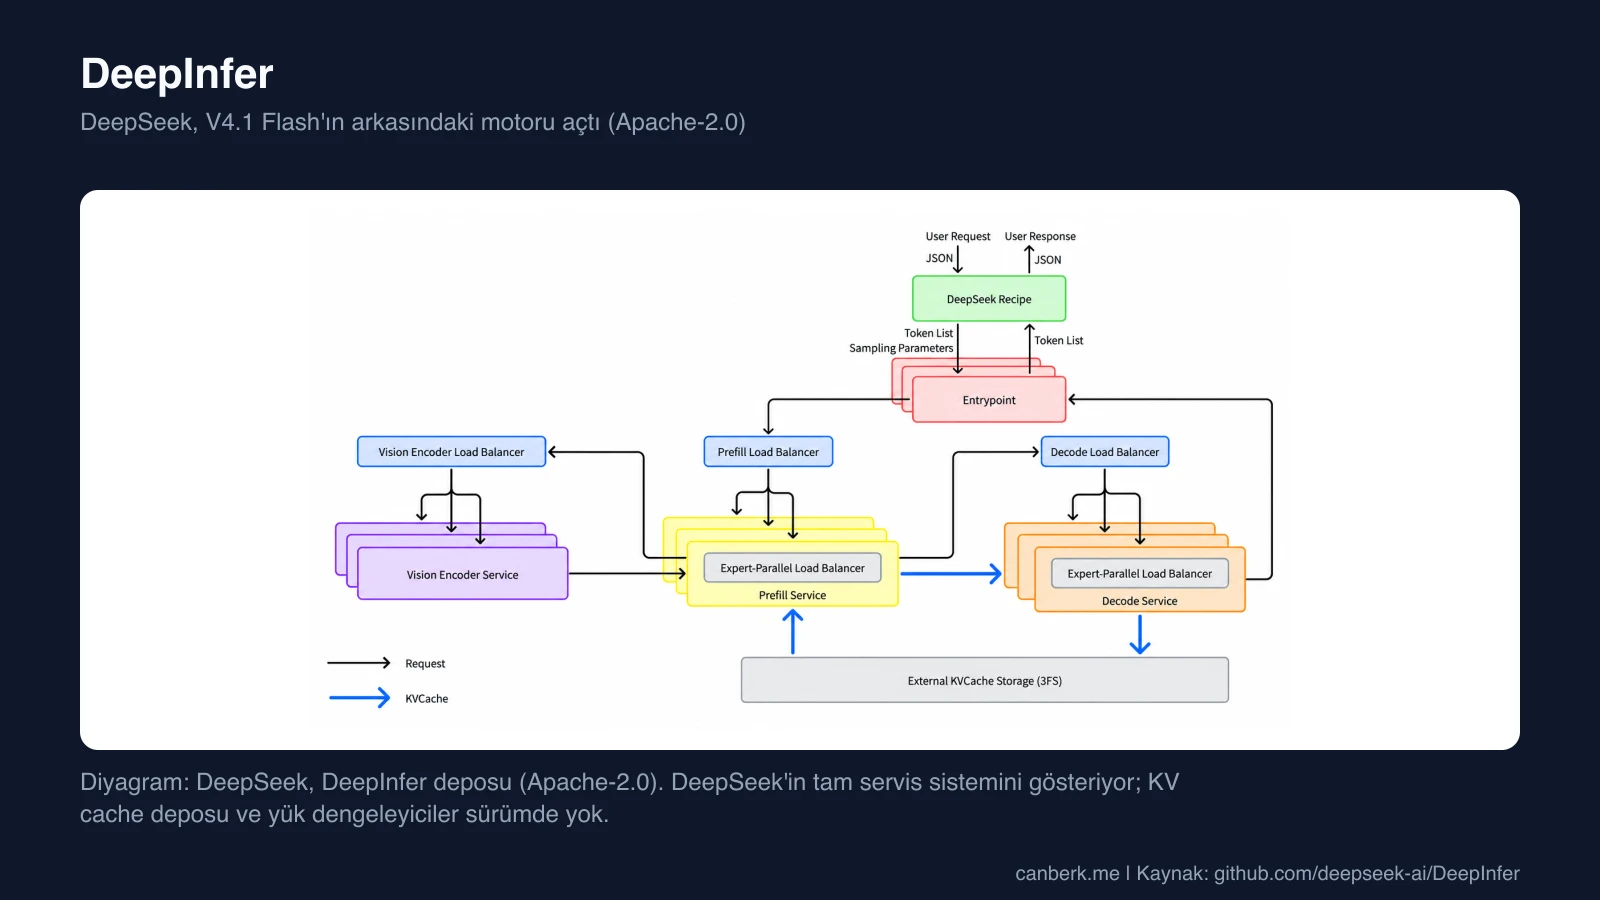
Bir motoru servise dönüştüren parçalar. README, “eksiksiz bir çıkarım servisi için gerekli” olup bu sürümde bulunmayan üç şey sayıyor: bir KV cache sistemi, prefill ve decode (ve vision encoder) ayrıştırması ve hem prefill hem decode için veri paralel replikalar arası yük dengeleme. Q&A, ayrıştırma için “gereken motor işlevselliğinin çoğunun zaten uygulandığını” ve KV cache yönetimi ile yük dengeleme bileşenlerinin “iç altyapımıza sıkı sıkıya bağlı” olduğunu ve henüz tam açılmadığını ekliyor. Model ağırlıkları ayrı ve ilk çalıştırmada indiriliyor.
DeepSeek sisteminin nasıl çalıştığını söylüyor?
Geniş uzman paralelli bir decode aşamasıyla ayrıştırılmış bir tasarım olarak. Q&A üç hedef belirtiyor: birden çok satıcının hızlandırıcılarını desteklemek, prefill ve decode’u sıradan donanım etrafında düzenlemek ve KV cache’i 72 saatten uzun tutmak. Anlattıkları:
- Prefill EP2-EP8 ile sıradan 8 GPU’luk makinelerde, decode EP64-EP128 ile 64 ila 128 GPU’luk süpernodlarda. En küçük verimli dağıtım biriminin 64 prefill GPU’su artı 64 decode GPU’su olduğunu söylüyor.
- Yaklaşık 100 PiB SSD’lik özel bir 3FS depolama kümesinde bir KV cache deposu; ajan trafiği için üç gün, chatbot trafiği için yedi gün yaşam süresi ve yaklaşık üç günde chatbot trafiği için cache isabet oranında %0,5 ile %1 kayıp.
- Mükemmel dengelenmiş bir çevrimdışı benchmark’ın yaklaşık %80’ine ulaştığını söylediği yük dengeleme.
- Örnek başına tek GPU’luk vision encoder ile çok kipli bir yol.
Bunlar DeepSeek’in kendi sistemine dair anlatımları. Anlattığı parçaların çoğu sürümde olmayanlar.
Günde 155 trilyon token nedir?
DeepSeek’in kendi kümesine dair iddiası. Q&A, tek bir kümenin şu an “günde 155 trilyon token sunduğunu ve (vadi fiyatlandırmasıyla) GPU-saati başına 38 ABD doları toplam gelir elde ettiğini” söylüyor. Küme boyutunu, token karışımını veya vadi fiyatlandırmasının ne olduğunu vermiyor. İki rakamı da kontrol edemiyoruz. Deponun performans bölümü prefill (4 SM100 GPU’da ölçülmüş) ve decode (64 GPU) için Pareto grafikleri ve bunları yeniden üretmek için bir tarama betiği gösteriyor ama rakam tablosu yok ve grafiklerden kesin değerleri okuyamadık.
Hâlâ bilinmeyenler neler?
- Açık sürümün üretimle eşleşip eşleşmediği. README çatının üretime güç verdiğini söylüyor ama eksik bileşenler üretim servisinin dayandığı şeyler.
- Ne kadar hızlı olduğu. Grafikler tek performans kanıtı ve burada hiçbiri bağımsız değil.
- Hangi diğer modelleri destekleyeceği. Yalnızca V4.1 Flash listeleniyor.
- DeepSeek’in KV cache ve yük dengeleme kodunu açıp açmayacağı. Q&A “henüz tam açılmadı” diyor ve tarih vermiyor.
- Model adı ile checkpoint’in ilişkisi. README “DeepSeek-V4.1-Flash”ı “-1017” varsayılan checkpoint’iyle listeliyor ve adlandırmayı açıklamıyor.
Akılda tutulması gerekenler
Bunlar bizim gözlemlerimiz:
- Bu bir motor, servis yığını değil. Modeli DeepSeek’in çekirdekleriyle çalıştırabilirsiniz. Anlatılan üretim kümesini yalnızca bu depodan yeniden kuramazsınız.
- Ascend desteği hikâyenin parçası. Çinli bir laboratuvarın hem Huawei Ascend 950 hem NVIDIA için çıkarım kodu yayımlaması dikkat çekici ve ABD İç Güvenlik Bakanlığı’nın DeepSeek ürünlerini federal sivil BT’den çıkaran bir emri kamuya açtığı hafta geliyor.
- Lisansı kendi kullanımınıza göre kontrol edin. Kod Apache-2.0. Model ağırlıkları kendi lisansına tabi; burada onu incelemedik.
- Diğer DeepSeek yazılarımızı tamamlıyor. V4.1-Flash-1017 sürümüne ve DeepSeek harness’ına bakın.
Editoryal inceleme: 20 Ekim 2026 (AI). DeepInfer deposunun README’si ve dağıtım Q&A belgesi (ikisi de GitHub API ile okundu) ile deponun oluşturma ve commit tarihleri (GitHub API) üzerinden hazırlandı. Q&A’daki bazı uzun pasajlar okumamızda kısaltılmıştı. DeepInfer’i derlemedik veya çalıştırmadık, deepseek-recipe projesini açmadık, Q&A’nın bağladığı Zhihu yazısını okumadık ve hiçbir rakamı doğrulamadık. Açık sürümü DeepSeek’in barındırılan hizmetiyle karşılaştırmadık.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder