Gemini 3.8 TTS: özel sesler, diyalog kontrolü ve önemli API ayrıntıları
Google'ın Flash ve Flash-Lite TTS modelleri: resmî ses demoları, benchmark grafikleri, erişim bilgileri ve entegrasyonda dikkat edilecek sınırlar.
Bu yazıda
Google, Gemini 3.8 Flash TTS ve Flash-Lite TTS modellerini 23 Eylül’de duyurdu. İkisi de yazılı metni yönlendirilebilir konuşmaya dönüştürüyor; Flash etkileyici ses tasarımına, Flash-Lite ise yüksek hacim ve verimliliğe odaklanıyor. Gemini API ve AI Studio üzerinden erişim açılmaya başlıyor. Kurumsal API erişimi duyuruda daha sonraya bırakılmış.
Bir yayıncı, oyun stüdyosu veya destek uygulaması için önemli soru, kısa demodaki kontrolün gerçek işte ne kadar korunduğu. Ses karakterini sürdürebiliyor mu, kritik kelimeleri doğru okuyabiliyor mu, tek bir cümleyi değiştirmek bütün kaydı yenilemeyi gerektiriyor mu?
Hangi model, hangi iş için?
| Model | Google’ın konumlandırması | Bizim önerdiğimiz ilk deneme |
|---|---|---|
| Gemini 3.8 Flash TTS | Karakter sesleri, etkileyici performans ve devam eden diyalog | Duygusu değişen, iki karakterin tekrar konuştuğu bir sahne |
| Gemini 3.8 Flash-Lite TTS | Maliyet ve hıza odaklanan yüksek hacimli ses üretimi | İsim, sayı ve tekrar eden terimler içeren kısa açıklamalar |
Flash model belgesi, metin alıp ses üreten; function calling veya Live API desteği bulunmayan bir model tarif ediyor. Flash-Lite belgesi ise daha hafif seçeneği açıklıyor. Bunlar konuşma üretim bileşenleri; sohbet uygulamasında gelen sesi işleme, karar verme ve araç çalıştırma adımları ayrıca kurulmalı.
Resmî örnekleri dinleyin
Aşağıdaki videolar Google’ın özgün demoları. İlki belirgin bir karakter sesini gösteriyor; ikincisinde metinle seslendirmeyi birlikte takip etmek mümkün. Dinlemek için oynat düğmesine basın; videolar otomatik başlamıyor.
Ses tarifinden bir sahneye
Google, ses tasarımını, metindeki yönlendirmeleri ve seslendirmeyi birlikte gösteren kısa bir dedektif videosu da paylaşıyor. Yazılı performans tarifini çıkan sesle karşılaştırabilirsiniz. Bu, bizim ürettiğimiz bir kayıt değil; resmî demo.
API tarafında ne değişiyor?
Üretim rehberi, okunacak kelimelerle performans yönlendirmesini ayırıyor. Konuşma turunun üslubu speech_metadata alanına, kısa tepkiler ve duraklamalar metin içindeki etiketlere yazılıyor. Tek yanıtlı istekler varsayılan olarak WAV döndürüyor; eski entegrasyonunuz ayrıca WAV başlığı ekliyorsa bu ayrıntı önemli.
Diyalogda da pratik bir sınır var: belgelenen tek istekte iki konuşmacı akışı hazır sesleri kullanıyor. Özel tasarlanan veya çoğaltılan seslerde rehber, her konuşma turunu ayrı üretip sesleri birleştirmeyi anlatıyor. İki karakterli bir ürün demosu görmek, gereken API entegrasyonunu tek başına açıklamıyor.
Benchmark grafiklerini nasıl okumalı?
Google’ın duyurusunda Hume AI kalite ve ses tasarımı sonuçlarıyla Voice Arena karşılaştırmaları bulunuyor. Aşağıdakiler büyütülebilen özgün grafikler; yeniden çizmedik ve ölçümleri kendimiz tekrarlamadık.
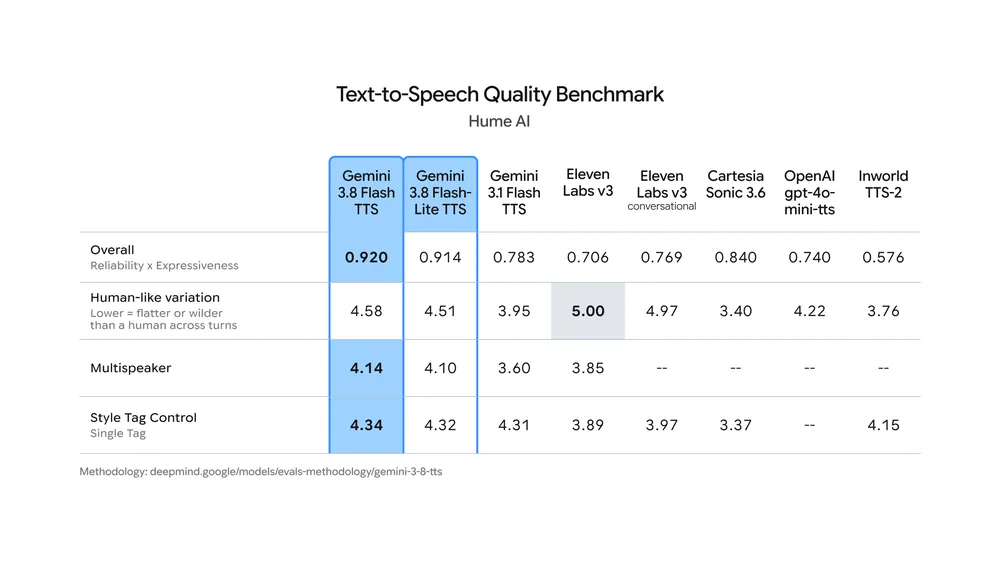
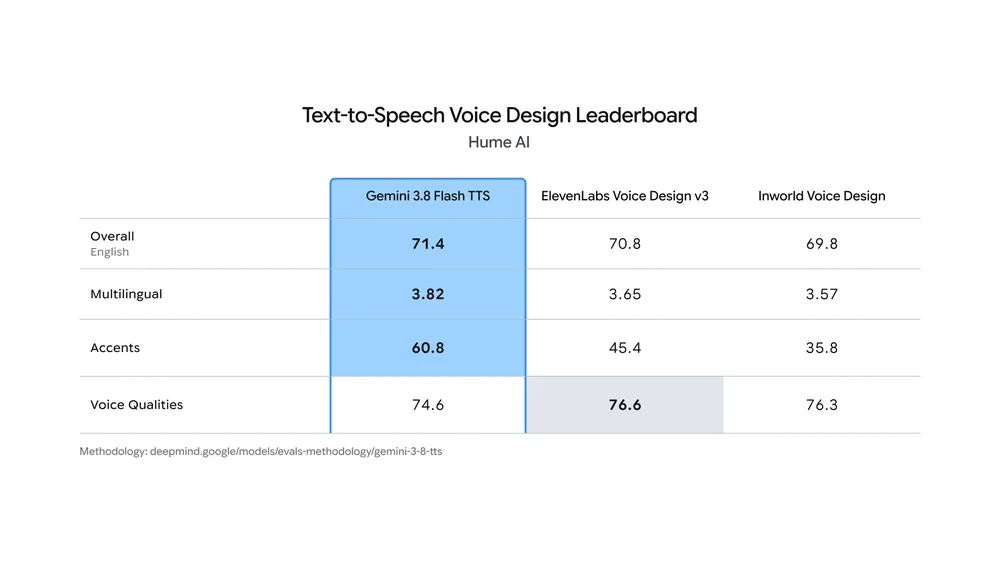
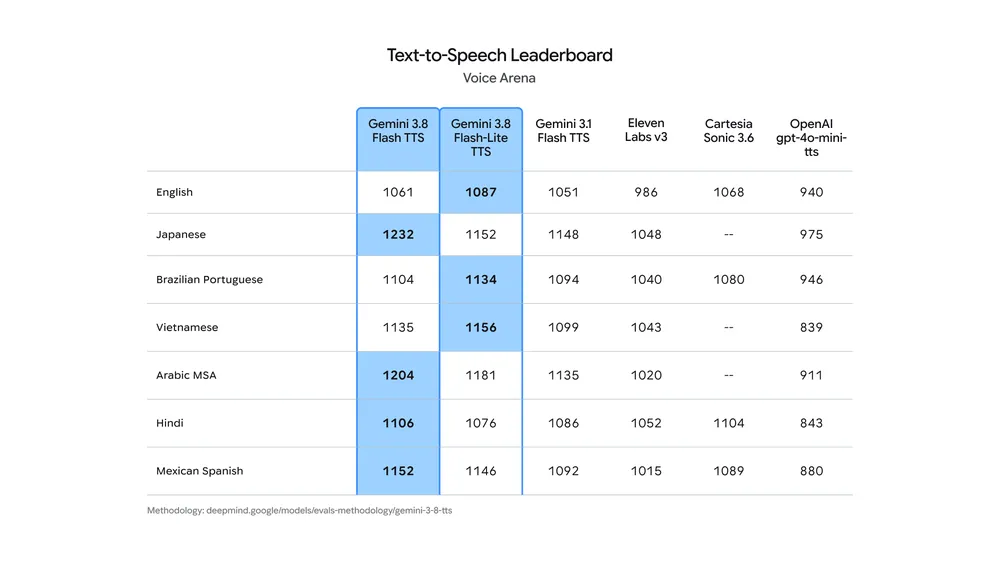
Bizim çıkarımımız: sıralama görev ve dile göre değişiyor; tek bir birincilik her proje için model seçimini belirlememeli. Görünen dil karşılaştırması Türkçe performansını kanıtlamıyor. Bu sitenin iki dilli kullanımı için Türkçe özel adları, Türkçe cümledeki İngilizce ürün isimlerini, tarihleri, kısaltmaları ve uzun metinleri ayrıca denerdik.
Ses çoğaltmada onay, yayında editör kontrolü
Google’ın ses çoğaltma belgesi, referans kaydı ve aynı kişiye ait onay kaydını tarif ediyor. Erişim bölgeye de bağlı; kullanılacak hesap ve dağıtım için güncel koşullar kontrol edilmeli. Duyuru SynthID işaretlemesini açıklıyor, voice remixing özelliğini ise ileride gelecekler arasında gösteriyor.
Aşağıdaki ekran kaydı AI Studio’daki ses çoğaltma akışını gösteriyor. Arayüzü takip etmek için yararlı; yukarıdaki onay ve erişim koşulları bu akışta da geçerli.
Model kartı, genel model hatalarının yanı sıra yavaşlama ve zaman aşımı olasılığını da belirtiyor. Üretim sürecinde telaffuz kontrolü, yeniden deneme yönetimi ve başarısız üretimler dahil kabul edilen kayıt başına maliyet ölçümü gerekir.
canberk.me için anlamlı deneme, kısa bir TR/EN haber özeti olurdu. Önce metne sadakati ve tutarlı telaffuzu dinler, ardından düzenleme süresiyle maliyeti karşılaştırırdık. Bu yazı için bağımsız ses üretim testi yapılmadı; yukarıdaki video ve grafikler resmî duyuruya ait.
Kaynaklar
- Gemini 3.8 text-to-speech — launch announcement, 23 September 2026 ↗Google
- Text-to-speech generation: API workflow and limitations ↗Google AI for Developers
- Gemini 3.8 Flash TTS model reference ↗Google AI for Developers
- Gemini 3.8 Flash-Lite TTS model reference ↗Google AI for Developers
- Voice replication: consent and API workflow ↗Google AI for Developers
- Gemini 3.8 Audio model card ↗Google DeepMind
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder