Google'ın tutarlı uzun videolar için dört parçalı araştırma yolu
Co-Director, CANVAS, A²RD ve VQQA yapay zekâ ile video anlatısındaki farklı hataları hedefliyor. On dakikalık demo ve araştırma ölçümleri ne gösteriyor?
Bu yazıda
Bir sahneden ötekine geçince karakterin paltosu değişiyor. Hikâye aynı odaya döndüğünde yerleşim artık tutmuyor. Sonraki klip parlak görünüyor ama olayları ilerletmiyor. Güzel kısa yapay zekâ videolarını uzun bir filme dönüştürürken yaşanabilecek sorunlar bunlar. Google, 24 Eylül 2026 tarihli araştırma yazısında farklı noktalara müdahale eden dört çalışmayı birlikte ele alıyor: Co-Director, CANVAS, A²RD ve VQQA.
Duyuru, daha önce yayımlanmış makalelerin bir araştırma özeti. Sayfada bu birleşik iş akışı için herkese açık bir kurgu aracı, API, model sürümü veya erişim programı ilan edilmiyor. Google on dakikalık bir film gösteriyor; bu süreye ulaşılması, kendi başına insan müdahalesi olmadan uzun metraj üretilebildiğini kanıtlamıyor.
Tek üretim sürecinde dört ayrı görev
| Araştırma sistemi | Ele aldığı soru | Araştırmacıların anlattığı yöntem |
|---|---|---|
| Co-Director | Bütün sahneler hangi yaratıcı yönde ilerlemeli? | Bir orkestratör anlatı stratejisini, yapıyı ve estetiği dener; uzmanlaşmış ajanlar filmi kurar, çok modlu bir değerlendirici geri bildirim verir. |
| CANVAS | Bir sahneye dönüldüğünde görsel olarak ne aynı kalmalı? | Sahne planı; karakter, mekân ve nesneleri kalıcı görsel dayanaklarla izler. |
| A²RD | Film, geçmişini kaybetmeden bölüm bölüm nasıl uzatılır? | Video belleği bir geri çağır–üret–iyileştir–güncelle döngüsünü destekler; sistem ilerleme ile önceki görünüme bağlanma arasında geçiş yapar. |
| VQQA | Yanlış ayrıntı nasıl bulunup iyileştirilebilir? | Görsel sorular sözel geri bildirim üretir; yenilenen istemler yeni adaylar çıkarır ve genel bir seçici bunları ilk istekle karşılaştırır. |
Bu ayrım önemli, çünkü “tutarlılık” tek bir puan değil. Yüz aynı kalırken aksesuar değişebilir, bir odanın geometrisi kayabilir veya anlatı kendini tekrar edebilir. Sistemler farklı hata türlerine odaklanıyor. Google bunları bir araştırma bütünü olarak sunuyor; dört makalenin tek bir kurulabilir, uçtan uca paket olarak yayımlandığını göstermiyor.
Plan, bellek ve geri bildirim döngüsü
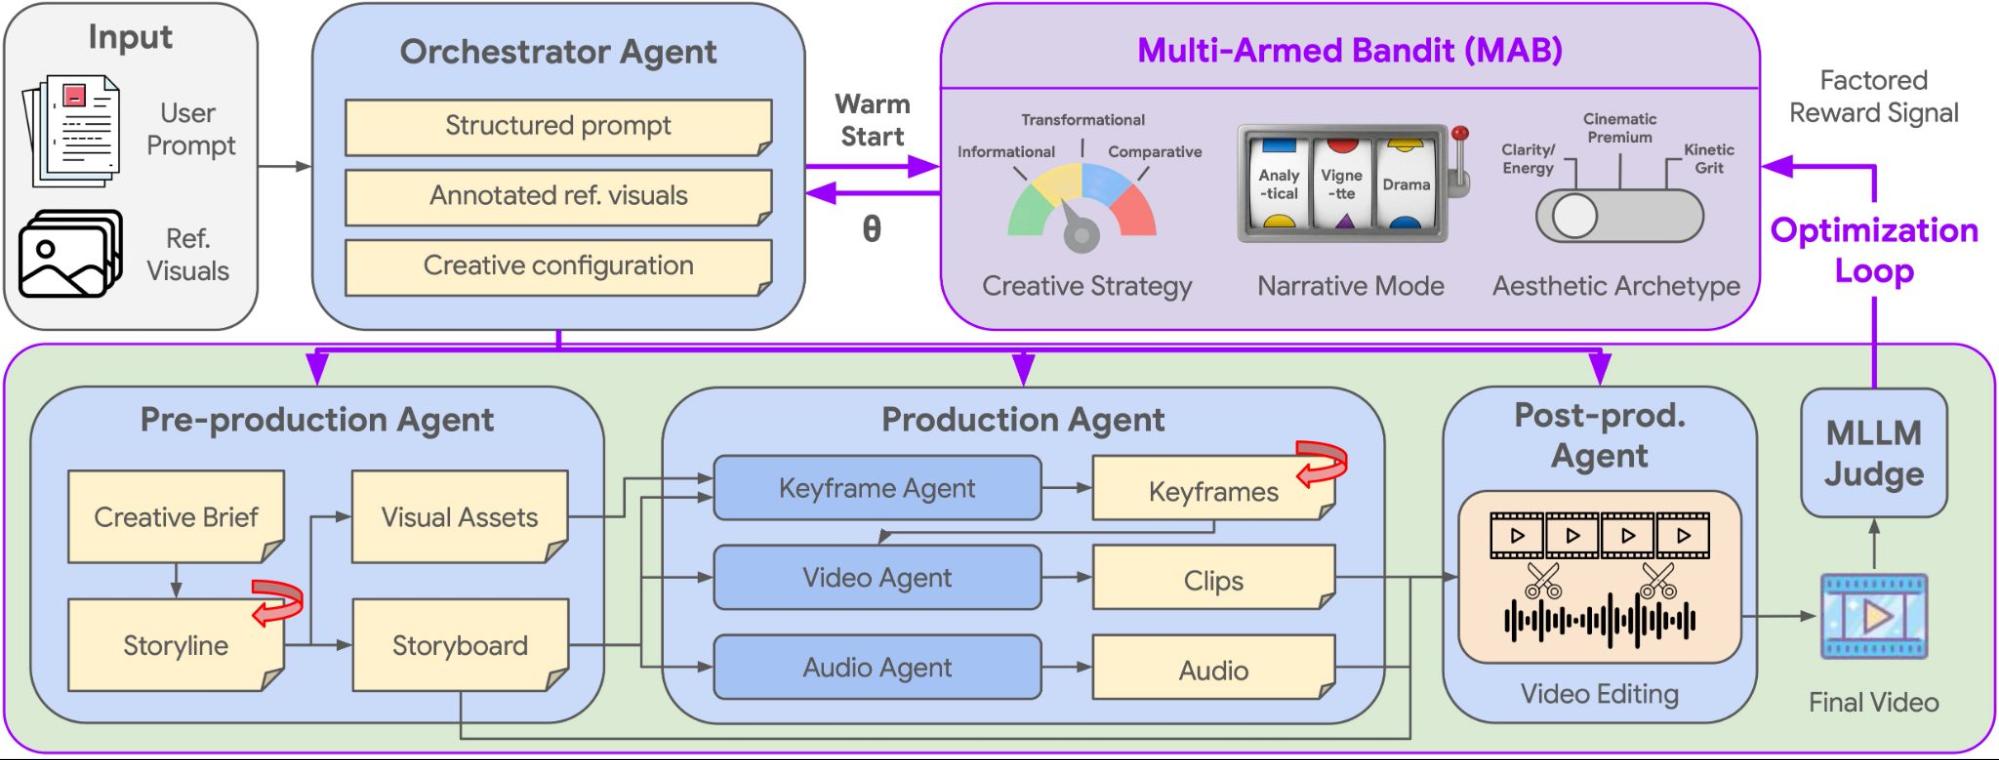
Co-Director, üst düzey yaratıcı düzenler arasında seçim yapan bir orkestratör kullanıyor. Ön yapım ajanı özeti hikâyeye ve sahne planına çeviriyor; yapım ajanları ana kareleri, hareketli görüntüleri ve sesi hazırlıyor. Çok modlu değerlendirici, birleştirilen sonucu inceleyip sonraki arama turuna yön veriyor. Google’ın açıklamasında temel üretim Gemini ve Veo ile yapılıyor. Ajan sistemi bu modelleri yönetiyor; tek başına yeni bir temel video modeli değil.
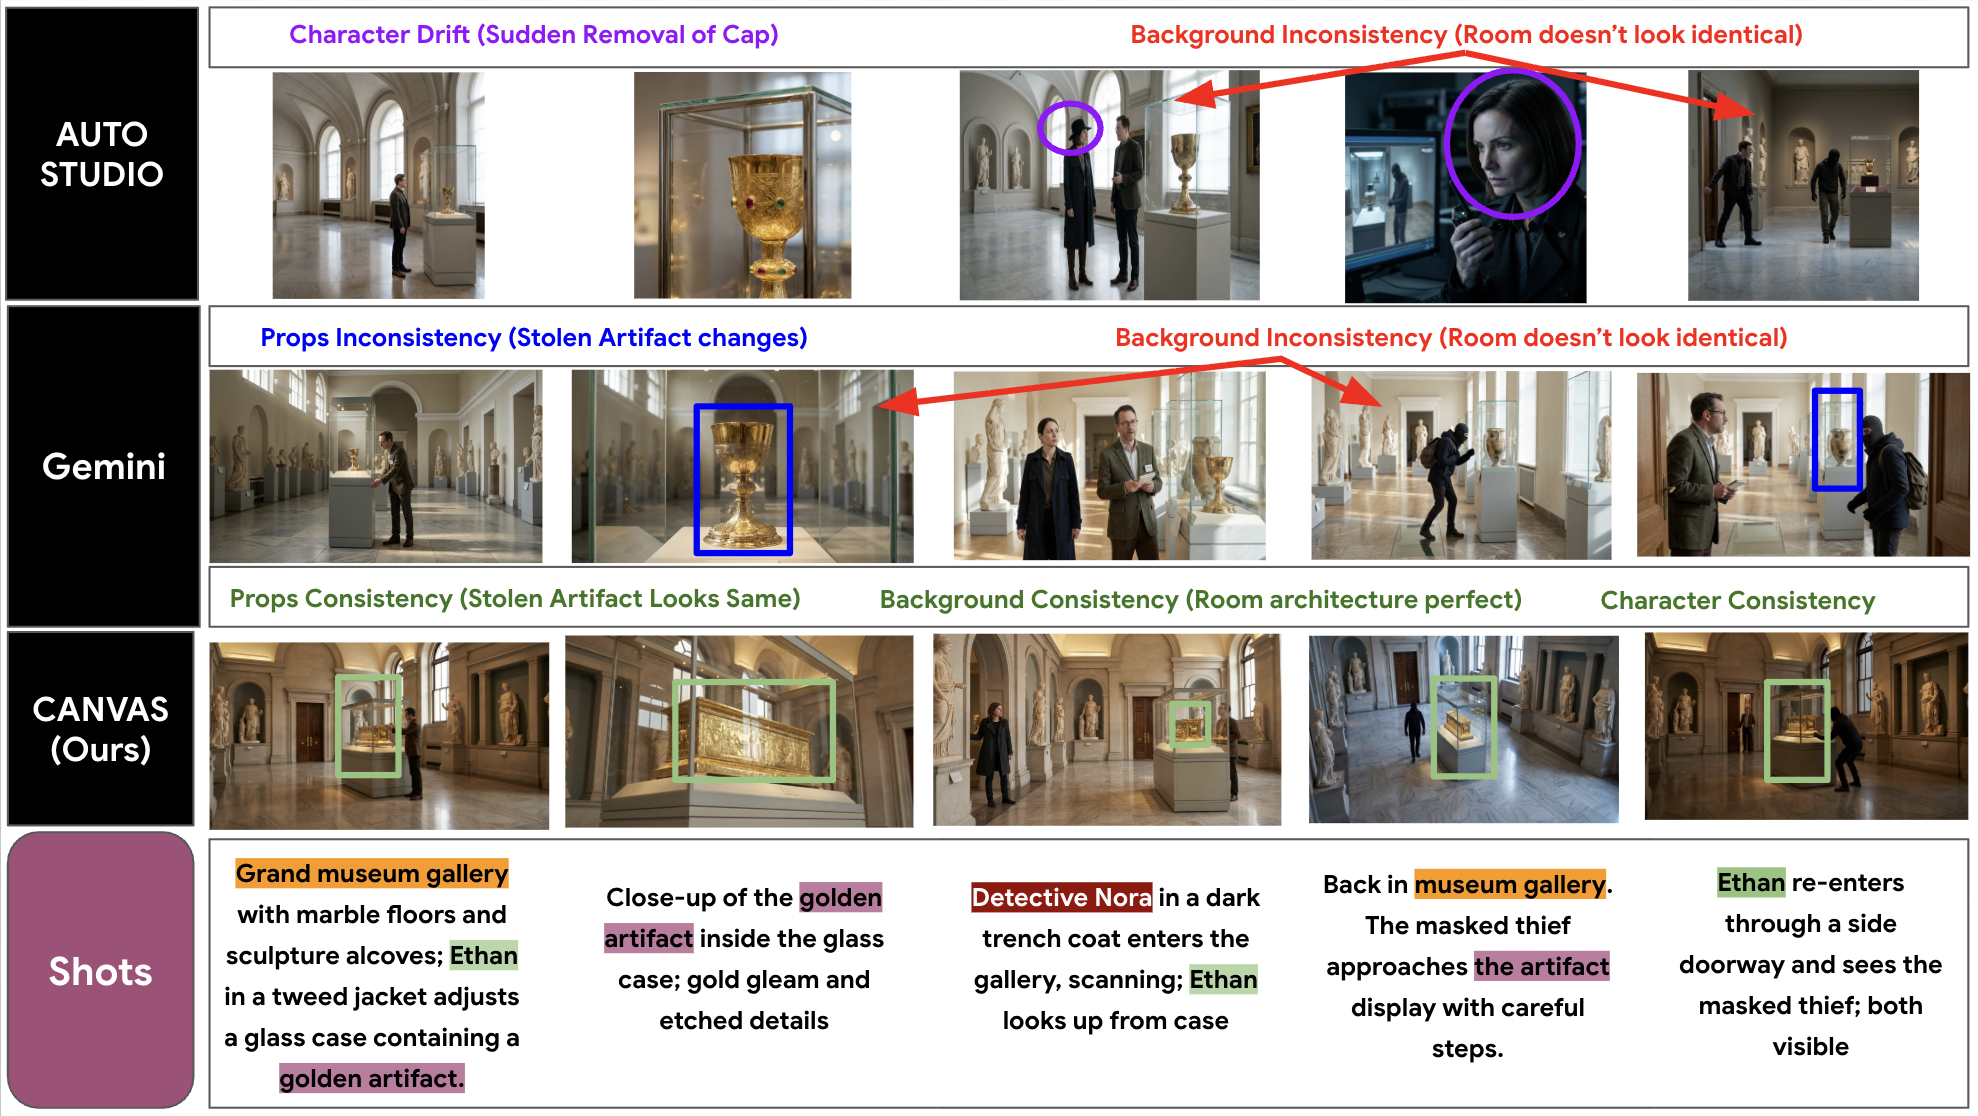
CANVAS, hareket üretilmeden önceki sahne planına yoğunlaşıyor. Görsel belleği, bir karakterin, odanın veya nesnenin araya başka sahneler girdikten sonra nasıl görünmesi gerektiğini saklıyor. Bu yazının kapak görselindeki müze soygunu karşılaştırmasında araştırmacılar, diğer yöntemlerin kaybettiği öğelerin kendi yöntemlerinde korunduğu bir örnek gösteriyor. Bu seçilmiş örnek, her istemin kör biçimde sınandığı bir test değil.
A²RD aynı fikri zamana yayıyor. Filmin tamamını tek seferde istemek yerine bölümler üretiyor ve çok modlu belleği güncelliyor. Olayları ileri taşıyabiliyor veya yeni bölümü daha önce kurulmuş kişi ve mekânlara yeniden bağlayabiliyor. Makale, bir bölümdeki hatanın sonrakilere taşınmasını önlemek için kare ve video düzeyinde ek iyileştirme de anlatıyor. Bu, ek üretim ve değerlendirme işlemleri demek; kaynak bitmiş video dakikası başına basit bir tüketici fiyatı vermiyor.
On dakikalık film ne gösteriyor?
Google, sürekli on dakikalık bir uzun video gösterimi olarak tanımladığı resmî A²RD filmini paylaşıyor. Yalnız ilk saniyelere bakmak yerine, birbirinden uzak zamanlarda geri dönen karakterleri, kıyafetleri ve mekânları incelemek daha anlamlı. Aşağıdaki oynatıcı YouTube’u ancak tıklanınca yükler.
A²RD makalesi, bir ila on dakikalık deneylerde sınanan karşılaştırma yöntemlerine göre tutarlılıkta en fazla %30, anlatı bütünlüğünde en fazla %20 iyileşme bildiriyor. “En fazla”, en iyi raporlanan karşılaştırmayı ifade ediyor; her üretimde aynı kazanç beklenemez. LVBench-C, karakter veya çevrenin uzun aralardan sonra geri döndüğü durumları sınamak için tasarlanmış. Makaledeki insan değerlendirmeleri bulguları destekliyor; bağımsız tekrar ve yaratıcıların kendi içeriklerindeki davranış hâlâ açık soru.
Öteki sonuçlar başka şeyler ölçüyor. CANVAS, sahne planı deneylerinde en iyi karşılaştırma yöntemine göre arka plan devamlılığında %21,6, karakter tutarlılığında %9,6 ve nesne tutarlılığında %7,6 iyileşme bildiriyor. VQQA, iyileştirilmemiş üretime göre T2V-CompBench’te %11,57, VBench2’de %8,43 mutlak artış bildiriyor. Görevler, karşılaştırma yöntemleri ve birimler farklı olduğundan bunlar tek bir başarı sıralamasına konamaz. Google, Co-Director için 400 senaryolu GenAD-Bench’te 81,4 tepe kalite puanı da bildiriyor; bu, kurgusal ürün reklamları sınavındaki bir puan, izleyicilerin tutarlı bulduğu filmlerin yüzdesi değil.
VQQA neyi düzeltiyor, insana ne kalıyor?
VQQA, üretilmiş klip hakkında hedefli sorular soruyor: Bir nesne istenen şekil ve malzemede mi? Müzisyen sahne geçişinde çalgı mı değiştiriyor? Görsel-dil modeli eleştiriyi istem değişikliğine dönüştürüyor ve video modeli yeniden deniyor. Genel seçici, yerel bir düzeltmenin asıl hedefi sessizce değiştirmemesi için adayları ilk istekle karşılaştırıyor. Sistem mevcut pikselleri boyamıyor; yeni istemlerle yeniden üretiyor.
Bir yönetmenin yine de ritmi, niyeti, sesi, hakları ve sonucun kullanılmaya değer olup olmadığını değerlendirmesi gerekir. Google, insanın döngüde olduğu yöntemleri araştırdığını söylüyor. Gemini ve Veo tabanlı akıştan gelen SynthID filigranından söz ediyor; filigran tek başına anlatı kalitesini veya bir çıktının yayımlanmaya uygunluğunu göstermiyor. Pratik çıkarım araştırma yönlerinin haritası: genel plan kurmak, görsel durumu hatırlamak, bölümler hâlinde üretmek ve sonucu incelemek. İncelenen görevler için kanıt umut verici; sıradan yaratıcıların bütün sistemi çalıştırmasına yönelik açıklanmış bir erişim yolu yok.
Kaynaklar 25 Eylül 2026’da kontrol edildi. Haber konusu Google’ın 24 Eylül araştırma özeti; dört temel ön baskı daha önce yayımlandı.
Kaynaklar
- Automating coherent long-form video generation ↗Google Research
- Co-Director: Agentic Generative Video Storytelling ↗arXiv
- CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding ↗arXiv
- A²RD: Agentic Autoregressive Diffusion for Long Video Consistency ↗arXiv
- VQQA: An Agentic Approach for Video Evaluation and Quality Improvement ↗arXiv
- Resmî A²RD on dakikalık film ↗Google Research / YouTube
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder