Claude, 123 açık kaynak kütüphane için biçimsel ispat yazdı
Anthropic ve Theorem, Claude'a 239 giriş noktasının RISC-V ikilisinde çökmediğini ispatlattı. Ne ispatlandı, hangi varsayımlara dayanıyor, nerede eksik.
Bu yazıda
Anthropic, Claude’un gerçek açık kaynak kodun çökemeyeceğine dair makine tarafından denetlenen ispatlar yazdığını söylüyor. İddia sınırlı ve yazı sınırlarını kendisi belirtiyor. Anthropic’in araştırma yazısını sınırlamalar bölümü ve dipnotlar dahil baştan sona okuduk. Bu yazıda neyin ispatlandığı, sonuçların neye dayandığı, ispatların neyi kapsamadığı ve AI ile hata bulma açısından neden önemli olduğu var. İspatları kontrol etmedik, yayımlanan çıktıları çalıştırmadık.
Anthropic ve Theorem ne yaptı?
Claude’a kaynak kodunu değil, derlenmiş programlar hakkındaki özellikleri ispatlattılar. Theorem ile çalışan Anthropic, Claude’un Google’ın OSS-Fuzz projesindeki 123 kütüphanenin 239 fuzz test giriş noktasının, 64 MB’tan küçük her girdi için bellek güvenliği hataları ya da başarısız assert’ler olmadan normal çıktığını ispatladığını söylüyor. İspatlar RISC-V makine kodu hakkında, Rocq ispat asistanında yazılmış ve Theorem’in RISC-V komut seti ile Linux süreçlerinin biçimsel modellerini kullanıyor. Anthropic, çalışmanın birkaç hafta sürdüğünü, toplamda yaklaşık 180 milyon satır Rocq tuttuğunu, tipik bir ispatın medyan 18.000 komutluk ikililer için yaklaşık 600.000 satır olduğunu ve bunun bildiği kadarıyla AI biçimsel doğrulamasının üretim yazılımına assembly düzeyinde uygulandığı ilk büyük ölçekli çalışma olduğunu söylüyor.
Fuzz testleri nasıl ispata dönüşüyor?
Anthropic zaten var olan bir spesifikasyonu yeniden kullanıyor. Bir fuzz testi girdi alan bir giriş noktası ve onu çökerten her girdi bir hata. Anthropic, “bu fuzz testi asla çökmez”i derlenmiş RISC-V kodu hakkında biçimsel bir ifadeye çeviriyor. Claude bunu ispatlarsa, o giriş noktasını fuzz’lamak belirtilen sınırlar içinde artık bir şey bulamaz. Anthropic’in vurgusu, bunun biçimsel doğrulamanın zor kısmını, bir programın ne yapması gerektiğine dair spesifikasyon yazmayı atlaması. Bir ispat başarısız olduğunda başarısızlık olası bir hataya işaret ediyor; bu yüzden Claude kodu yamalayıp spesifikasyonu yeniden üretti ve yamalı sürümü ispatladı. Anthropic, ispat kodunun neredeyse hiçbirinin elle incelenmesi gerekmediğini, çünkü Rocq denetleyicisinin spesifikasyona karşı doğruladığını söylüyor.
Hangi hataları buldu?
Anthropic, ispat girişimlerinin, bir fuzzer’ın ulaşma ihtimalinin düşük olduğu hatalar da dahil yüzlerce hatayı ortaya çıkardığını söylüyor. Örnekleri:
- Bir açıcıdaki (decompressor) sayaç taşması (underflow), yalnızca nadir bir düzene sahip, yaklaşık 20 MB’lık girdilerde sınır dışı yazmaya yol açıyor.
- Bir görüntü çözücüde sınır dışı okuma; 64 MB girdi ve 2 GB’tan fazla bellek gerektiriyor.
- Başka bir kütüphanede sınır dışı okuma; aynı dosyaya ait iki tutamaç üzerinde belirli bir çağrı dizisi gerektiriyor.
- libexpat’ta CVE-2026-56132’nin yeniden keşfi; derin iç içe girdi gerektiriyor.
- Hiç çökmeyen bir mantık hatası: bir uygulamanın hangi dosyaları yükleyebileceğini kısıtlamak için tasarlanmış bir özellik her zaman uygulanmıyordu.
Anthropic’in özeti ayrıca Claude’un “trilyonlarca test çalıştırmasına rağmen yıllardır gözden kaçan” hatalar bulduğunu söylüyor. Bu Anthropic’in çerçevelemesi ve yazı, yüzlerce hatanın kaçının önceden bilindiğini ya da upstream’de düzeltildiğini listelemiyor.
Başka neler denedi?
Her biri bitmiş değil, umut verici olarak bildirilen üç küçük deney:
- zlib: Claude RFC 1950’nin biçimsel spesifikasyonunu yazdı ve Linux çekirdeğindeki, x86 için derlenmiş zlib’in onu uyguladığını, Claude’un ürettiği x86 semantiğiyle ispatladı. Anthropic bunu yaklaşık altı kütüphane için tekrarladı ve upstream’e bildirilmekte olan küçük, sömürülemeyen köşe durumu hataları buldu.
- Rust’ta bir Python yorumlayıcısı: Claude, Python’un büyük bir alt kümesi için bir yorumlayıcı yazdı ve CPython’un yayımlanmış bir semantiğine uyduğunu Verus aracıyla ispatladı. 1,7 milyon rastgele programda davranış testlerin %99,95’inde CPython ile aynıydı.
- Bir PDF okuyucu: Anthropic, yaygın kullanılan bir PDF okuyucuda yapılan doğrulama girişiminin bir haftada genellikle bir yılda raporlanan kadar güvenlik hatası bulduğunu ve yaygın kullanılan başka bir uygulamada on yıldan uzun süredir gizli duran bir mantık hatası olduğunu söylüyor. Adlarını vermiyor.
Maliyeti ne ve ucuzluyor mu?
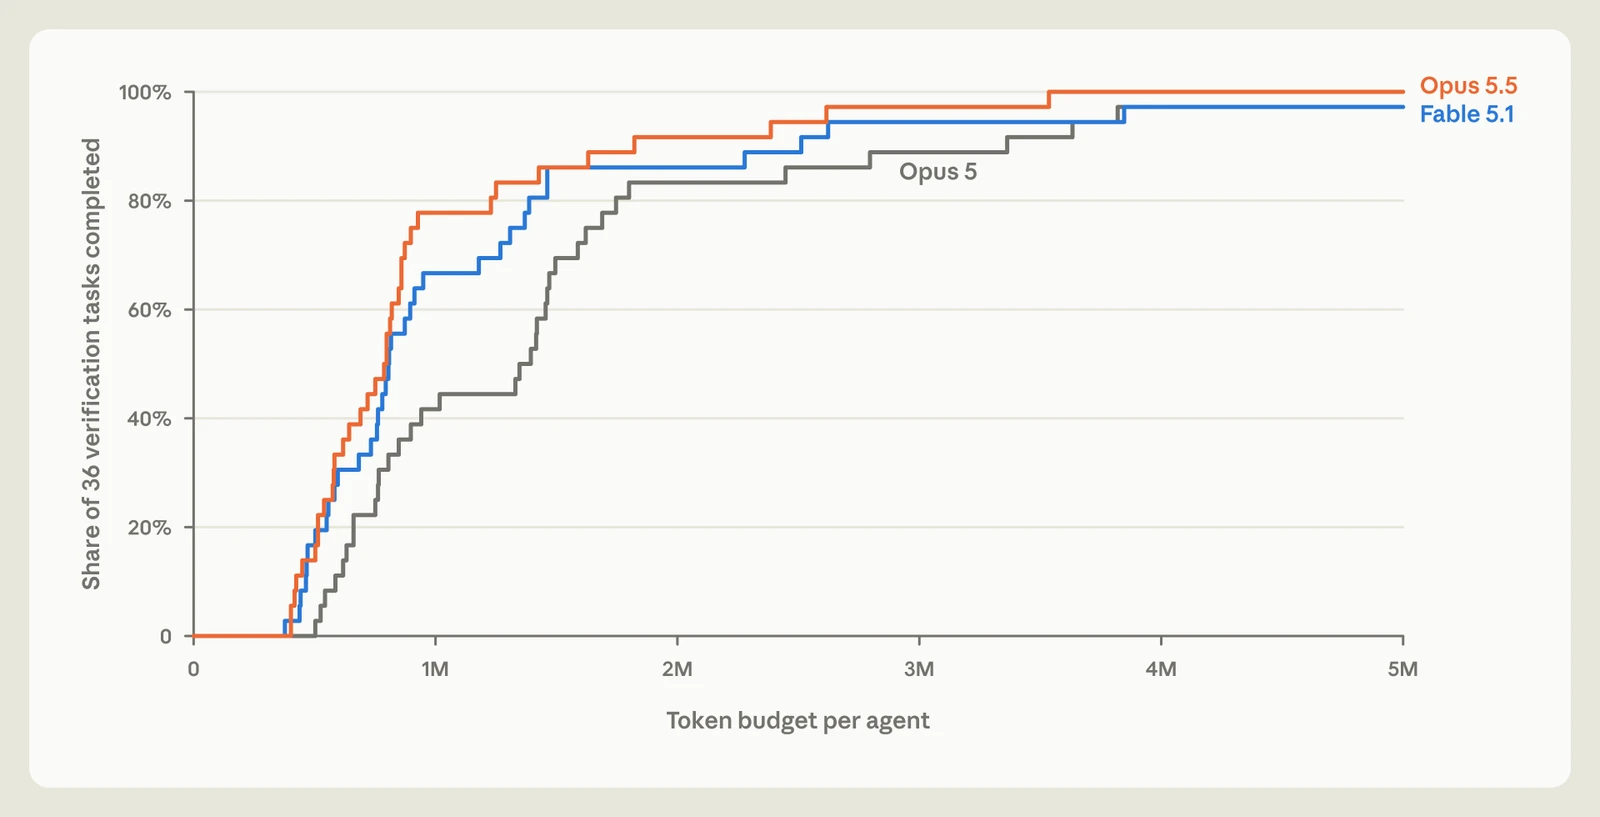
Bugün pahalı, ama Anthropic’in iyileşiyor dediği bir eğilimle. İspatların yüz milyonlarca token alabildiğini söylüyor. OSS-Fuzz kodundan kurulan 36 küçük doğrulama görevinde Opus 5.5’in yarısını Opus 5’e göre yaklaşık %40 az token ile ispatladığını bildiriyor ve yazıdaki bir grafik, Opus 5.5’in daha düşük token bütçelerinde Opus 5 ve Fable 5.1’den daha fazla görevi tamamladığını gösteriyor. Ajanlar ortak çalışma alanında birbirlerinin ispatlarını kopyalayabildiğinde tek başlarına çalışanlardan %17 az token gerekti ve Anthropic bir ispatın çoğunun her programın içerdiği kodla ilgili olduğunu, bu yüzden ispatların büyük ölçüde örtüştüğünü söylüyor.
Neyi ispatlamıyor?
Anthropic açık: “biçimsel doğrulanmış” “hatasız” demek değil. Sınırlamalar bölümü şunları söylüyor:
- Gerçek makine modelden farklı. İspatlar musl’a bağlı, tek iş parçacıklı statik RISC-V ikilileri hakkında; çoğu kişi bu kütüphaneleri x86 ya da ARM üzerinde glibc ile çalıştırıyor.
- İddia her şeyi kapsamıyor. AddressSanitizer tüm bellek güvenliği hatalarını yakalamıyor, her giriş noktası doğrulanmadı, tüm giriş noktaları doğrulansa bile bir kütüphanenin tamamı kapsanmaz (örneğin ölü kod) ve çağıranlar kütüphaneyi yine de yanlış kullanıp belleği bozabilir.
- Güven kaybolmuyor, yer değiştiriyor. RISC-V ve Linux’un biçimsel modellerine, tam teorem ifadelerine, Rocq denetleyicisine ve Anthropic’in dipnotuna göre donanıma, işletim sistemine ve denetleyicinin dayandığı OCaml derleyicisine güvenmek gerekiyor.
- Ödül hacklemesi mümkün. Claude kodu yamalayabildiği için, bir programı hiç çökmeyen önemsiz bir programa yeniden yazarak bir teoremi ispatlanabilir kılabilirdi. Anthropic yamaları cezalandırdığını, bir yamanın kaç girdiyi değiştirdiğini ispatlamayı ödüllendirdiğini ve yamaları kaydedip denetlediğini söylüyor.
- Bazı ispatlar saklanıyor. Anthropic, yamasız bir hatayı açığa çıkarabilecek ispatları yayımlamıyor.
Neler yayımlandı?
Anthropic, henüz herkese açık olmayan güvenilen bileşenleri, yama gerektirmeyen fuzz testleri için Claude’un tam Rocq ispatlarını ve ispatlayamadığı fuzz testlerinin spesifikasyonlarını yayımladığını; Theorem’in aynı boru hattını diğer açık kaynak projeler için çalıştırmayı önerdiğini ve başlamak için bir Claude skill’i yayımladığını söylüyor. Bir ispat alt kümesine, Theorem’in RISC-V ve Linux semantiğine, Theorem’in hizmet sayfasına ve tam bir ekine bağlantı veriyor. Bunları açmadık.
Henüz bilinmeyenler neler?
- Bağımsız doğrulama. Anthropic davet ediyor. Henüz dışarıdan bir kontrol görmedik.
- Yüzlerce hatanın kaçının yeni olduğu ve kaçının upstream’de düzeltildiği.
- Yaklaşımın x86, ARM, dinamik bağlı glibc ve çok iş parçacıklı koda taşınıp taşınmayacağı; Anthropic bunları kapatılacak boşluklar olarak adlandırıyor.
- 36 görevlik kıyas dışında kütüphane başına maliyetin ne olduğu.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- İddia dar ve dar anlatılıyor. “Bu varsayımlar altında 64 MB’ın altındaki girdilerde çökme yok”, “güvenli”den çok daha zayıf ve Anthropic bunu söylüyor.
- Yöntem şu âna uyuyor. Hata bulan yetenek artık düzeltmeleri de denetliyor. Olgun bir kod tabanında AI destekli araştırmanın kritik hatalar bulmasını PHP raporumuzda görün.
- Sayılar Anthropic’in kendi sayıları. Token tasarrufları, hata sayıları ve %99,95 eşleşme oranı yazıdan geliyor ve bağımsız ölçülmedi.
- Güvenilen taban küçük ama gerçek. Birçok ispat onlara dayandığında Rocq ve makine modellerini sağlamlaştırmak daha önemli hale geliyor.
Editoryal inceleme: 23 Ekim 2026 (AI). Anthropic’in “LLMs are making formal software verification feasible at a much larger scale” araştırma yazısı (sayfa metadata’sında 22 Ekim 2026 tarihli, 23 Ekim’de yeniden değiştirilmiş) üzerinden hazırlandı; sayfa metni olarak, sınırlamalar ve dipnotlar dahil baştan sona okundu. Ek PDF’i okumadık, ispatları, Theorem depolarını ya da hizmet sayfasını açmadık, hiçbir şey çalıştırmadık ve Anthropic ya da Theorem ile iletişime geçmedik. Sayılar Anthropic’in kendi sayılarıdır. Sayfa okumamızdan sonra değişmiş olabilir.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder