Microsoft MAI-Base-2: 2,8T'lik model ve verimlilik iddiası
Microsoft, 2,8T'lik uzman karışımı MAI-Base-2'nin ön eğitimini bitirdi. 4–12 kat verimlilik iddiası ve nelerin açık, nelerin açık olmadığı.
Bu yazıda
Microsoft, artık sınır ölçeğinde bir modeli tamamen kendi içinde ön eğitebildiğini ve bunu en güçlü açık temel modelden çok daha ucuza yaptığını söylüyor. Microsoft AI 15 Ekim’de, 2,8T parametreli bir uzman karışımı olan MAI-Base-2’nin ön eğitimini bitirdiğini duyuran bir “Lab Notes” yazısı yayımladı. Yazıyı metin olarak tam okuduk. Bu yazı eğitim sürecini, 4–12 kat verimlilik iddiasını, nasıl ölçüldüğünü ve Microsoft’un neyi dışarıda bıraktığını anlatıyor.
Microsoft MAI-Base-2 hakkında ne duyurdu?
Bitmiş ama henüz kullanılamayan bir temel model. Microsoft AI, MAI-Base-2’nin 80B aktif ve 2,8T toplam parametreli, MAI-Base-1’den daha büyük ve seyrek, daha fazla veriyle eğitilmiş bir uzman karışımı olduğunu söylüyor. Ön eğitim tamam ve son eğitim sürüyor. Yazı modelin “tutulmuş değerlendirmelerimizde test ettiğimiz her açık ağırlıklı modelden daha iyi” olduğunu ve MAI-Base-3 hazırlıklarının başladığını söylüyor.
MAI-Base-2 nasıl eğitildi?
Ağustos ve Eylül 2026’da 38 gün boyunca 16.000 GB200 GPU’da. Microsoft, 2,5 PFLOPS GB200 BF16 tepe değerine göre normalize edilmiş ve yeniden hesaplama ile optimizer FLOP’larını dışarıda bırakan %21 ortalama model FLOP kullanımı ve %89 goodput bildiriyor.
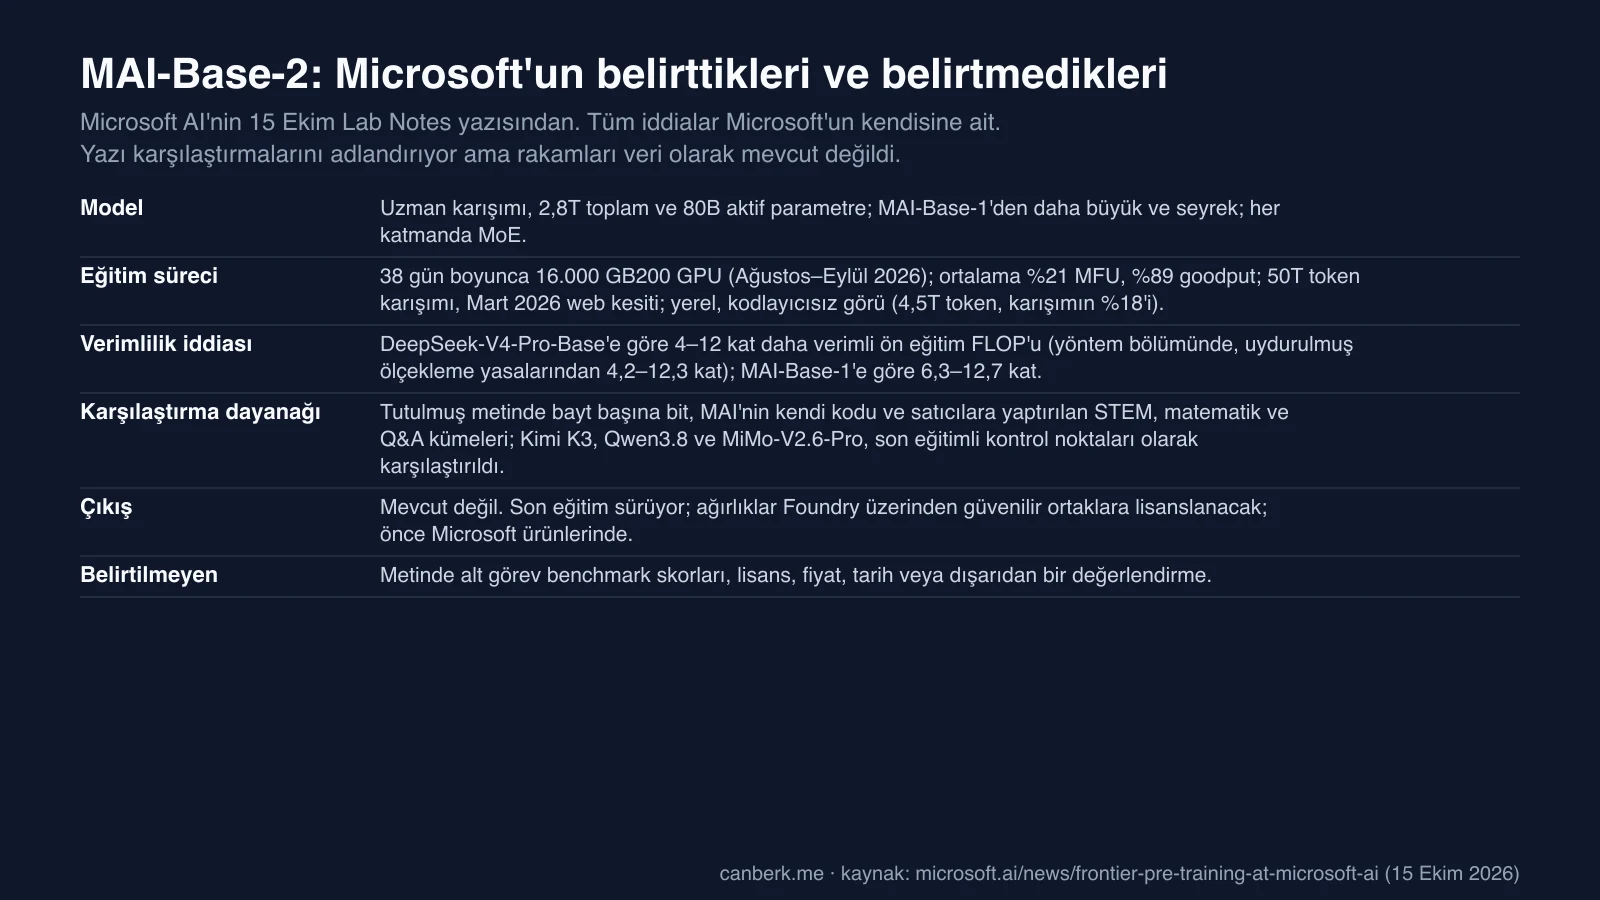
- Veri. 50T tokenlık bir karışım; benzersiz tokenlar MAI-Base-1’e göre yaklaşık %36 artmış ve web verisinin bilgi kesiti Mart 2026. Microsoft verinin organik olduğunu, kendi içinde işlendiğini ve başka modellerden distillation içermediğini söylüyor.
- Görü. MAI-Base-2, MAI-Base-1’de olmayan, kodlayıcısız bir mimariyle yerel olarak görüyle ön eğitildi. Görü-dil külliyatı 4,5T benzersiz token ve tekrarla karışımın %18’ini oluşturuyor.
- Mimari ve optimizasyon. MoE artık her katmanda; MAI-Base-1 yoğun ve MoE katmanlarını dönüşümlü kullanıyordu, bu MoE katmanı kullanımını %24’ten %35’e çıkardı. Microsoft bu ölçekte AdamW’den daha kararlı ve verimli olduğunu söylediği Muon optimizer’ını ve seçilmiş aktivasyonlarda, lisans başlıklarındaki bir ön işleme hatasını da yakaladığını söylediği gradyan kırpmayı kullanıyor.
- Yöntem. Daha küçük “ölçekleme merdiveni” modelleri hiperparametreleri belirliyor ve tam koşunun sonuçlarını öngörüyor.
4–12 kat verimlilik iddiası nedir?
MAI-Base-2’nin, Microsoft’un en güçlü açık temel model dediği DeepSeek-V4-Pro-Base’den çok daha az eğitim FLOP’uyla kalitesine ulaştığı. Giriş 4–12 kat daha verimli ön eğitim FLOP’u diyor; metodoloji bölümü benchmark başına ölçekleme yasaları uydurularak tahmin edilen 4,2–12,3 kat veriyor. Kendi MAI-Base-1’ine karşı Microsoft 6,3–12,7 kat iyileşme iddia ediyor. Microsoft tasarrufları daha ucuz değil, daha büyük bir model eğitmeye harcadığını söylüyor.
Microsoft’un karşılaştırmasına güvenilir mi?
Doğrulanmış değil, bir laboratuvar sonucu olarak ele alın. Yazı dayanağını belirtiyor:
- Dar bir ölçüt. Karşılaştırmalar, kamuya açık alt görev benchmark’larının skorları değil, tokenizer’dan bağımsız, tutulmuş metinde bayt başına bit kullanıyor. Bayt başına bit bir modelin metni ne kadar iyi tahmin ettiğini ölçer; görevlerde nasıl performans göstereceğini tek başına söylemez.
- Microsoft’un kendi verisi. Tutulmuş kod Microsoft’un kendi kod tabanından geliyor ve STEM, matematik ve Q&A kümeleri satıcılara yaptırıldı. Microsoft hepsinin eğitim verisine karşı arındırıldığını söylüyor.
- Farklı türde modeller. DeepSeek-V4-Pro-Base bir temel model, ancak Kimi K3, Qwen3.8-2.4T-A95B ve MiMo-V2.6-Pro-RL yalnızca son eğitimli açık ağırlıklı kontrol noktaları; Microsoft bu yüzden son eğitimin sonuçları etkileyebileceğini not ediyor.
- Bir tahmin. Verimlilik katı, diğer modelleri yeniden eğitmekten değil, uydurulmuş ölçekleme yasalarından geliyor.
- Veri olarak okuyamadığımız şekiller. Yazı on şekle atıfta bulunuyor ama metin arkalarındaki değerleri vermiyor.
MAI-Base-2’yi kullanabilir misiniz?
Henüz hayır ve muhtemelen doğrudan da olmayacak. Son eğitim sürüyor ve Microsoft modelleri önce kendi ürünlerinde yayımlayacağını söylüyor. Tüm boru hattının ve veri kaynağının sahibi olduğu için ağırlıkları Foundry üzerinden güvenilir ortaklara lisanslamayı planlıyor. Lisans koşulları, fiyat, tarih veya kontrol noktası verilmedi. Bu, 2027’den itibaren ürünleri için birincil çıkarım sistemi olarak tanımladığı Microsoft’un Maia 300 çip planıyla eşleşiyor.
MAI-Base-2 hakkında neler hâlâ belirsiz?
- Alt görev performansı. Metinde benchmark skoru yok ve son eğitimli model sonucu yok; Microsoft “yakında” daha fazlasını vaat ediyor.
- Bağımsız doğrulama. Yok; 4–12 kat rakamı Microsoft’un ölçekleme yasası uydurmalarına dayanıyor.
- Çıkış ve lisanslama. Tarih, fiyat veya lisans koşulu yok.
- Kapalı öncü modellerle kıyas. Yazı yalnızca açık ağırlıklı modellerle karşılaştırıyor. Basın haberleri Mustafa Suleyman’ın çalışanlara modelin OpenAI’nin GPT-5.6’sının arkasındaki modeli dörtte bir hesaplamayla geçtiğini söylediğini yazıyor, ancak bu iddia yazıda yok ve doğrulamadık.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Bu bir ön eğitim sonucu. Bir temel modelin metin tahmin skoru erken bir işaret, ürün değil.
- Verimlilik manşeti yöntemli bir aralık. 4–12 katı, tek bir açık temel modele karşı ölçekleme yasalarından bir tahmin olarak okuyun.
- Erişim dar olacak. Foundry üzerinden güvenilir ortaklara ağırlık, kamuya açık indirme değil.
- Son eğitim sonuçlarını izleyin. Modelin neler yapabildiğini onlar gösterecek.
Editoryal inceleme: 16 Ekim 2026 (AI). Microsoft AI’nin Lab Notes yazısı (metin olarak tam okundu; on şekli ve grafik görselleri veri olarak mevcut değildi) esas alınarak hazırlandı. Modeli çalıştırmadık veya test etmedik, altta yatan değerlendirmeleri okumadık ve iç konuşmalara dair basın haberlerini doğrulamadık.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder