Sakana AI SAIL: Robot önce simülasyonda deniyor, sonra hareket ediyor
SAIL, hareketleri simülasyonda sınayarak robot planlarını iyileştiriyor. Resmî videolar, %25–%73 sonucunun anlamı ve gerçek robot testinin sınırları.
Bu yazıda
Sakana AI ve Tokyo Üniversitesi, 28 Eylül’deki SAIL tanıtımında robotun ilk hareket önerisini doğrudan uygulamak yerine önce simülasyonda sınamasını anlatıyor. SAIL, mevcut görsel-dil modelinin ağırlıklarını değiştirmeden daha iyi bir hareket dizisi arıyor. Yaklaşım, bir modelin hareket önerisini uygulamadan önce kontrol etmenin farklı bir yolunu sunuyor.
Tarihleri ayırmak önemli: makalenin ilk sürümü 9 Mart, son revizyonu 19 Eylül. Bugünkü gelişme, IROS 2026’ya kabul edilen çalışmanın Sakana tarafından tanıtılması.
Önce sanal ortamda dene
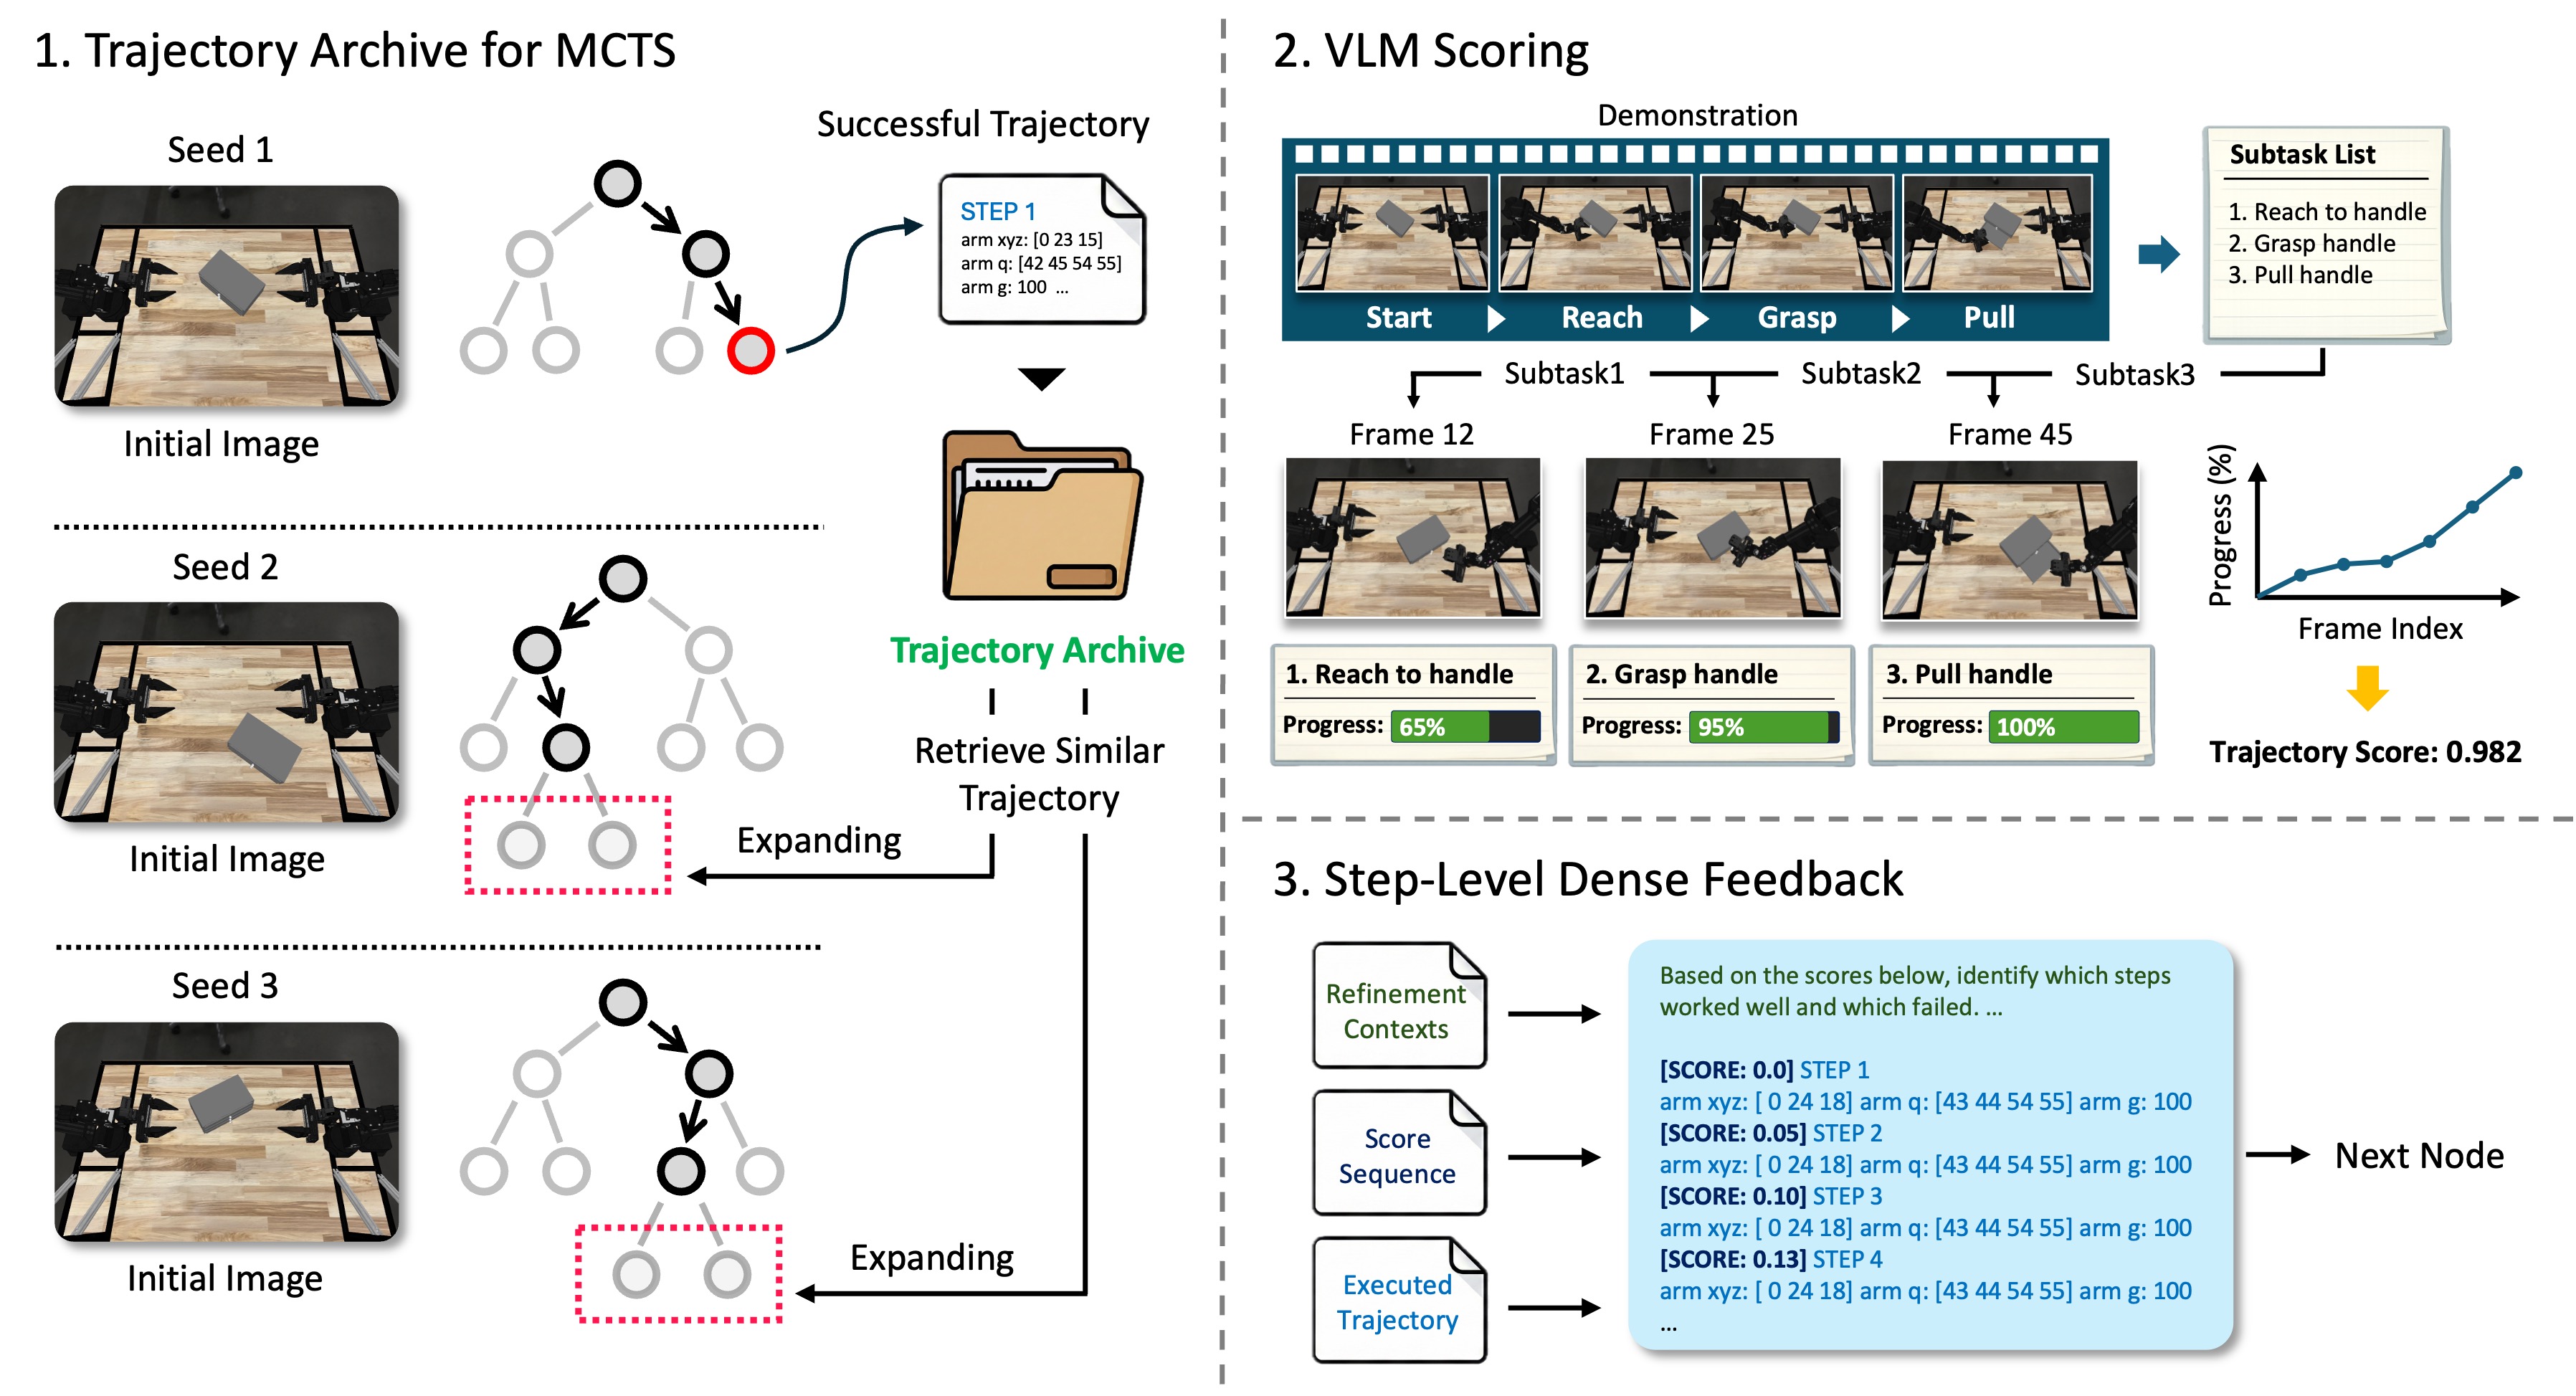
Bir robot kolunun küpü kaseye bırakması, yalnızca nesneyi tanımayı gerektirmiyor. Kavrama konumu, yaklaşma açısı ve hareket sırası da doğru olmalı. SAIL’de model birkaç başarılı örnekten yararlanarak bir hareket dizisi öneriyor. Simülatör bunu çalıştırıyor; bir değerlendirme modeli videoyu inceleyip hangi adımda ilerlemenin durduğunu belirliyor. Bu geri bildirim yeni adayın hazırlanmasında kullanılıyor.
Monte Carlo ağaç araması, olası diziler arasında alternatifleri araştırıp umut veren adayları iyileştirmeye yarıyor. Böylece fiziksel kola gönderilen komut, ilk tahmin olmak zorunda kalmıyor. Çalışmada üretim ve değerlendirme için Gemini Robotics-ER 1.5 kullanılıyor; SAIL ayrı bir temel model veya yeni bir model eğitimi değil.
%25’ten %73’e: Hangi başarı ölçülüyor?
Deneylerde, altı simülasyon görevinin her biri için 20 başlangıç düzeni kullanılıyor. Arama bütçesi arttıkça başarılı bir hareket dizisi bulma oranı yükseliyor:
| Aday bütçesi | Ortalama başarı |
|---|---|
| 1 | %25 |
| 6 | %55 |
| 15 | %65 |
| 30 | %71 |
| 45 | %73 |
Bunlar araştırmacıların bildirdiği simülasyon sonuçlarıdır; bağımsız testimiz değildir. Başarı, arama bütçesi içinde simülatörün görev kontrolünü geçen bir dizi bulunması demek. Modelin kendi değerlendirme puanı ile bu sonuç aynı ölçüm değil. Ayrıca %73, gerçek dünyadaki tüm robot görevleri için bir başarı vaadi değil.
Gerçek robotta ne gösterildi?
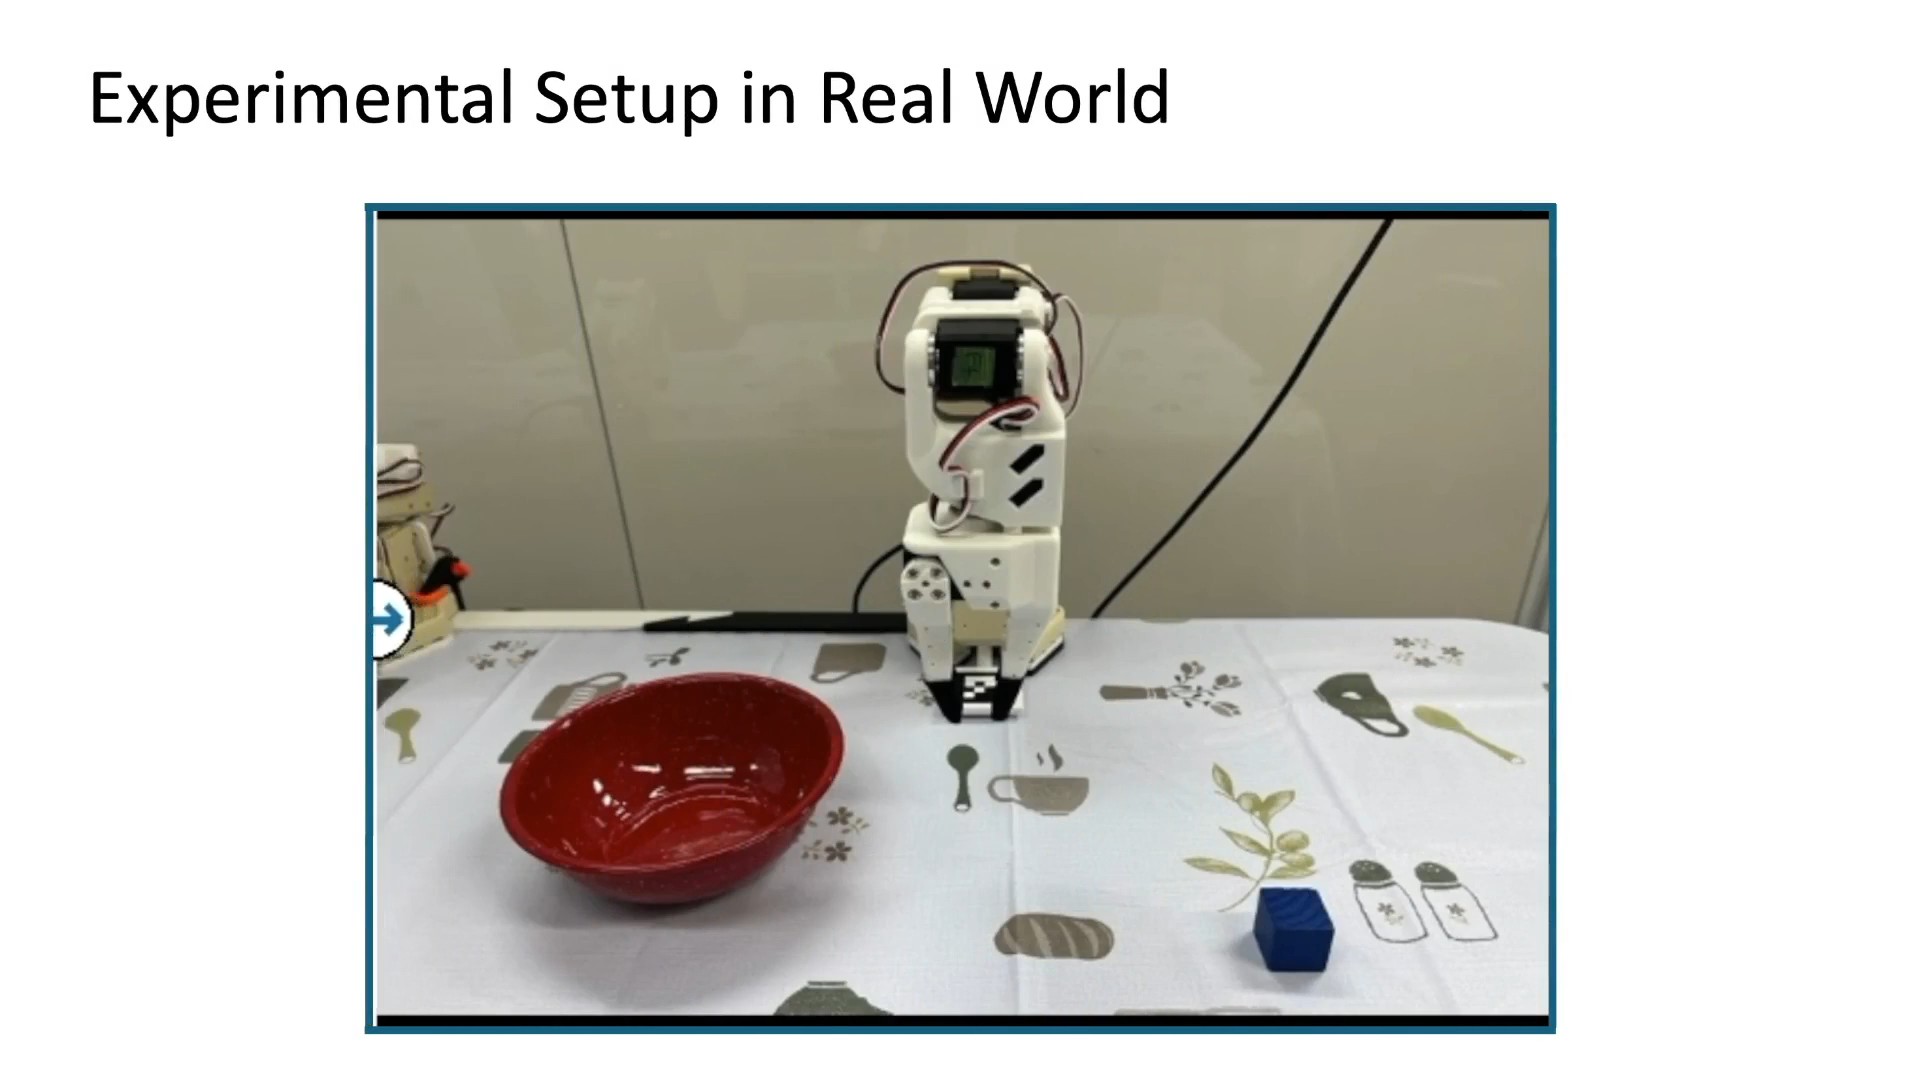
LeRobot SO-101 koluyla bir küpü kaseye yerleştirme görevi deneniyor. Araştırmacılar sahneyi renk ve derinlik gözlemlerinden kurup simülasyonda arama yapıyor. 15 aday bütçesiyle, nesnelerin konumları değiştirilerek yapılan altı denemenin beşi başarılı. Bildirilen başarısızlık, poz kestirimi ve simülasyon ile fiziksel temas arasındaki farklarla ilişkilendiriliyor.
Bu yaklaşım nerede işe yarayabilir?
Bizim açımızdan asıl soru “robot ne kadar akıllı?” yerine “yanlış öneriyi fiziksel harekete dönüşmeden kaç kez sınayabiliriz?” oluyor. Örneğin sabit bir çalışma tezgâhında önceden planlanabilir görevler, simülasyon hazırlamanın maliyetini karşılayabilir. Hareketli bir ortamda ise arama tamamlanana kadar sahnenin değişmesi ayrı bir problem yaratır. Bunlar uygulama değerlendirmesi için sorular; bu araştırmanın doğruladığı kullanım alanları değil.
Çalışmanın sınırları belirgin: hareket sırasında görsel geri bildirimle düzeltme yapılmıyor, arama ek hesaplama gerektiriyor ve gerçek dünya değerlendirmesi tek görevde çok az denemeye dayanıyor. Daha fazla adayın daha iyi sonuç vermesi, daha hızlı ya da daha ucuz bir sistem anlamına gelmiyor.
SAIL’in izlemeye değer tarafı, model geliştirmeyi yalnız yeniden eğitim olarak görmemesi. Doğru simülatör, anlamlı geri bildirim ve yeterli arama bütçesi de performansı etkiliyor. Üretimde karar vermek için başarı oranının yanına toplam gecikme, hesaplama maliyeti ve farklı sahnelere aktarımı koymak gerekir.
Kaynaklar
- SAIL — official announcement, 28 September ↗Sakana AI
- SAIL — demonstrations and results ↗Sakana AI / University of Tokyo
- SAIL paper and version history ↗arXiv
- SAIL full paper (CC BY 4.0) ↗Sato et al.
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder