FDE-Bench: Yapay zekâ ajanı gerçekten çalışan bir sistemi dağıtabiliyor mu?
FDE-Bench'in 136 Docker, Compose ve Kubernetes görevini; yedi modelin sonuçlarını, temiz ortamda yeniden dağıtım yöntemini ve insan karşılaştırmasının sınırlarını inceliyoruz.
Bu yazıda
Bir Dockerfile sorunsuz derlenebilir; uygulama yine de açılır açılmaz çökebilir. Kubernetes manifesti makul görünebilir; servis hiçbir zaman hazır duruma geçmeyebilir. 23 Eylül 2026’da arXiv’e gönderilen FDE-Bench, “ajan yapılandırma yazabiliyor mu?” sorusunu genişletiyor: teslim ettiği dosyalar, belirtilen koşulları sağlayan çalışan bir dağıtım oluşturuyor mu?
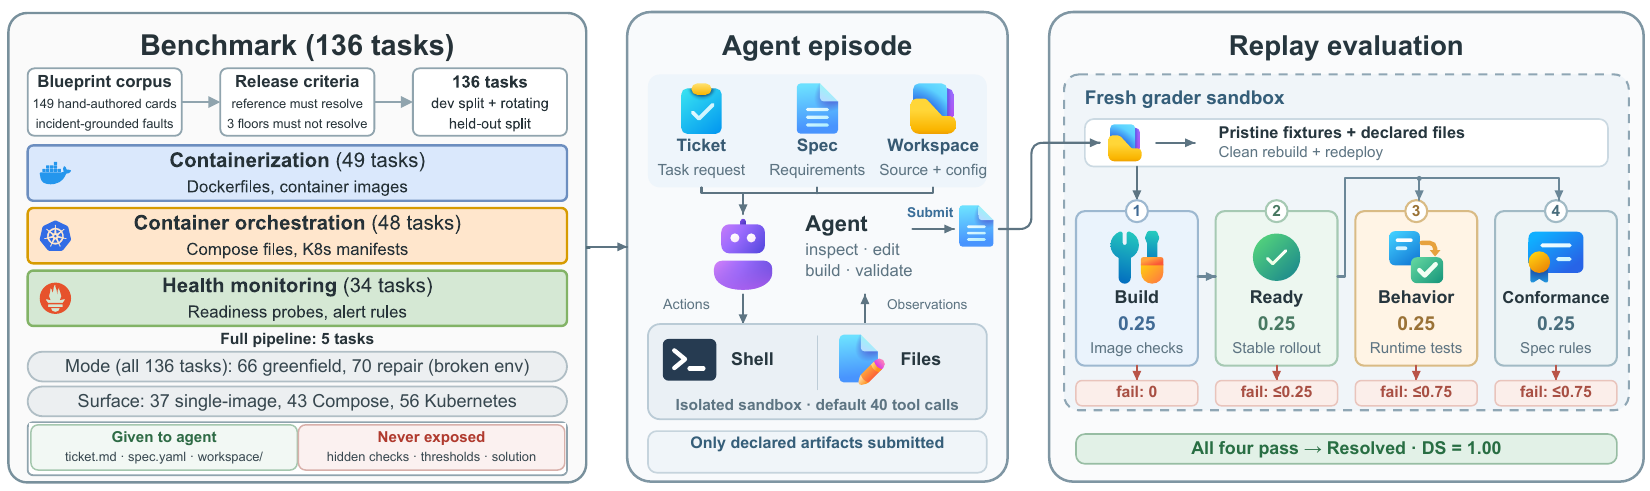
Araştırmacılar, elle hazırlanan 149 taslaktan 136 görev seçmiş: 37 tek imaj, 43 Compose ve 56 Kubernetes görevi. Bunların 66’sında ajan kaynak kodu ve gereksinimlerden başlayarak yapılandırmayı kuruyor (greenfield); 70’inde ise kasıtlı olarak bozulmuş bir yapılandırmayı onarıyor. Uygulamalar araştırma için yazılmış, senaryo taslakları gerçek olay raporlarından beslenmiş. Bu çalışma uygulama kodunu değiştirme veya canlı üretim kümesini işletme becerisini ölçmüyor.
Temiz ortamda yeniden kurulum neden önemli?
Ajan bir iş talebi, makine tarafından okunabilir şartname ve çalışma alanı görüyor. Dosyaları inceleyebiliyor, dağıtım dosyalarını değiştirebiliyor, derleyip deneyebiliyor. Teslimden sonra değerlendirici yalnız belirtilen dosyaları alıyor, çalışan ortamı kapatıyor ve bu dosyaları temiz başlangıç üzerine koyarak sistemi tekrar kuruyor. Elle başlatılmış bir konteyner veya yalnız canlı ortama eklenmiş bir gizli anahtar kayboluyor. Bu yöntem, son terminal görüntüsünü puanlamaktan daha güçlü bir sonuç veriyor.
Yeni dağıtım dört programatik katmandan geçiyor: derleme, kararlı hazır olma, davranış ve şartnameye uyum. Davranış testleri uç noktaları, servisler arası işlemleri ve izlemeyi yokluyor. Uyum testleri kopya sayısı, root olmayan kullanıcı ve düz metin gizli anahtar yasağı gibi koşullara bakıyor. İlk iki katman, sonraki testlere geçişi açıyor. Her katman Dağıtım Puanı’na 0,25 katkı sağlıyor; görevin çözülmesi için dördünün de geçilmesi gerekiyor. Puanı bir dil modeli hakemi vermiyor.
Görevleri seçen kapı da önemli. Referans çözüm görevi bitirmeli; dosyalara hiç dokunmamak, şartnameyi mekanik biçimde yapılandırmaya kopyalamak ve genel bir sunucu taslağı göndermek ise başarısız olmalı. Bu üç basit yaklaşım değerlendirmede hiçbir görevi çözmemiş. Yazarlar, revizyondan sonra kalan yedi kontrol-şartname uyumsuzluğunu da açıklıyor. Bildirdiklerine göre bunların hiçbiri yayımlanan sonuçlardaki çözüm kararını veya puanı değiştirmiyor. Bu şeffaflık yararlı; yine de bütün olası kestirme yolların elendiğini kanıtlamıyor.
Yedi modelin karşılaştırması ne söylüyor?
Modeller aynı dört aracı ve sabit istemi kullanmış. Her model-görev çifti için tek çalışma var; araç çağrısı ve süre sınırları görev bazında belirlenmiş. Aşağıdaki tablo, makalenin 136 görevlik v1.1 sonuçlarından alınmıştır. Çözüm oranı ya hep ya hiç ölçüsüdür; ortalama Dağıtım Puanı (DS) ara aşamaları da yansıtır.
| Model | Çözülen | Ortalama DS | Medyan araç çağrısı |
|---|---|---|---|
| Gemini-3.6-Flash | %75,0 | 0,857 | 35 |
| Claude-Sonnet-5 | %72,8 | 0,855 | 29 |
| GPT-5.6-Terra | %69,9 | 0,842 | 9 |
| DeepSeek-V4-Pro | %69,9 | 0,831 | 35 |
| DeepSeek-V4-Flash | %66,2 | 0,811 | 30 |
| GPT-5.6-Luna | %63,2 | 0,785 | 11 |
| Gemini-3.5-Flash-Lite | %52,9 | 0,719 | 37,5 |
Gemini-3.6-Flash, 136 görevin 102’sini çözerek gözlenen en yüksek orana ulaşıyor. Ancak makaledeki görev ailesine göre kümelenmiş karşılaştırma, Claude-Sonnet-5’e güvenilir bir üstünlük göstermiyor (p=0,59). Liderin bildirilen %95 Wilson aralığı %67,1–81,5 ve her model-görev çifti yalnız bir kez çalıştırılmış. Bu sıralama, kullanılan arayüz ve bütçenin sonucu; genel bir dağıtım ajanı lig tablosu değil. GPT-5.6-Terra’nın benzer çözüm oranında dokuz medyan çağrı kullanması da araştırmaya değer; çağrı sayısı tek başına toplam maliyeti veya geçen süreyi göstermiyor.
En belirgin başarısızlık nerede?
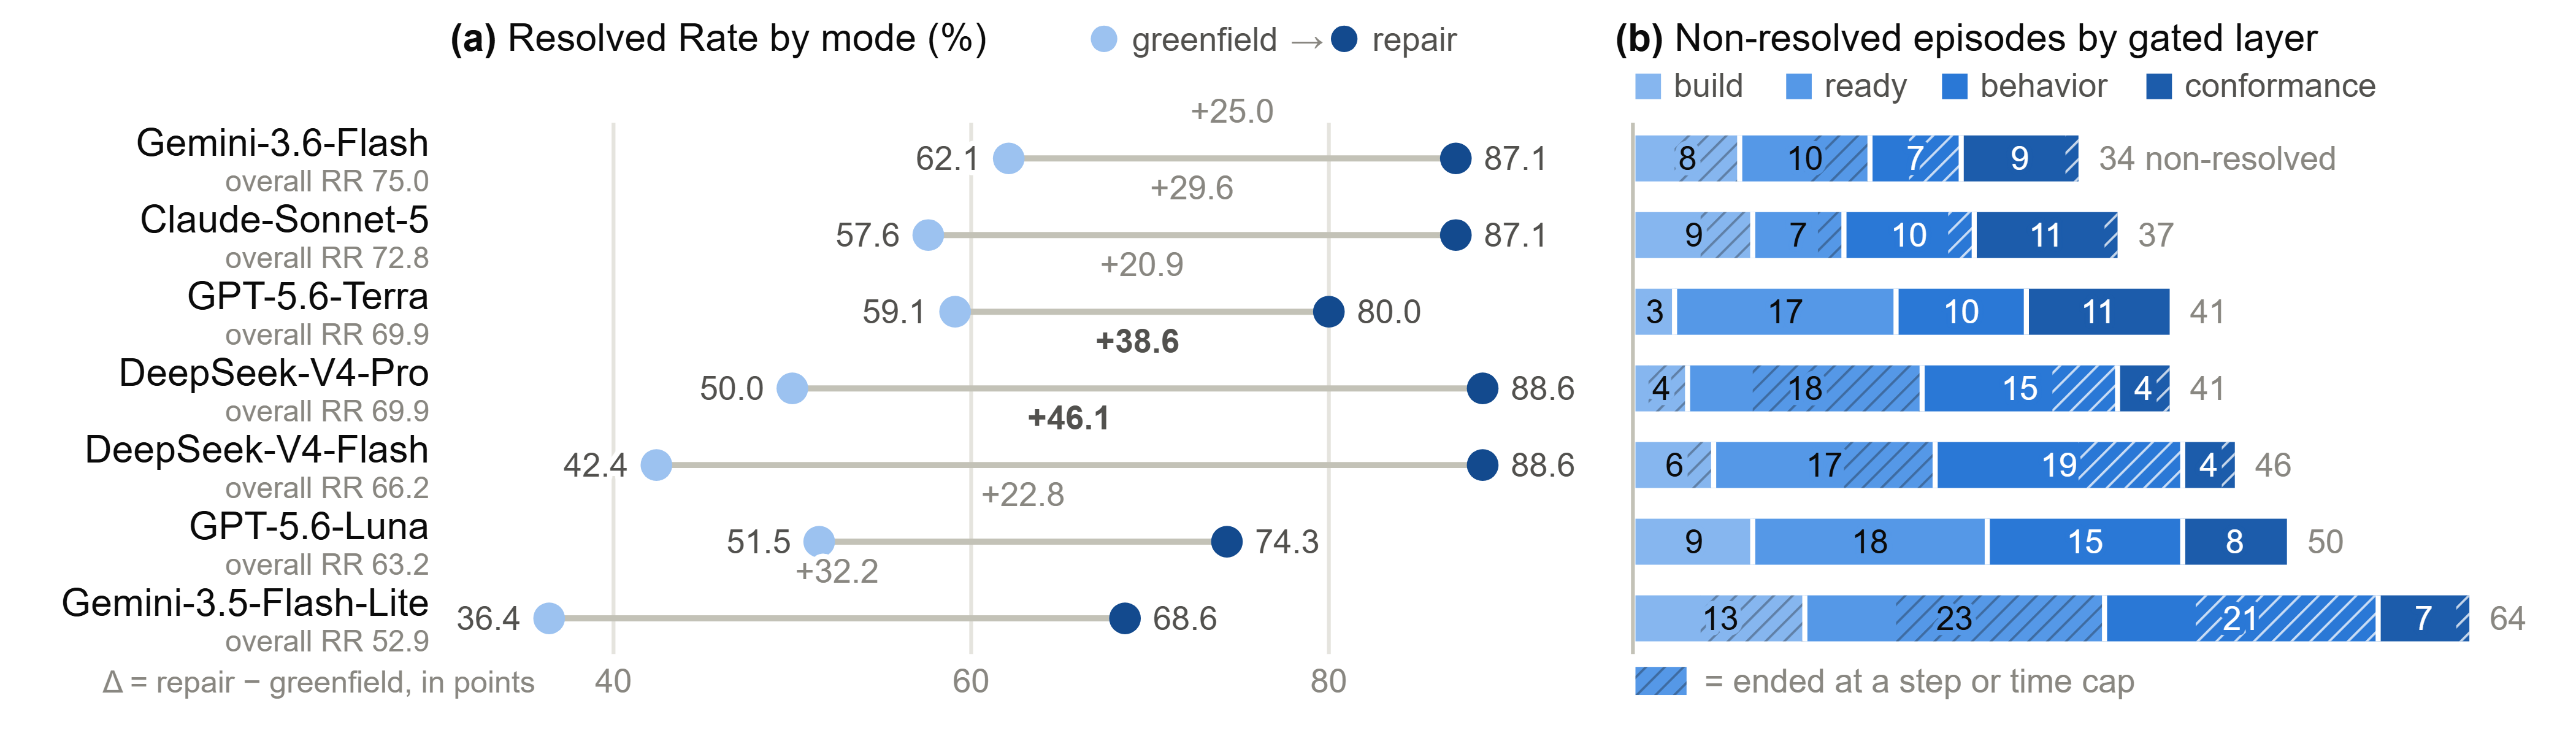
Modellerin 313 çözülemeyen çalışmasının 52’si derlemede, 110’u hazır olma, 97’si davranış ve 54’ü uyum aşamasında kalıyor. Bu bulgu, “manifest derlendi, dağıtım tamam” varsayımını zayıflatıyor. Sonraki kontrollerin değerlendirilebilmesi için önce servisin kararlı biçimde çalışması gerek. Bu başarısızlıkların 103’ü araç çağrısı veya süre sınırında sonlanmış; sınır, ayrı bir kontrol katmanı değil, çalışmanın bitiş nedenidir.
Ortalama çözüm oranı onarımda %82,0, sıfırdan kurulumda %51,3: arada 30,7 puan var. Yedi modelin hepsinde yön aynı. Fakat gruplardaki görevler farklı. Ayrıca onarım, büyük bölümü hazır olup bilerek bozulmuş bir yapılandırmayla başlıyor. Sonuç, iyi bir başlangıç dosyasının pratik değerini gösteriyor; aynı sistemi onarmanın onu sıfırdan kurmaktan doğası gereği kolay olduğunu kanıtlamıyor.
Makale, 25 tabakalı seçilmiş görevde Claude-Sonnet-5’i yönlendiren bir genç saha mühendisi de inceliyor. Mühendis 23/25 (%92), aynı görevlerdeki özerk temel ajan 18/25 (%72) çözüme ulaşıyor. Bu, insan yönlendirmesinin bu alt kümede işe yarayabildiğine dair ilginç bir örnek. Ama yalnız bir katılımcı var; daha zengin Claude Code arayüzü de devrede, çalışma süresi kaydedilmemiş ve eşleştirilmiş işaret testinde p=0,125. İnsan yargısının etkisi ayrı ölçülmediği gibi genelleştirilebilir bir insan üstünlüğü de çıkarılamaz.
Bu bulguyu nasıl kullanmalı?
Gerçek iş akışında bir dağıtım ajanını değerlendirirken ilk kabul testimiz, makaledeki yeniden kurulum fikrini izlerdi: yalnız teslim edilmiş yapılandırmayı temiz ortamda kurmak; zaman içinde hazır olmayı, servisler arası davranışı, izlemeyi ve açık koşulları test etmek. Yalnız YAML dosyasının ayrıştırılmasına değil, hangi kapıda başarısız olunduğuna bakmak gerekir. Yeni kurulumla onarımı ayrı izlemek, etkisi yüksek dağıtımlarda insan incelemesini korumak da yerinde olur.
FDE-Bench değerli bir araştırma aracı; üretim güvenliği sertifikası değil. Talepler İngilizce, görevler Linux/x86 Docker ve tek düğümlü Kubernetes ortamında, uygulamalar yaygın web servislerine benziyor. Güven aralıkları tekrarlanan çalışmalardan değil, görevler arasındaki farklardan geliyor; süreye bağlı kontroller ana makine yükünden etkilenebilir. Ayrıntılı yöntem makale ve eklerinde. Makalenin bağlantı verdiği anonim kod deposu inceleme sırasında erişim hatası döndürdüğü için benchmark’ı bağımsız olarak çalıştırmadık.
Kaynaklar
- FDE-Bench: Evaluating LLM Agents for Deployment Environment Configuration (makale ve gönderim kaydı) ↗Ding ve arkadaşları / arXiv
- FDE-Bench tam metin, sürüm 1 HTML ↗Ding ve arkadaşları / arXiv
- FDE-Bench orijinal PDF ve şekiller ↗Ding ve arkadaşları / arXiv
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder