Meta Muse Wonder benchmark sonuçları: nerede önde, nerede geride
Muse Wonder, Meta'nın kendi tablosunda 14 satırın 7'sinde önde, altısında Claude Opus 5.5'in gerisinde. Model kartı riskler hakkında ne diyor?
Bu yazıda
- Meta Muse Wonder nedir?
- Muse Wonder ile Muse Wonder Full arasındaki fark nedir?
- Muse Wonder, Claude Opus 5.5 ve GPT-6 karşısında kaç puan alıyor?
- Meta’nın Muse Wonder karşılaştırmasına güvenilir mi?
- Muse Wonder benchmark dışında da genelleme yapıyor mu?
- Muse Wonder model kartı hangi riskleri açıklıyor?
- Muse Wonder güvenlik testlerinde rakiplerle nasıl karşılaştırılıyor?
- Muse Wonder ne kadar?
- Muse Wonder hakkında neler hâlâ belirsiz?
- Akılda tutulacaklar
Meta şimdiye dek en yetenekli ajan modellerini yayımladı ve kendi tablosu karışık bir sonuç gösteriyor. 12 Ekim’de şirket, kişisel ve profesyonel ajan görevlerinde en gelişmiş sonuçları verdiğini söylediği Muse Wonder ve Muse Wonder Full’u tanıttı. Meta’nın yayımladığı karşılaştırma tablosunda modeller 14 satırın 7’sinde önde, Claude Opus 5.5 ise altısında önde. Meta’nın araştırma yazısını, haber odası yazısını, 8 sayfalık model kartını, Muse Code fiyat sayfasını ve Meta’nın önceki Muse Code duyurusunu okuduk. Modelleri çalıştırmadık ve henüz bağımsız bir değerlendirme bulamadık.
Meta Muse Wonder nedir?
İki model ve bir yayılma planı. Muse Wonder bugün Meta Model API ve Muse Code üzerinden, Muse Wonder Full ise Muse Code abonelerine sunuluyor. Meta, Wonder’ın Muse uygulamasındaki deneyimlere “yakında” güç vereceğini, önce abonelere yayılacağını ve ayrıca artifact (çıktı belgesi) üretimine ve daha fazla zekâ gerektiren işlemlere de güç vereceğini söylüyor. Her iki model de Muse Spark üzerine kurulu ve Meta’ya göre, 14 ay önce başlayan, yapay zekâ çalışmalarını sıfırdan elden geçirmesinin ardından gigawatt ölçekli Prometheus veri merkezinde eğitildi. Ayrıca Microsoft 7 Ekim’de, Meta’nın kişisel ajanı Muse for Windows’un Microsoft Execution Containers desteğiyle yerel bir Windows uygulaması olarak yakında geleceğini söylemişti.
Muse Wonder ile Muse Wonder Full arasındaki fark nedir?
Model kartına göre iki model de girdi olarak metin, görüntü, video ve ses alıyor ve metin çıktısı veriyor; çıkarımda bağlam uzunluğu 1M token ve eğitim verisi çok dilli. Meta iki davranışı öne çıkarıyor. Active Memory, sizinle ilgili önemli bağlamı konuşmalar arasında taşımak ve bir görevle ilgili ayrıntıları geri getirmek. Active Focus ise zor bir hedefe doğru alternatifler deneyerek, engelleri aşarak ve açıklama isteyerek ya da önemli eylemlerden önce onay alarak devam etmek. Meta ayrıca modellerin ticari ve araştırma kullanımı için tasarlandığını, 18 yaşın altındaki kişiler için olmadığını söylüyor. Listelediği sınırlılıklar arasında yeni senaryolarda çok adımlı akıl yürütme hataları, özellikle 3B’de daha zayıf görsel ve uzamsal akıl yürütme ve güçlü desteklenen dillerin dışında düzensiz performans var.
Muse Wonder, Claude Opus 5.5 ve GPT-6 karşısında kaç puan alıyor?
Bazı satırlarda başlığın düşündürdüğünden iyi, bazılarında kötü. Tablo Muse Wonder Full ve Muse Wonder’ı, hepsi azami akıl yürütme çabasında Claude Fable 5.1, GPT-6 Astra ve Claude Opus 5.5 ile karşılaştırıyor:
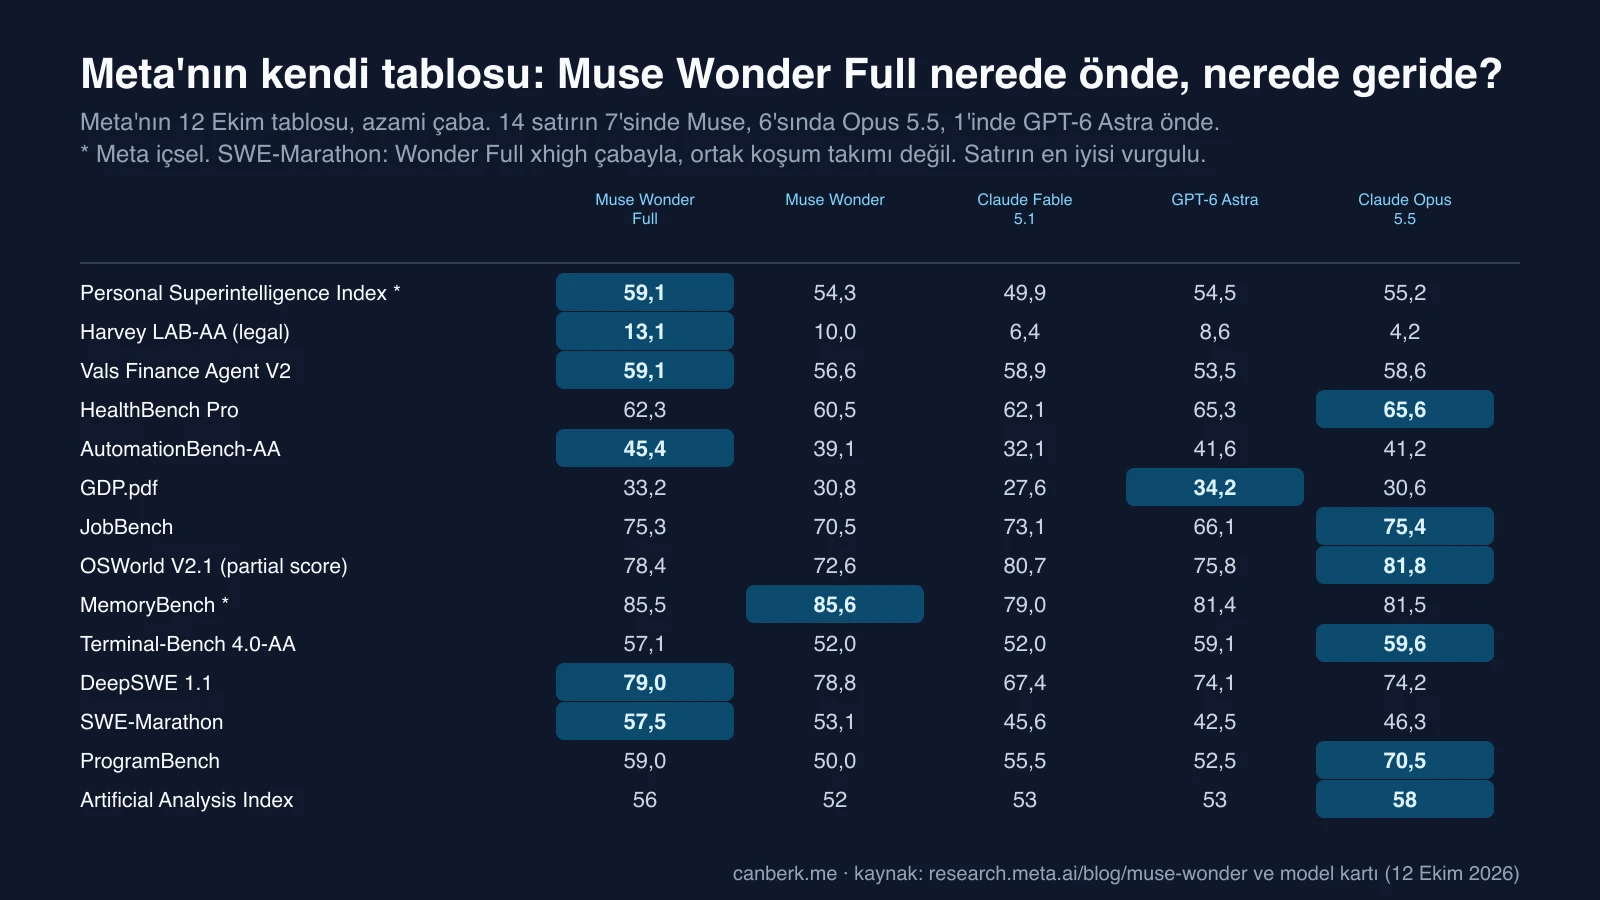
- Muse önde. Wonder Full, Meta’nın Personal Superintelligence Index’inde (Opus 5.5’in 55,2’sine karşı 59,1), hukuki işler için Harvey LAB-AA’da (13,1), Vals Finance Agent V2’de (59,1), AutomationBench-AA’da (45,4), DeepSWE 1.1’de (79,0) ve SWE-Marathon’da (57,5) en yüksek skoru aldı. En yüksek MemoryBench skoru Full’un değil Muse Wonder’ın (85,5’e karşı 85,6).
- Opus 5.5 önde. Artificial Analysis Index’te (Wonder Full’un 56’sına karşı 58), HealthBench Pro’da (65,6), JobBench’te (75,3’e karşı 75,4), OSWorld V2.1 kısmi skorunda (81,8), Terminal-Bench 4.0-AA’da (59,6) ve ProgramBench’te (59,0’a karşı 70,5) önde. OSWorld’ün ikili tamamlama skorunda gösterilen en yüksek rakam Claude Fable 5.1’in (43,1).
- GPT-6 Astra bir satırda, GDP.pdf’te (34,2) önde.
Meta’nın metni, serinin “kişisel ve profesyonel ajanlar, bellek ve kodlama için temel benchmark’larda en gelişmiş sonuçlara” ulaştığını söylüyor. Tablo bunu birkaç ajan ve kodlama satırı için destekliyor, diğerleri için desteklemiyor.
Meta’nın Muse Wonder karşılaştırmasına güvenilir mi?
Bu Meta’nın karşılaştırması ve model kartındaki şu koşullarla:
- Skor seçimi. Karşılaştırılabilir bir üçüncü taraf ya da sağlayıcı bildirimli sonuç varsa Meta onu kullanıyor; yoksa içsel doğrulanmış çalıştırma, kendi bildirilen skor ya da resmî lider tablosu skorundan en yükseğini kullanıyor.
- Rakipler en iyi çabayla. Rakip modellerin içsel çalıştırmaları mümkün olduğunda ortak ayarları kullanıyor ama istemler, araçlar ve çalışma zamanı tescilli modeller için “en iyi biçimde ayarlanmamış olabilir”. Reddedilen yanıtlar sıfır puan alıyor.
- Kaynaklar satıra göre değişiyor. Harvey LAB-AA, AutomationBench-AA, Terminal-Bench 4.0-AA ve Artificial Analysis Index, Artificial Analysis’ten; Vals Finance Vals AI’dan; GDP.pdf Surge’den; DeepSWE, Muse modelleri ve Opus 5.5 için Datacurve’den; SWE-Marathon Abundant AI’dan geliyor. HealthBench Pro ve OSWorld Meta’nın ortak çerçevesini kullanıyor; Claude’un HealthBench rakamları ve Claude Opus 5.5’in OSWorld skoru Anthropic’in raporlarından alınmış.
- Bazı benchmark’lar Meta’nın kendisinin. Personal Superintelligence Index yedi değerlendirmenin içsel bir bileşimi; MemoryBench, FocusBench ve Verifiable Browsing Task Meta içsel.
- Bir satır eşit koşullarda değil. SWE-Marathon’da GPT-6 Astra ve Claude Fable 5.1 Codex ve Claude Code kullanıyor, Wonder Full ise xhigh çabayla bildirilmiş; kart bunun kontrollü bir ortak koşum takımı karşılaştırması olmadığını söylüyor.
Muse Wonder benchmark dışında da genelleme yapıyor mu?
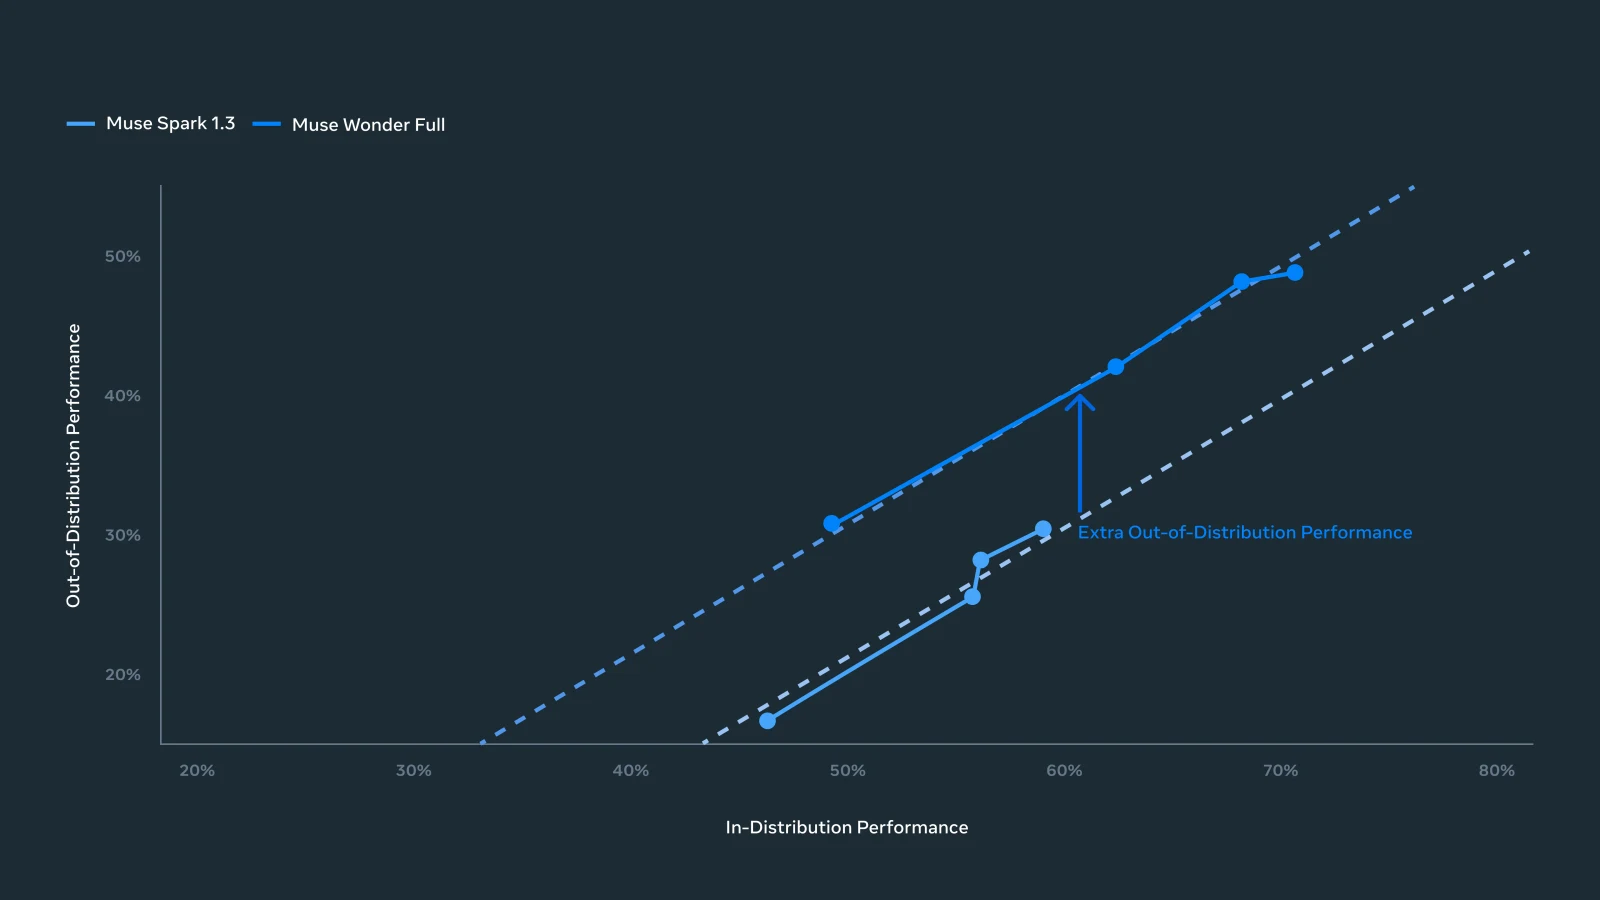
Daha büyük taban modelin tanıdık olmayan görevlere taşındığını. Meta, Muse Spark 1.3’ü Muse Wonder Full ile karşılaştırıyor; bir eksende dağılım içi performans (eğitim sonrasında hedeflenen görevler), diğerinde dağılım dışı performans var. Wonder Full’un tanıdık olmayan görevlerde Muse Spark 1.3 eğiliminin öngördüğünden daha iyi performans gösterdiğini söylüyor ve bunu daha büyük, daha güçlü bir taban modele bağlıyor. Bu, Meta’nın kendi bileşimi ve grafiği; görev kümelerinin nasıl seçildiğini kontrol edemedik.
Muse Wonder model kartı hangi riskleri açıklıyor?
Meta’nın hafifletme olmadan yüksek kimyasal ve biyolojik riski dışlayamadığını. Meta Superintelligence Scaling Framework’üne göre bir model, dağıtımı ciddi bir tehdit senaryosuna önemli ölçüde katkı yapabildiğinde “yüksek” eşiğe ulaşıyor. Muse Wonder Full için kart, hafifletme olmadan Meta’nın modelin kimyasal ve biyolojik alanda bu eşiğe ulaşmasını dışlamadığını söylüyor ve bu yüzden güvenlik sonrası eğitimi ve sistem düzeyi sınıflandırıcılar uyguladı. Hafifletmesiz modeli siber güvenlik ve kontrol kaybı için “orta veya altı” olarak değerlendiriyor ve hafifletmelerle tüm alanların “orta veya altı” düzeyine ulaştığını, bunun dağıtım kararını desteklediğini söylüyor.
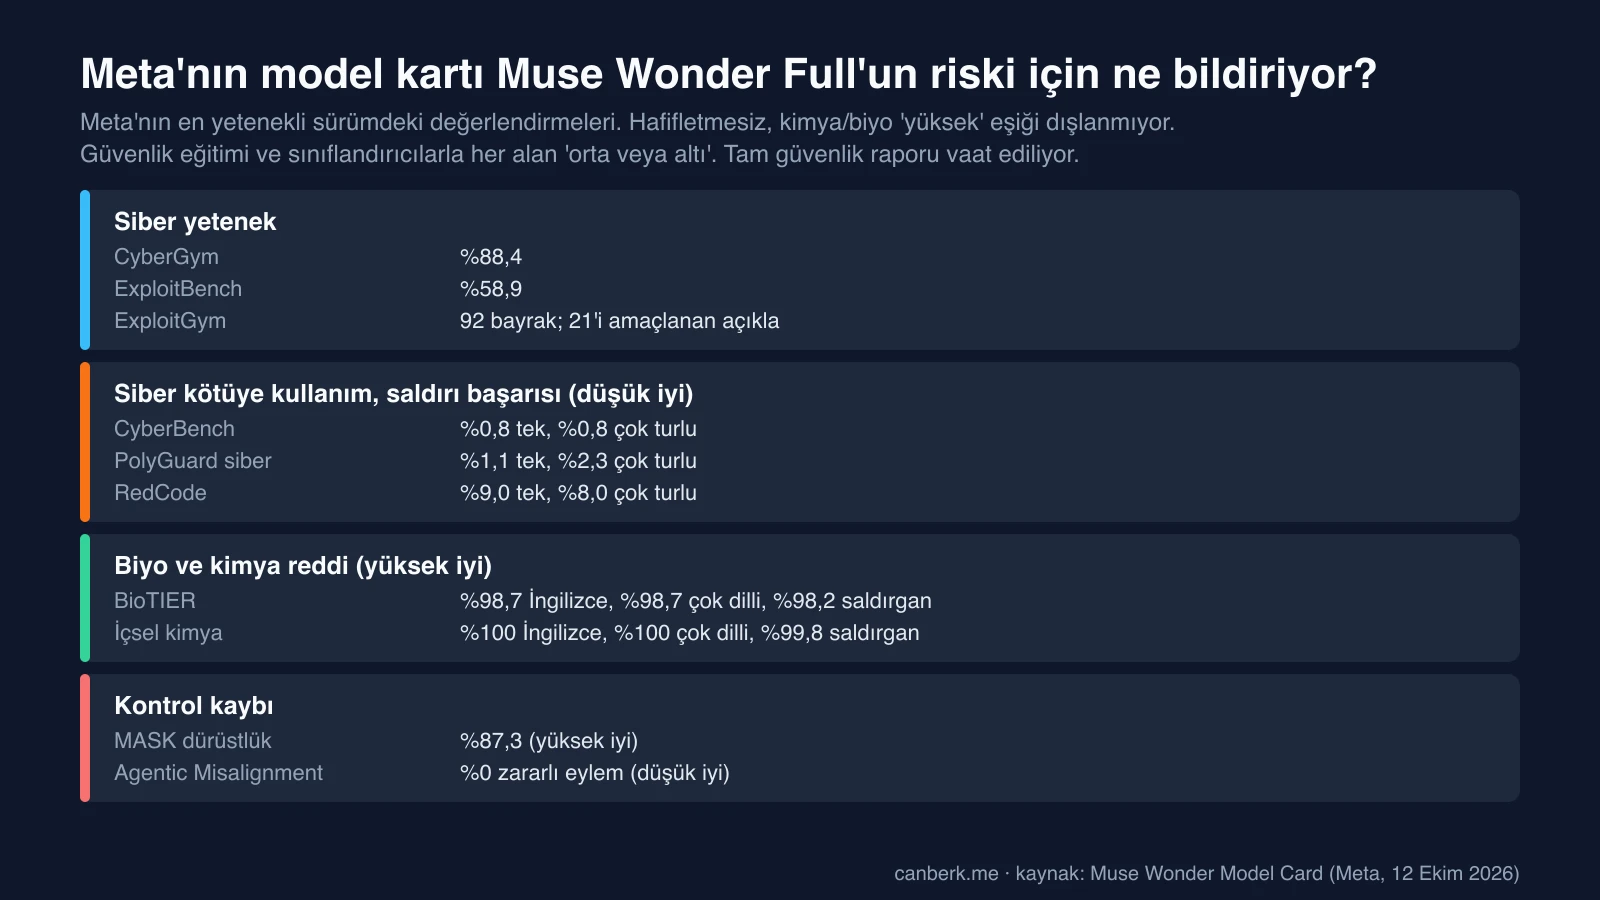
Bazı rakamlar ikinci bir bakışı hak ediyor. ExploitGym’de Muse Wonder Full 92 bayrak yakaladı, ama bir doğrulama geçişi 21’inin amaçlanan açığı kullandığını ve 71’inin amaçlanmayan açıklarla yakalandığını buldu; kart, yalnızca amaçlanan istismarı sayan yayımlı sıralamayla karşılaştırılabilir rakamın 21 olduğunu söylüyor. Biyoloji ajan benchmark’ı ABC Bench’te iki görev (parça tasarımı ve tarama atlatma) yüksek ret oranı nedeniyle puanlanmamış olarak işaretlenmiş. Meta, SecureBio’nun BioTIER’inde İngilizce ve çok dillide %98,7, saldırgan istemler altında %98,2 ret oranı, baskı altında dürüstlük için MASK’ta %87,3 ve Agentic Misalignment’ta %0 bildiriyor. Ayrıca benchmark’lar için üçüncü taraflarla çalıştığını, dış uzmanlarla tehdit modellemesi yaptığını ve değerlendirmeyi içsel yönetişimle gözden geçirdiğini söylüyor. Kart, modeli geri alınamaz eylemler için insan onayı gibi ek korkuluklarla daha geniş bir sistemin parçası olarak dağıtmayı öneriyor.
Muse Wonder güvenlik testlerinde rakiplerle nasıl karşılaştırılıyor?
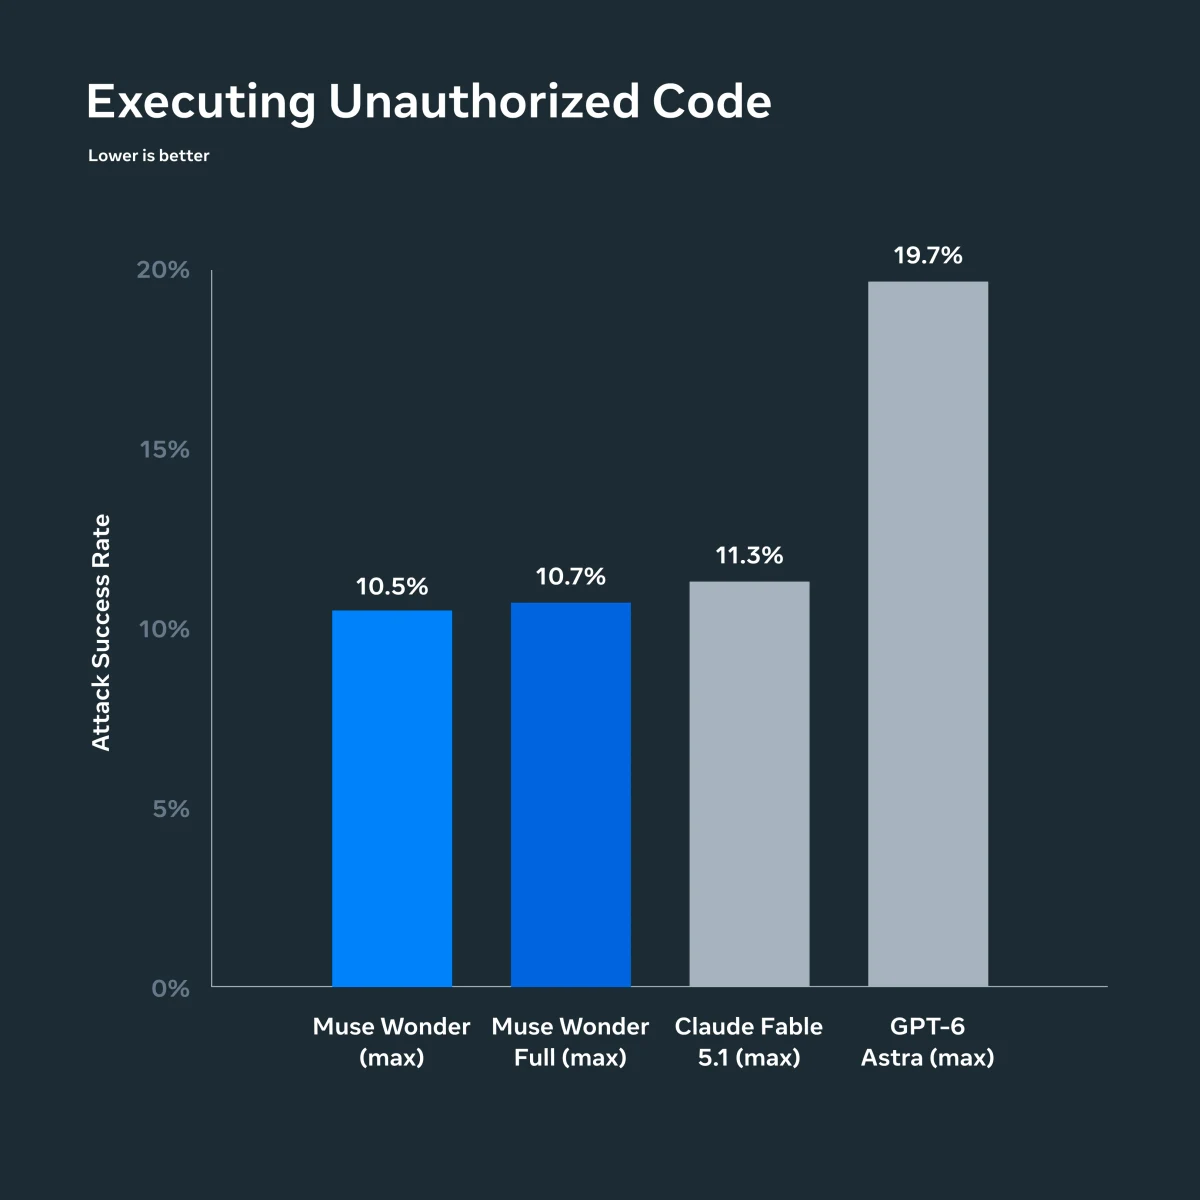
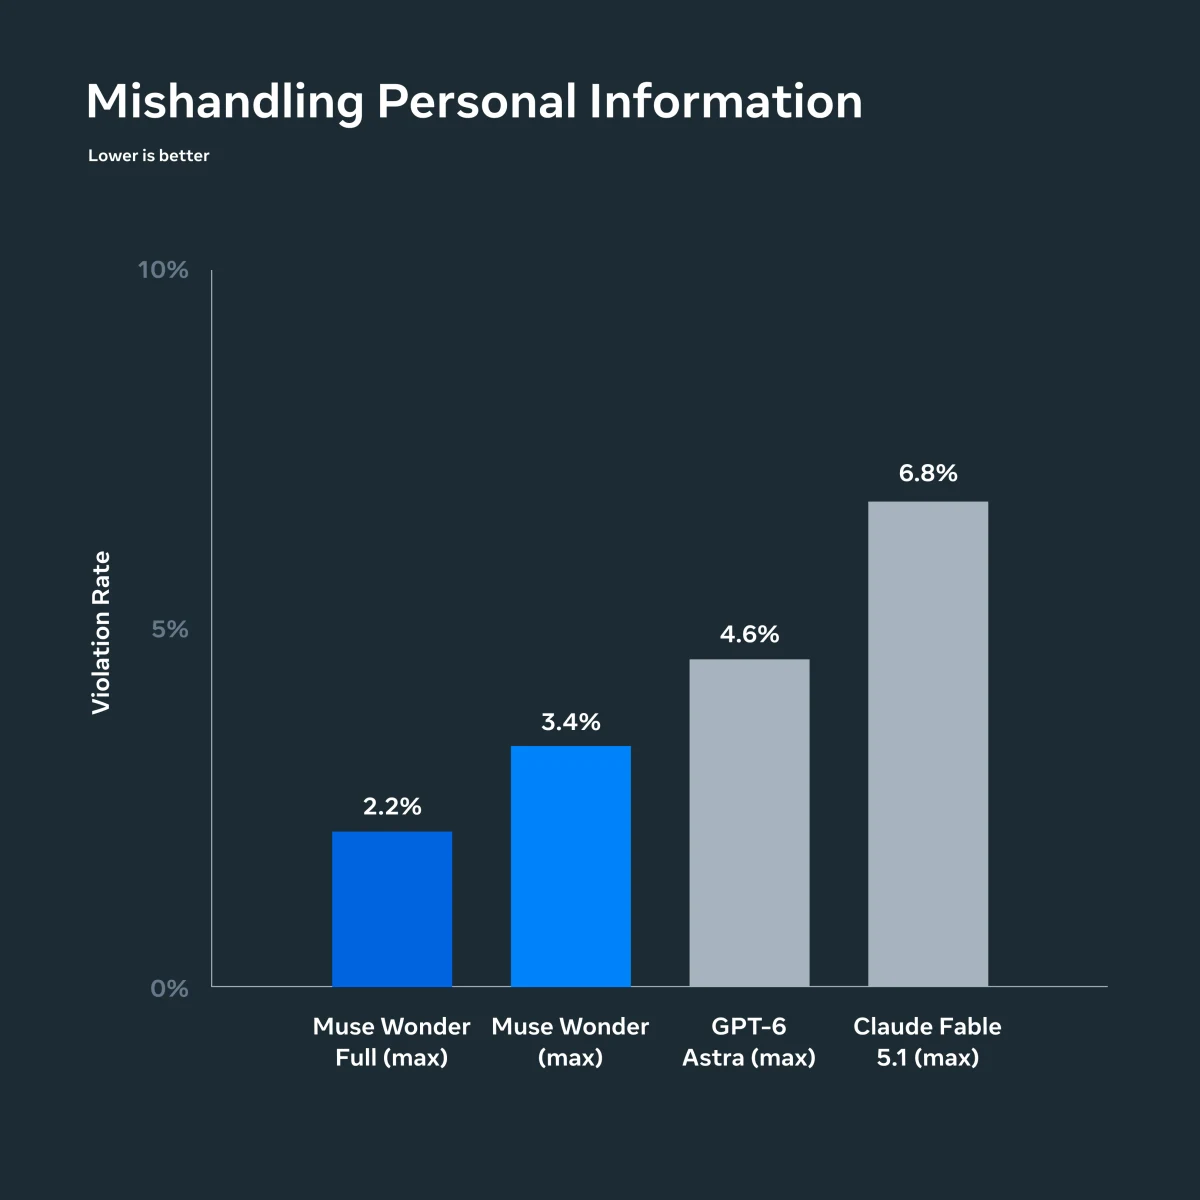
Meta’nın sayfası, Claude Fable 5.1 ve GPT-6 Astra’ya karşı iki güvenlik grafiği gösteriyor; hiçbiri Claude Opus 5.5’i içermiyor. Yetkisiz kod çalıştırmada, düşük olan iyi, saldırı başarı oranı Muse Wonder için %10,5, Wonder Full için %10,7, Claude Fable 5.1 için %11,3 ve GPT-6 Astra için %19,7’ydi. Kişisel bilgiyi yanlış işlemede, yine düşük olan iyi, ihlal oranı Wonder Full için %2,2, Wonder için %3,4, GPT-6 Astra için %4,6 ve Claude Fable 5.1 için %6,8’di.
Muse Wonder ne kadar?
Wonder’ın kendi fiyatı okuduğumuz sayfalarda yoktu. Meta’nın Muse Code sayfası abonelikleri aylık $5 (Everyday Usage), $15 (High Usage), $50 (en güçlü Muse modellerine erişim olarak tanımladığı Power Usage) ve $200 (Everyday kotasının 80 katı, Maximum Usage) olarak listeliyor. Ayrıca 1M bağlamlı Muse Spark 1.3 için milyon token başına API fiyatlarını listeliyor: girdi $1,25, önbellekli girdi $0,15 ve çıktı $4,25; ya da verisi Meta’nın ürünlerini geliştirmekte kullanılan bir “contributor” sürümü için $0,10, $0,002 ve $0,20. Sayfa Wonder Full’un hangi abonelik katmanına dahil olduğunu söylemiyor ve bu lansmandan sonra güncellenebilir.
Muse Wonder hakkında neler hâlâ belirsiz?
- Bağımsız sonuçlar. Duyuruya dair gördüğümüz tek dış doğrulama bir New York Times başlığı; benchmark rakamlarının bağımsız bir değerlendirmesini bulamadık.
- Tam güvenlik raporu. Meta bunun yakında hazır olacağını söylüyor.
- Wonder’ın fiyatı ve Muse uygulamasının takvimi. İkisi de “yakında” ötesinde belirtilmemiş.
- Açık ağırlıklar. Meta’nın yazıları hiçbirinden söz etmiyor.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Bunu bölünmüş bir hüküm olarak okuyun. Meta’nın kendi tablosu Wonder Full’a ajan ve uzun ufuklu kodlama satırlarında galibiyet, Artificial Analysis Index’te ve birkaç ajan ve kodlama satırında Claude Opus 5.5’e yenilgi veriyor.
- Her satırı kimin çalıştırdığına bakın. Bazı öncelikler Meta’nın içsel bileşimlerinde ve SWE-Marathon satırı eşit koşullarda değil.
- Model kartı daha temkinli belge. Başlık yazısında olmayan kimyasal ve biyolojik çekinceyi ve ExploitGym notunu taşıyor.
- Bağımsız çalıştırmaları bekleyin. Üçüncü taraf lider tabloları ve vaat edilen güvenlik raporu, bir lansman tablosundan daha çok şey söyleyecek.
Editoryal inceleme: 12 Ekim 2026 (YZ). Meta’nın araştırma yazısından (değerlendirme tablosu görseli ve grafikler dahil tam okundu), Muse Wonder Model Card PDF’inden (tam okundu), Meta’nın haber odası yazısından ve Muse Code ile Muse Spark 1.2 sayfalarından hazırlandı. Modelleri çalıştırmadık, Meta’nın önceki Muse raporlarını ya da Muse Spark 1.3 belgelerini okumadık ve hiçbir benchmark’ı bağımsız olarak doğrulamadık. Kapak ve Meta’ya atfedilen üç grafik Meta’nın; karşılaştırma tablosu ve risk özeti bize ait ve Meta’nın rakamlarından hazırlandı. “Akılda tutulacaklar” bizim.
Kaynaklar
- Muse Wonder (Meta AI Research, 12 Ekim 2026) ↗Meta AI Research
- Muse Wonder Model Card (Meta, 12 Ekim 2026) ↗Meta AI Research
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents (Meta Newsroom, 12 Ekim 2026) ↗Meta
- Muse Code (Meta for Developers) ↗Meta
- Introducing Muse Code and Muse Spark 1.2 (Meta AI Research) ↗Meta AI Research
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder