METR'in zaman ufku grafiği yeniden uyduruldu: Berkeley makalesi 2 ile 30 dakika arasında düz bir bölge buluyor
İki Berkeley istatistikçisi METR'in 228 görevlik verisini yeniden uydurdu: tahminler iyileşiyor, 2-30 dakikada insan süresi zorluğu zayıf izliyor.
Bu yazıda
METR’in zaman ufku grafiği, yapay zekâ ilerleme tartışmalarında belki de en çok alıntılanan grafik; yeni bir istatistik ön baskısı ise y ekseninin göründüğü kadar sağlam bir cetvel olmadığını savunuyor. Drew Nguyen ve William Fithian (UC Berkeley İstatistik Bölümü; arXiv, 8 Ekim) METR’in açık verisini daha esnek modellerle yeniden uyduruyor. Uydurmaları tutulan sonuçları daha iyi tahmin ediyor ve insan görev süresinin 2 ile 30 dakika arasında yapay zekâ zorluğunu yalnızca zayıf izlediğini gösteriyor. Tam metni okuduk; uydurmaları yeniden çalıştırmadık ve sayfada hakem değerlendirmesi durumu yok. Bu yazı, TestJack’in kodlama benchmark’ı denetimi gibi benchmark geçerliliği makalelerini okuma çizgimizin devamı.
METR zaman ufku nedir?
Bir yapay zekânın %50 olasılıkla çözdüğü yazılım görevlerinin insan tamamlama süresi. Makalenin örneği: GPT-4’ün tahmini ufku 4 dakika; yani bir insanın yaklaşık 4 dakikada bitirdiği bir görevde yaklaşık yarı yarıya başarılı oluyor. METR’in verisinde 79 görev ailesine yayılmış 228 elle hazırlanmış yazılım görevi var; her birinin bir “insan süresi” (mühendislerin zamanlı, başarılı denemelerinin geometrik ortalaması) ve otomatik bir puanlayıcısı bulunuyor. Görevlerin %29’unda bu ölçümler elde edilemedi ya da geçersizdi ve bir uzmanın değeri kullanıldı. Yapay zekâlar her görevde tekrar tekrar çalıştırıldı. Makaleye göre açık grafik, Mayıs 2026’daki Claude Mythos’a kadar sürüm sürüm güncellendi.
Yazarlar ne değiştirdi?
Veriyi tutup modeli değiştiriyorlar. Temel model, bir METR araştırma notunda (Barry, 2026) anlatılan, ortak eğimli lojistik regresyon; yapay zekâ zorluğunun insan süresinin logaritmasında doğrusal olduğunu varsayıyor. Makale iki model ekliyor:
- Model 1, doğrusal terimi ortak bir monoton spline ile (dört iç düğümlü kübik I-spline) değiştiriyor.
- Model 2, görev ailesi etkisi ve tekrarlanan çalıştırmalar için bir korelasyon parametresi içeren bir madde tepki (Rasch tipi) modeli. Gauss-Hermite kareleme ile bir EM algoritmasıyla uydurulmuş.
Yeni uydurmalar daha iyi tahmin ediyor mu?
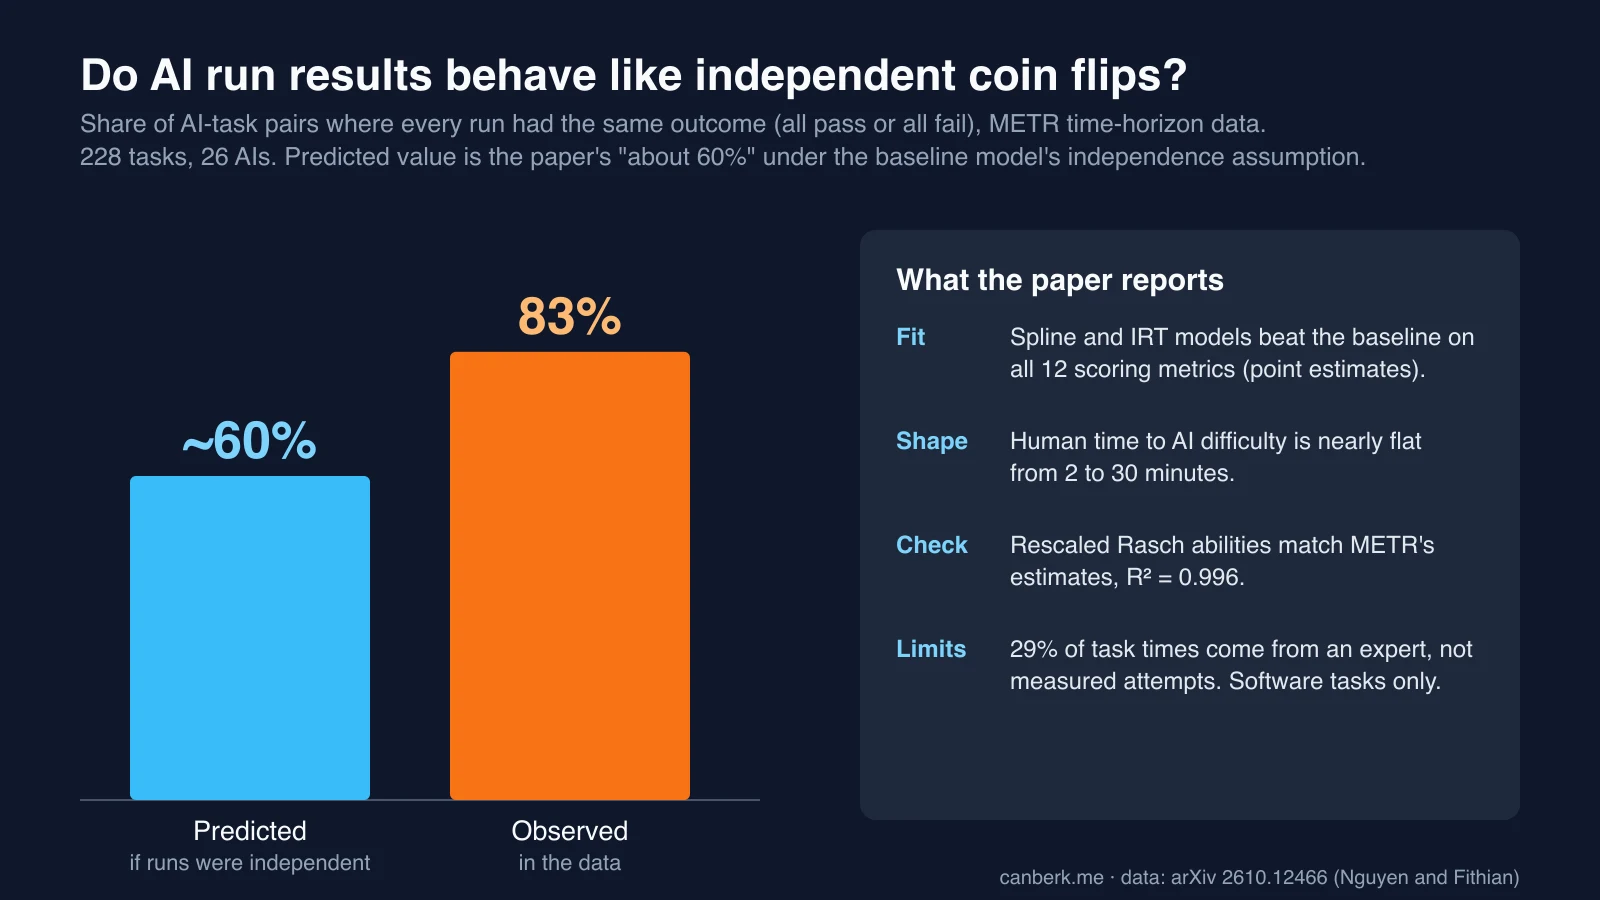
Nokta tahmininde evet, kesinlik konusunda çekinceyle. 79 görev ailesi üzerinde 5 katlı çapraz doğrulamayla yazarlar dört ölçütü (marjinal log skor, Brier skoru ve iki yumuşatılmış temel skor) üç görev ağırlıklandırması altında, toplam 12 tane, hesaplıyor. İki yeni model de hepsinde temel modeli geçiyor. Kazancın çoğu ufku 2-15 dakika olan yapay zekâlardan geliyor ve bunların bazılarının tahmini ufku özgün grafiğin %95 aralıklarının dışına düşüyor. Ancak yapay zekâ başına güven aralıkları çoğunlukla sıfırdan ayrılamayacak kadar geniş; kanıt yalnızca havuzlanmış karşılaştırmada birikiyor. Temel model ise METR’in özgün yapay zekâ başına lojistik uydurmasını 12 ölçütün biri dışında hepsinde zaten geçiyordu.
Düz bölge neden önemli?
Çünkü o zaman bir zaman ufku sıçraması farklı yerlerde farklı anlama geliyor. İnsan süresinden yapay zekâ zorluğuna uyan eğri 2 ile 30 dakika arasında neredeyse düz, başka yerlerde kabaca doğrusal. 3 dakikadan 30 dakikaya çıkış, 30 dakikadan 5 saate çıkıştan çok daha kolay; ikisi de ufku on katlıyor. Yazarların koşullu başarı grafiğinde 4 dakikalık bir yapay zekâdan 15 dakikalık bir yapay zekâya adım oldukça küçük görünüyor. Düz demek, o bantta insan süresinin yapay zekânın hangi görevleri çözeceği hakkında az şey söylemesi demek.
Çalıştırma sonuçları bağımsız mı?
Hayır ve fark büyük. Her çalıştırma, temel modelin uydurduğu başarı olasılığıyla bağımsız bir çekiliş olsaydı, yapay zekâ-görev çalıştırma kümelerinin yaklaşık %60’ı oybirliği (hepsi geçer ya da hepsi kalır) olurdu. Verideki oran %83. Yazarlar bunu bir aşırı dağılım terimiyle modelliyor; bu terim aynı zamanda çok sayıda çalıştırması olan yapay zekâ-görev çiftlerinin ağırlığını azaltıyor.
Bu, üstel eğilimi çürütüyor mu?
Makale çürütmediğini söylüyor. Sürüm tarihleri uydurmada hiç kullanılmıyor ve yazarlar grafikte görülen üstel büyümeye itiraz etmediklerini yazıyor. Sorguladıkları, birimin yorumu. Modellerinin insan süresi dönüşümünü yok sayan Rasch yeteneklerini ölçeklediklerinde sonuç METR’in tahminleriyle neredeyse örtüşüyor (R-kare 0,996). Okumaları şöyle: doğrusal model “başka bir yapay zekâ yetenek yapısını farkında olmadan tahmin ediyor olabilir” ve dönüşüm gerçekten doğrusal değilse, nicelik hâlâ yararlı bir yetenek ölçüsü olsa da zaman ufku diye adlandırılmamalı.
Sınırlılıklar neler?
Yazarlar sıralıyor. Görevlerin gerçek işi temsil ettiğini, iki sayılı zorluk modelinin uyduğunu ve insan süresinin görevler arasında tutarlı bir anlama sahip olduğunu sınamadan varsayıyorlar; tanılamaları yalnızca sürenin zorluğu tahmin edip etmediğine ve aralıklar arasında karşılaştırılabilir olup olmadığına bakıyor. Verileri METR’inki; yalnızca yazılım görevleri, insan süreleri yaklaşık 30 saate kadar ve görevlerin %29’u için uzman değerleri. Ayrıca takımın daha uzun görevlerle genişletilmesi hâlinde kabaca doğrusal ilişkinin korunacağının garantisi olmadığını, sonraki aralıkların yine düz ya da dik olabileceğini ve bunu bir doğrusallık kontrolünün değil yalnızca kendi tanı grafiklerinin göstereceğini ekliyorlar. Bu, iki yazarın tek bir açık veri kümesi üzerindeki tek bir yeniden analizi.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Ufukları aralıklarıyla birlikte aktarın. Bir ikiye katlanma süresi alıntılıyorsanız, makalenin uydurmasına göre on katlık bir sıçramanın grafiğin her yerinde aynı büyüklükte olmadığını belirtin.
- İlerlemenin yönü değişmiyor. Yazarlar gözlenen büyümeyi verili alıyor ve yalnızca birimlerin ne anlama geldiğini sorguluyor.
- Çalıştırmalar arası korelasyon her benchmark için önemli. Çalıştırmalar bağımsız denemelerden çok daha fazla oybirliği veriyorsa, birkaç çalıştırmanın ortalamasını almak taşıdıkları bilgiyi olduğundan büyük gösterir. Değerlendirme boyutlandıran herkes için bir nokta bu; ayrıca tek bir benchmark skorunun testin nasıl yazıldığına göre kayabilmesiyle örtüşüyor.
Editoryal inceleme: 10 Ekim 2026 (YZ). arXiv 2610.12466’nın (v1, 8 Ekim) tam metninden hazırlandı; HTML sürümü, Bölüm 1-4 ve ek şekil başlıkları dahil okundu. Modelleri yeniden çalıştırmadık, METR’in veri ve notlarına bakmadık; grafik bize ait ve yalnızca Bölüm 2.3’te belirtilen rakamları kullanıyor. “Akılda tutulacaklar” bizim.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder