Naive-N0.5-Flash: kodlama ve yapay zekâ araştırması için açık ağırlıklı model
NaiveAI'ın 309 milyar parametreli MoE modeli, token başına 15,5 milyar parametreyi etkinleştiriyor ve doğal 1 milyon token bağlam sunuyor. Mimari, hız iddiası ve erişim durumu.
Bu yazıda
NaiveAI, kodlama ve yapay zekâ araştırmasına odaklanan açık ağırlıklı Naive-N0.5-Flash modelini 27 Eylül 2026’da duyurdu. FP8 model kartına göre uzmanlar karması (MoE) mimarisinde toplam 309 milyar parametre var; her token için bunların 15,5 milyarı etkinleşiyor. Etkin parametre sayısı, token başına seçilen hesaplamayı anlatıyor. Bu, modeli dizüstü bilgisayara sığan 15,5 milyar parametreli bir modele dönüştürmüyor. NaiveAI, çalıştırma için gereken ek bellek hariç, yalnızca ağırlıkların yaklaşık 315 GB yer kapladığını belirtiyor.
Sürümün temel mühendislik iddiası, doğal bir milyon tokenlık bağlamı tam dikkat katmanı olmadan kullanabilmesi. Dosyaların, araç çıktılarının ve önceki kararların biriktiği uzun kodlama ve araştırma oturumlarında bu önemli olabilir. Ancak bağlam sınırı, bir milyon token içindeki her bilginin doğru bulunacağını garanti etmiyor. Bu, gerçek görevlerle ayrıca sınanmalı.
Uzun bağlam nasıl çalışıyor?
| Yayımlanan teknik özellik | Naive-N0.5-Flash |
|---|---|
| Model | MoE; toplam 309 milyar, etkin 15,5 milyar parametre |
| Bağlam | Doğal 1 milyon token |
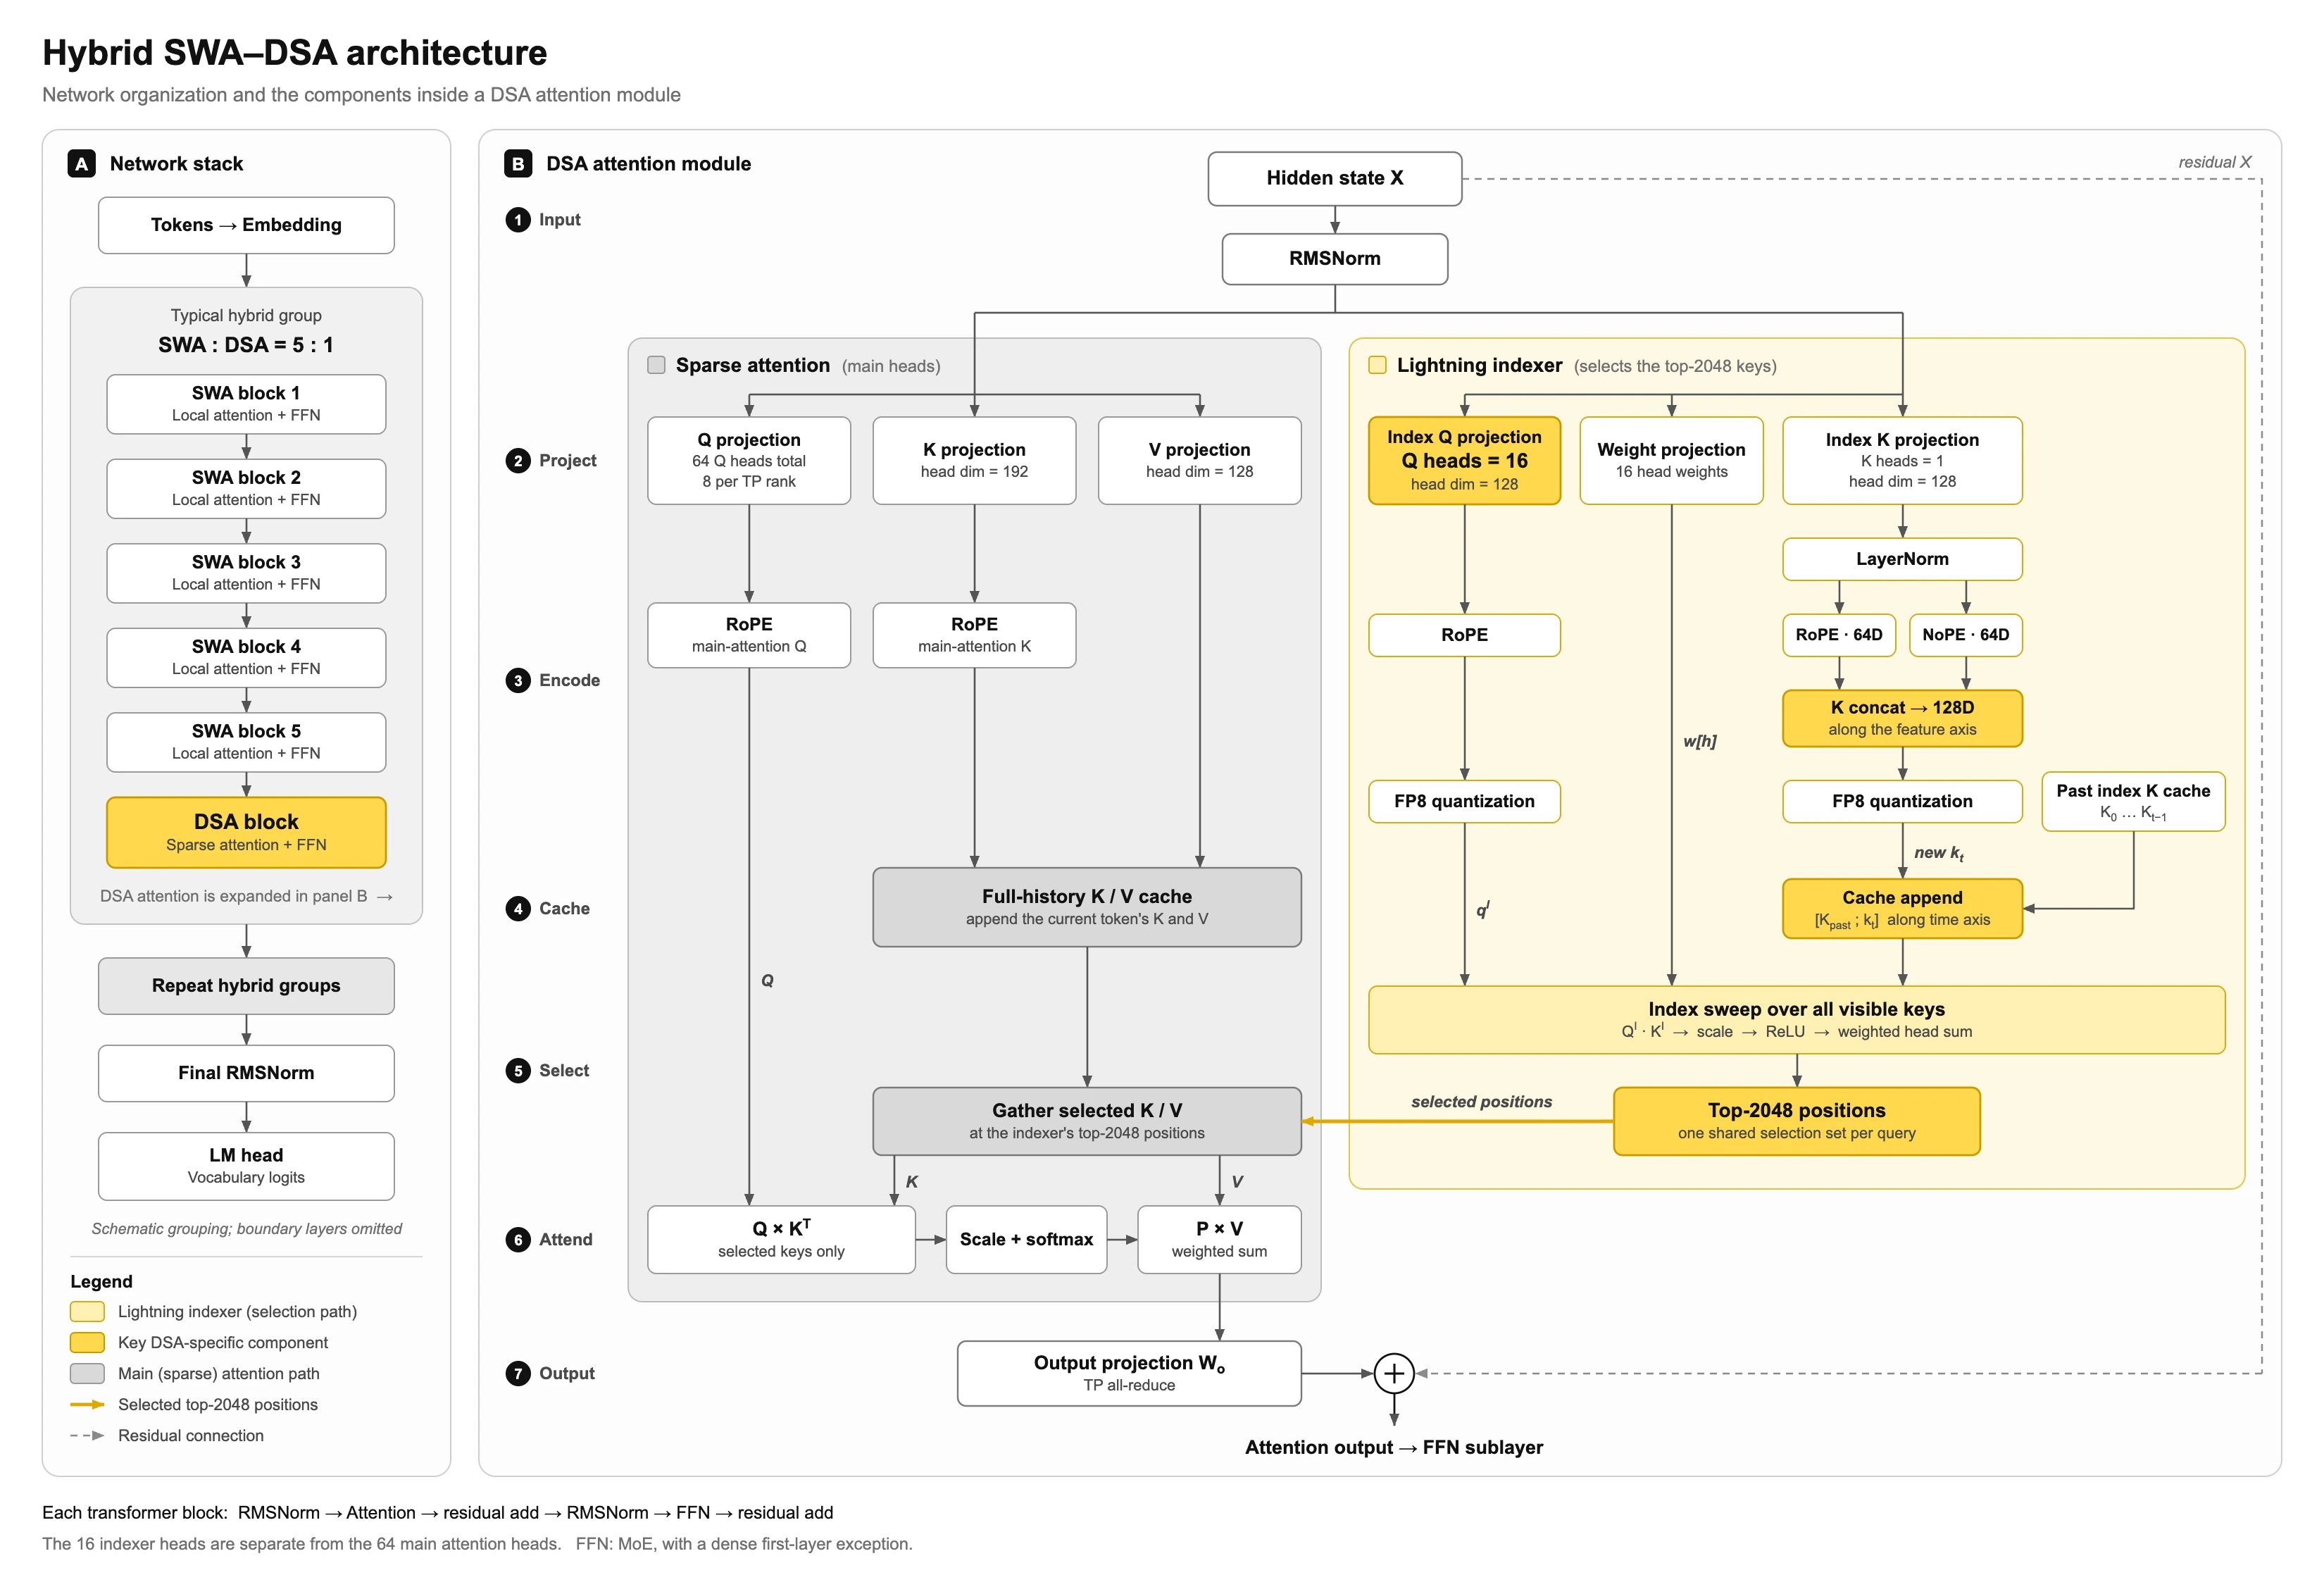
| Dikkat katmanları | 48 katman: 39 kayan pencere (SWA), 9 DeepSeek Seyrek Dikkat (DSA) |
| Yerel ve seyrek seçim | SWA penceresi 128 token; DSA’nın ana dikkat hesabında en yüksek puanlı 2.048 token |
| DSA gruplaması | Dört KV grubu (GQA4); 16 indeksleyici sorgu başı |
| FP8 çalıştırma | Yaklaşık 315 GB ağırlık; ek GPU belleği gerekiyor |
Katmanların çoğu kısa bir yerel pencereye bakıyor. Dokuz katmanda hafif bir indeksleyici geçmişi puanlayıp ana dikkat hesabına girecek tokenları seçiyor. Bu, ana hesaplamanın yükünü azaltıyor; yine de indeksleyici geçmişi tarıyor ve anahtar-değer önbelleğinin tamamı tutuluyor. Dolayısıyla “tam dikkat yok”, bağlam uzadıkça bellek gereksinimi artmıyor demek değil. Model kartı, modelin Xiaomi’nin açık MiMo-V2.5 temelinden geliştirildiğini ve üç aşamada 3,25 trilyon tokenla uyarlandığını söylüyor: indeksleyici hazırlığı için 50 milyar, seyrek dikkat eğitimi için 3 trilyon, öğrenme oranını düşürme aşaması için 200 milyar token.
Kodlama ve araştırma sonuçları nasıl okunmalı?
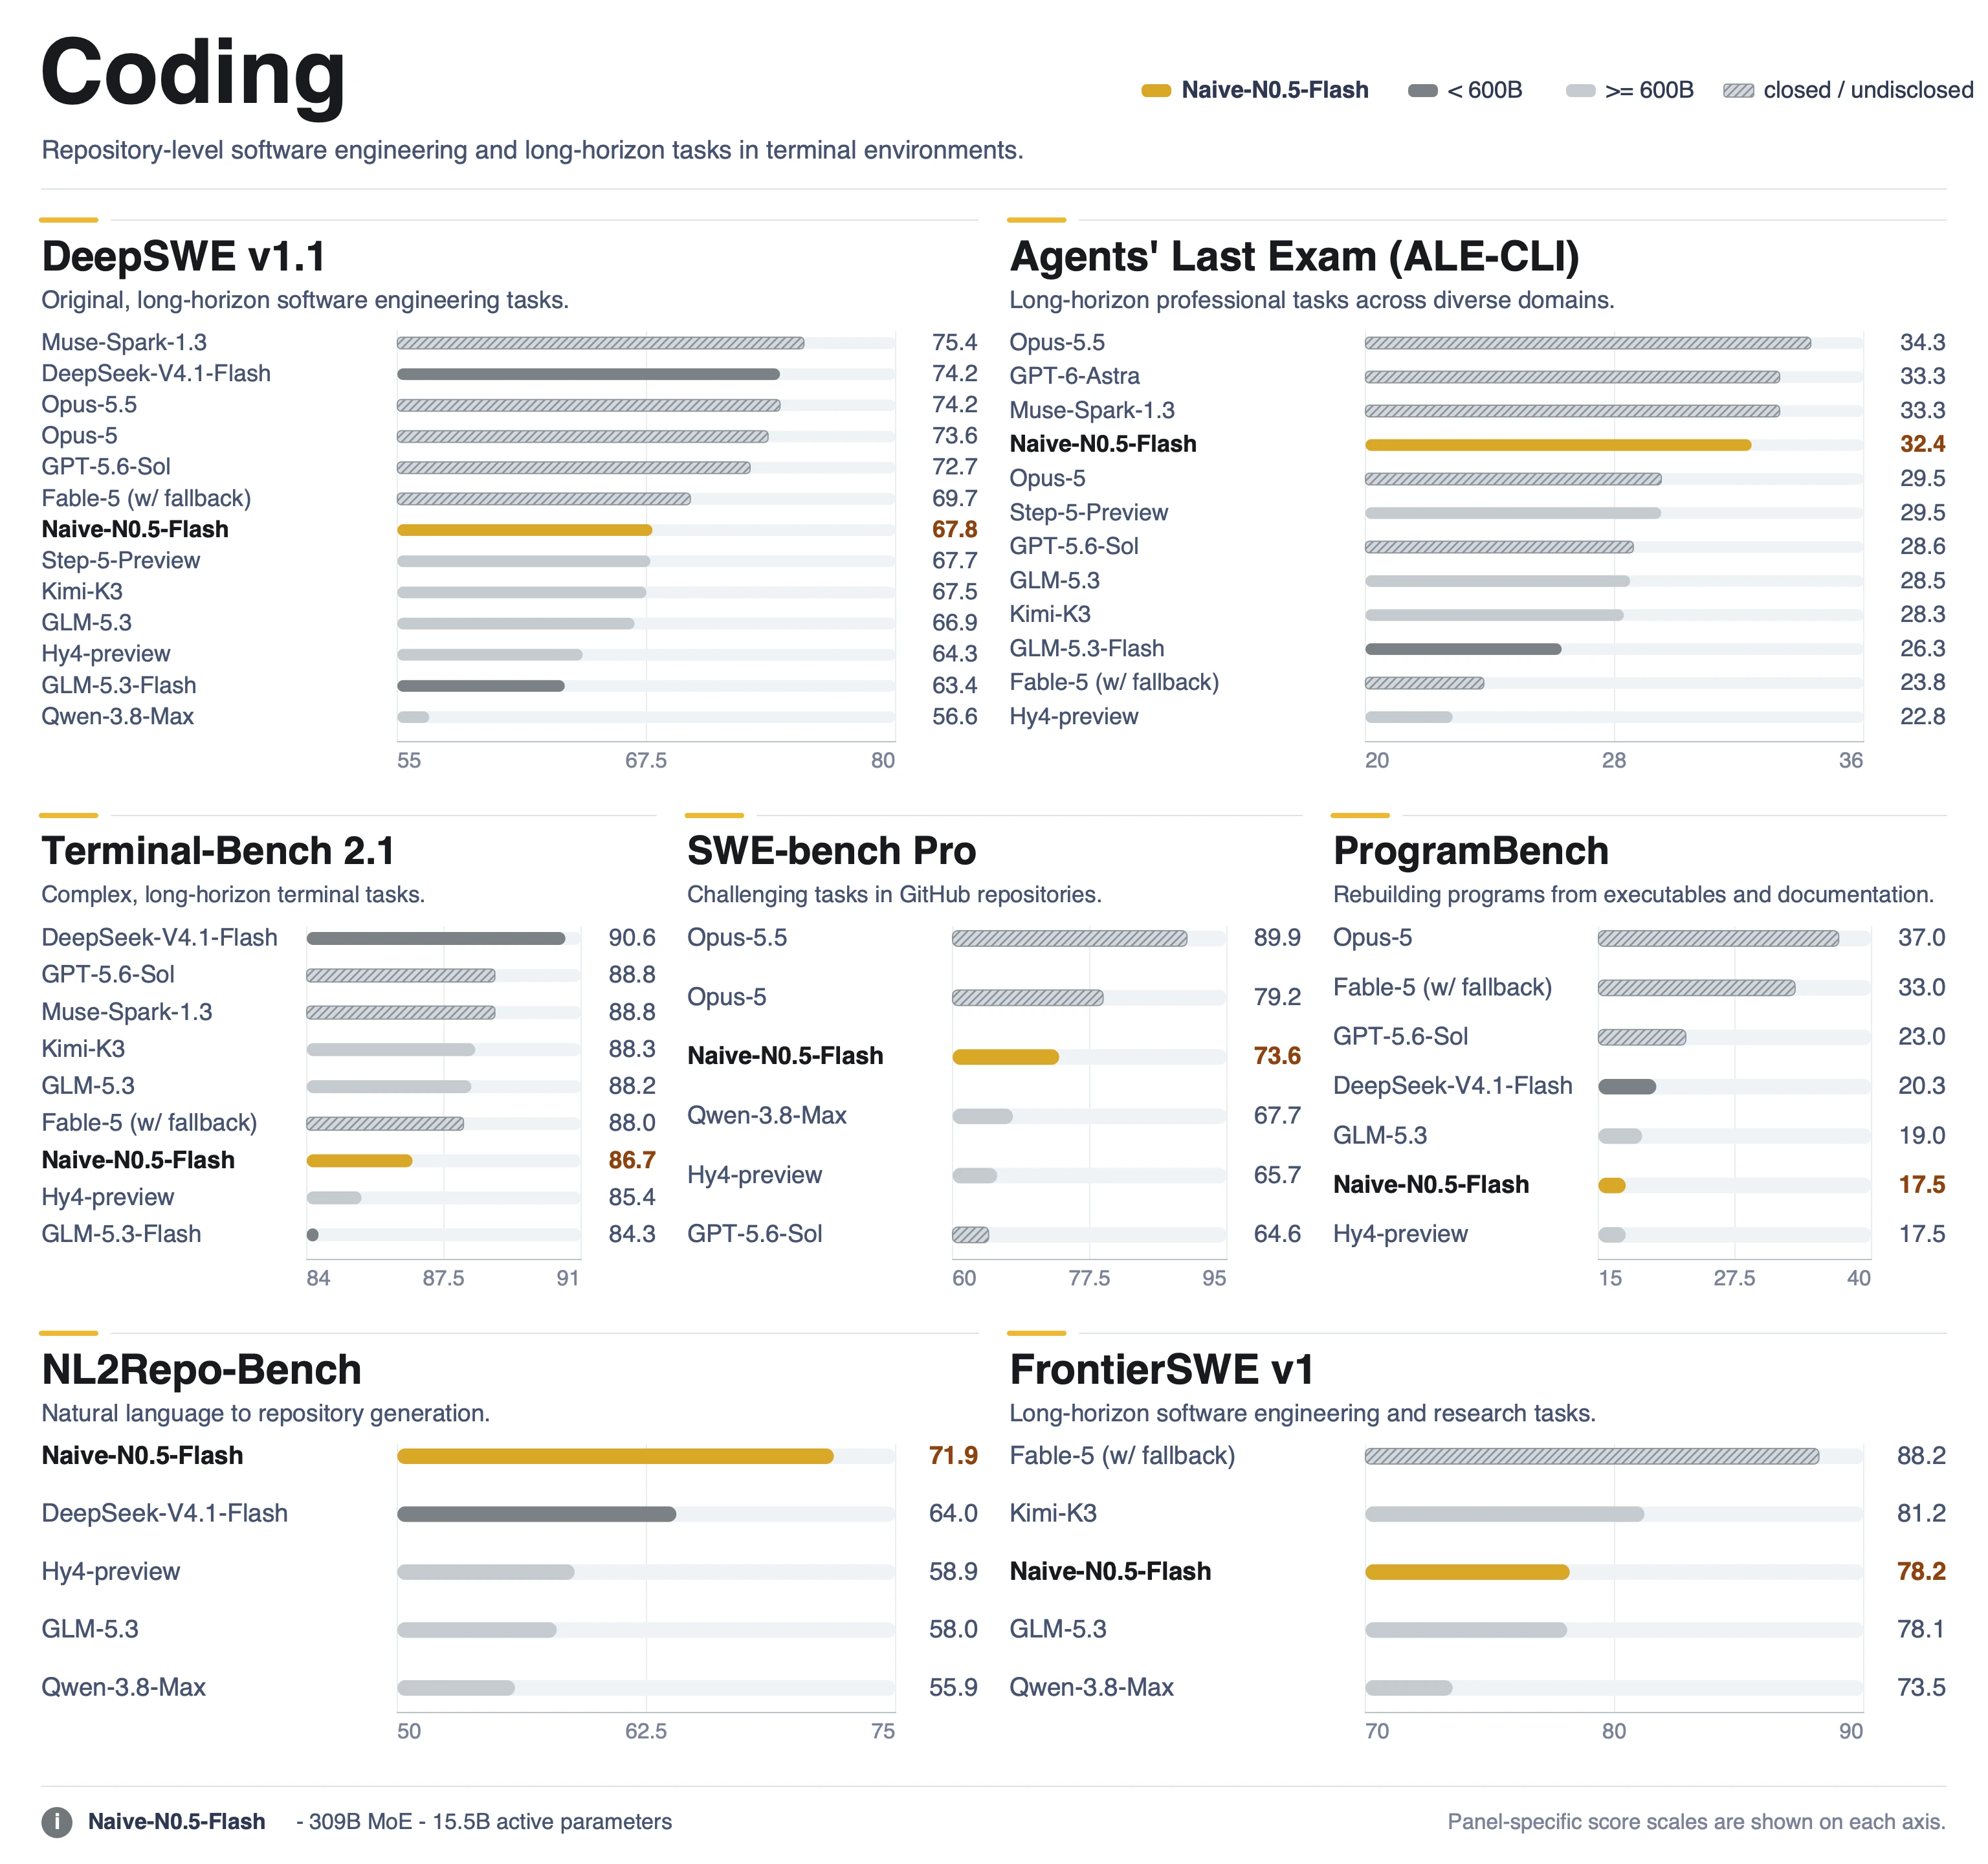
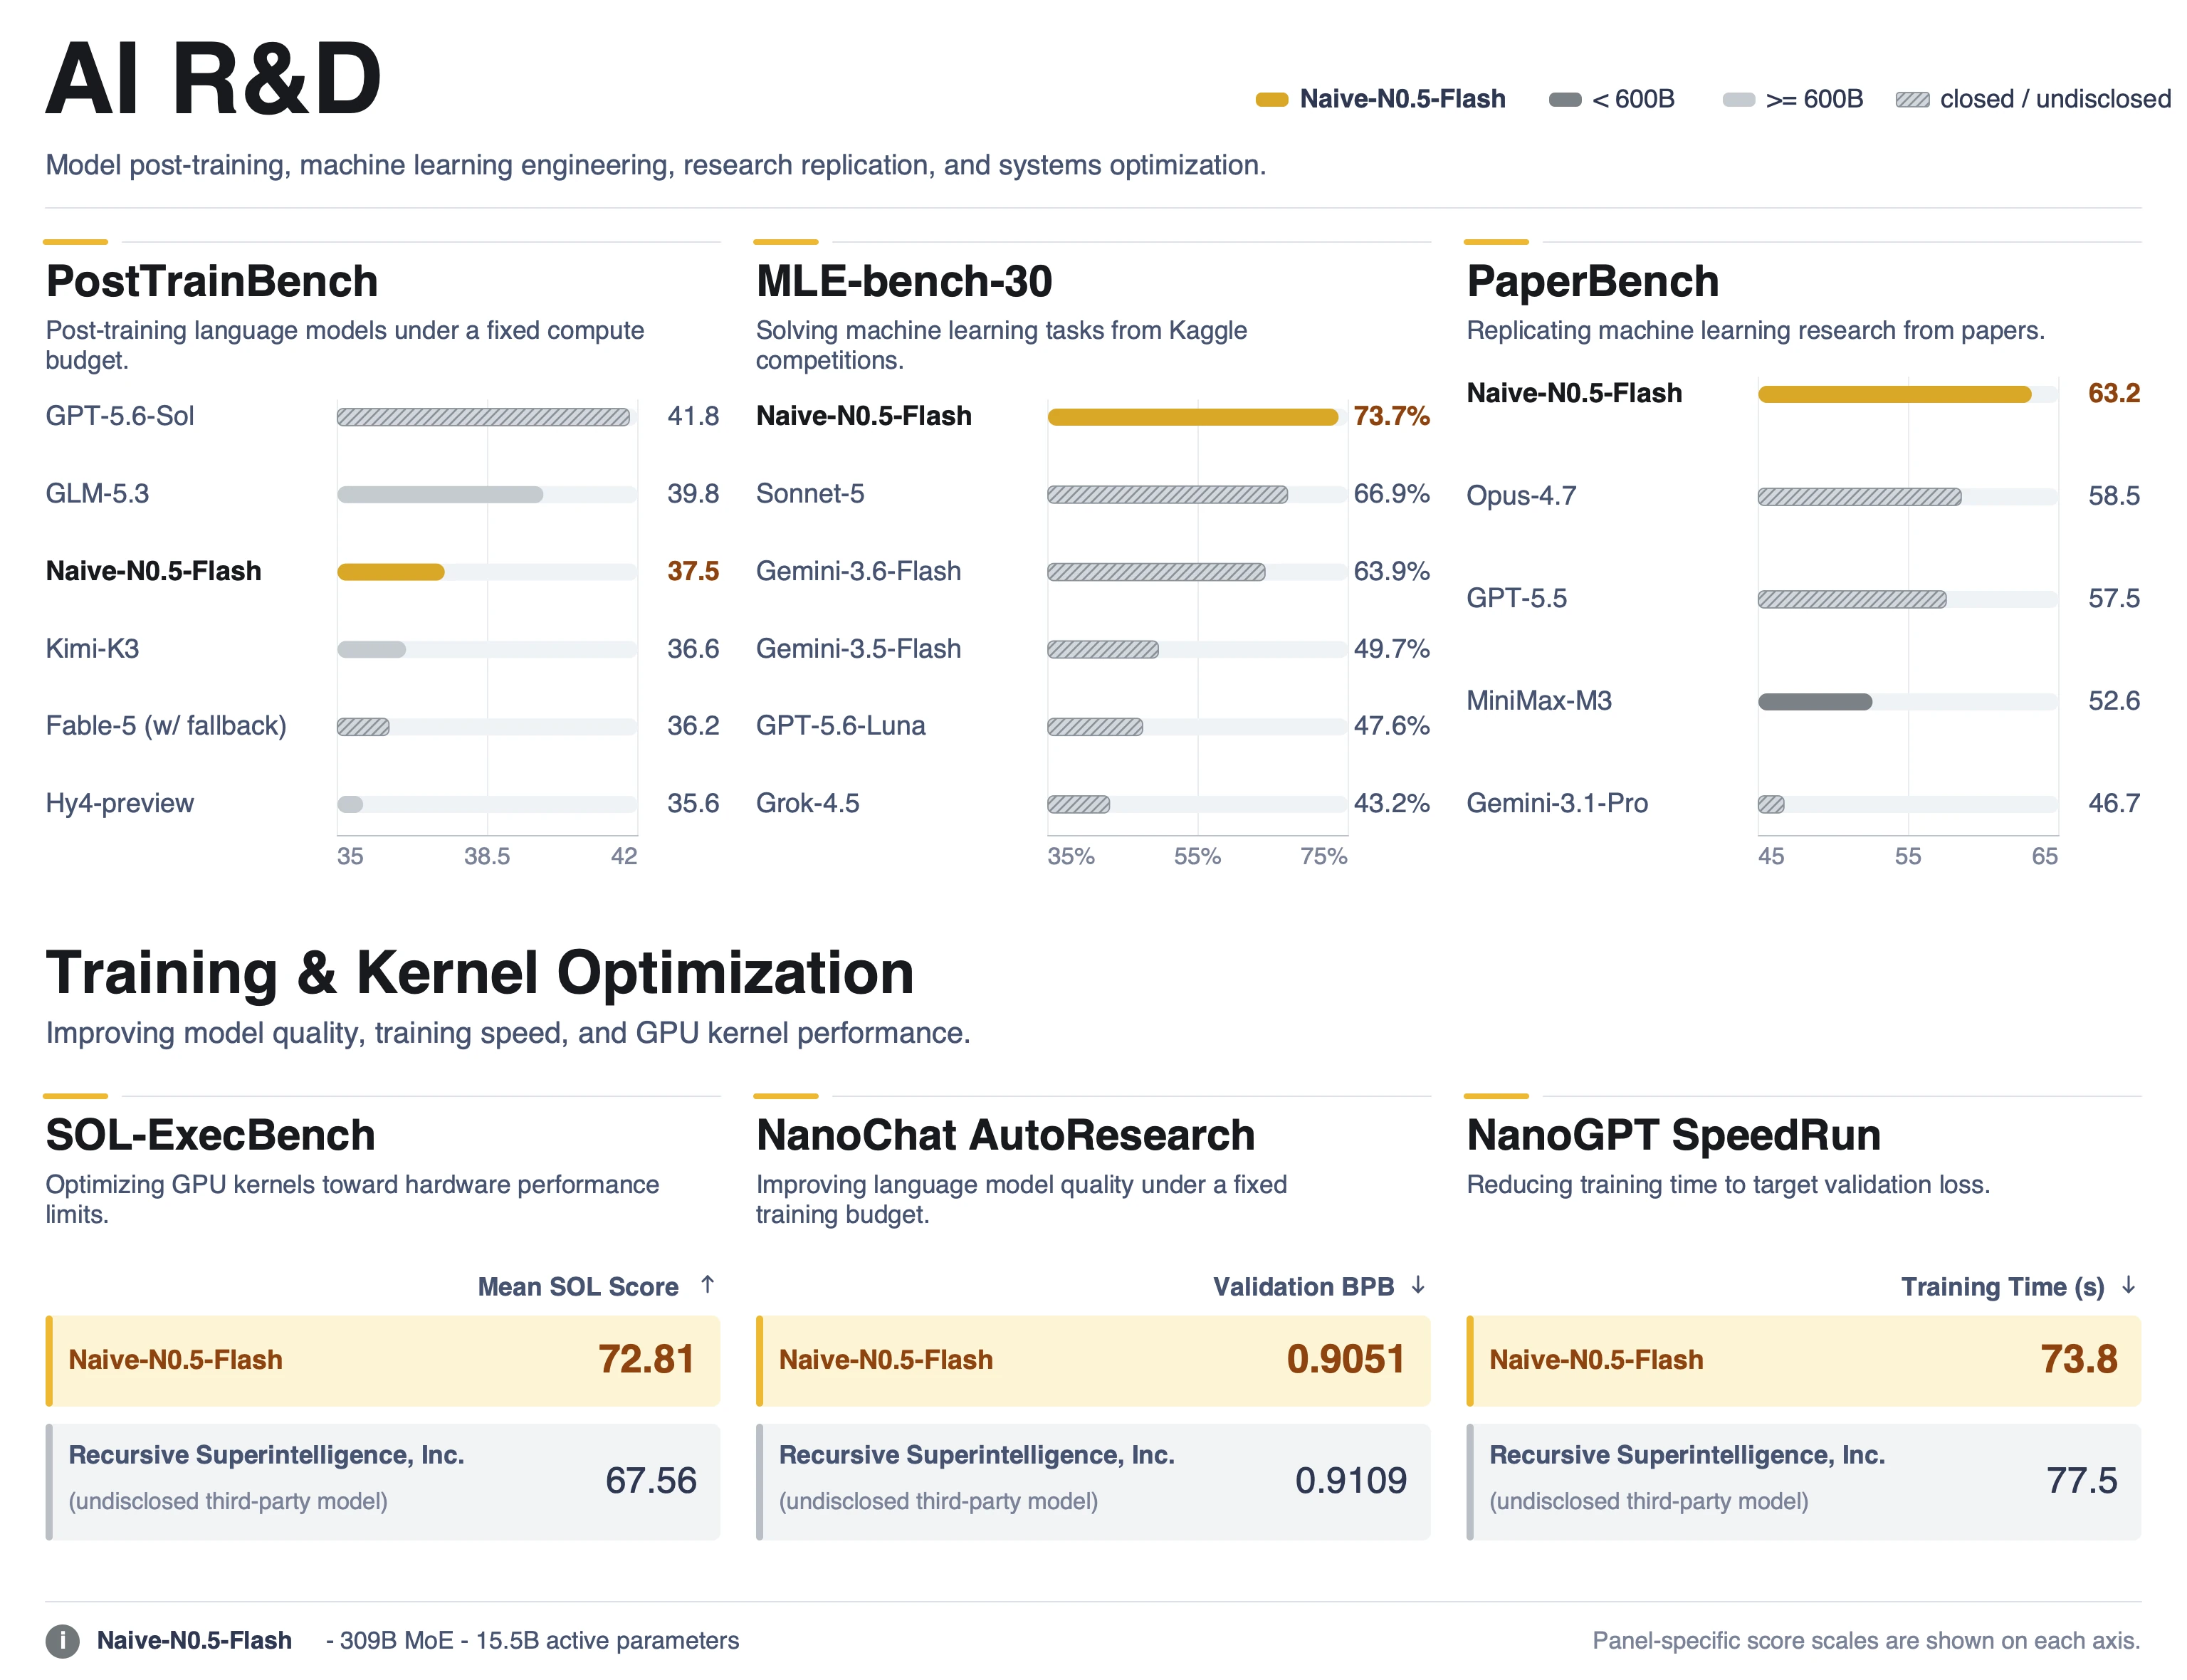
NaiveAI; yazılım mühendisliği, ajan görevleri ve MLE-bench-30 ile PaperBench gibi araştırma testlerine ilişkin grafikler yayımlıyor. Değerlendirme notlarına göre kendi modeli çoğunlukla dosya ve Bash araçlarıyla Claude Code 2.1.207 içinde çalıştırıldı. Rakip sonuçların bir bölümü ise başka şirketlerin yazılarından veya açık sıralama tablolarından alındı. Bunlar farklı sistem ve protokoller. Grafikler şirketin güçlü gördüğü alanları gösteriyor; aynı koşullarda yapılmış kontrollü bir sıralama veya okurun kendi deposunda elde edeceği sonucun kanıtı sayılmamalı.
Şirket, modellerin kod yazıp deney yürüttüğünü, sonuçları incelediğini; insanların ise hedefleri, sınırları ve kabul ölçütlerini belirlediğini anlatıyor. AutoWM örneğinde 400 saatlik toplam araştırma ve 15 büyük deney turu sonrasında WorldArena-1 Track 1 için 77,43 puan bildiriyor; daha önce yayımlanmış en yüksek değer olarak 73,64 veriyor. Bu, insan yönlendirmeli bir araştırma sürecine ilişkin şirket anlatısı ve karşılaştırması. Kendi kendine bağımsız biçimde daha iyi ardıllar üreten bir sistemin veya otonom özyinelemeli iyileşmenin kanıtı değil.
Hız sayısı tam olarak neyi ölçüyor?
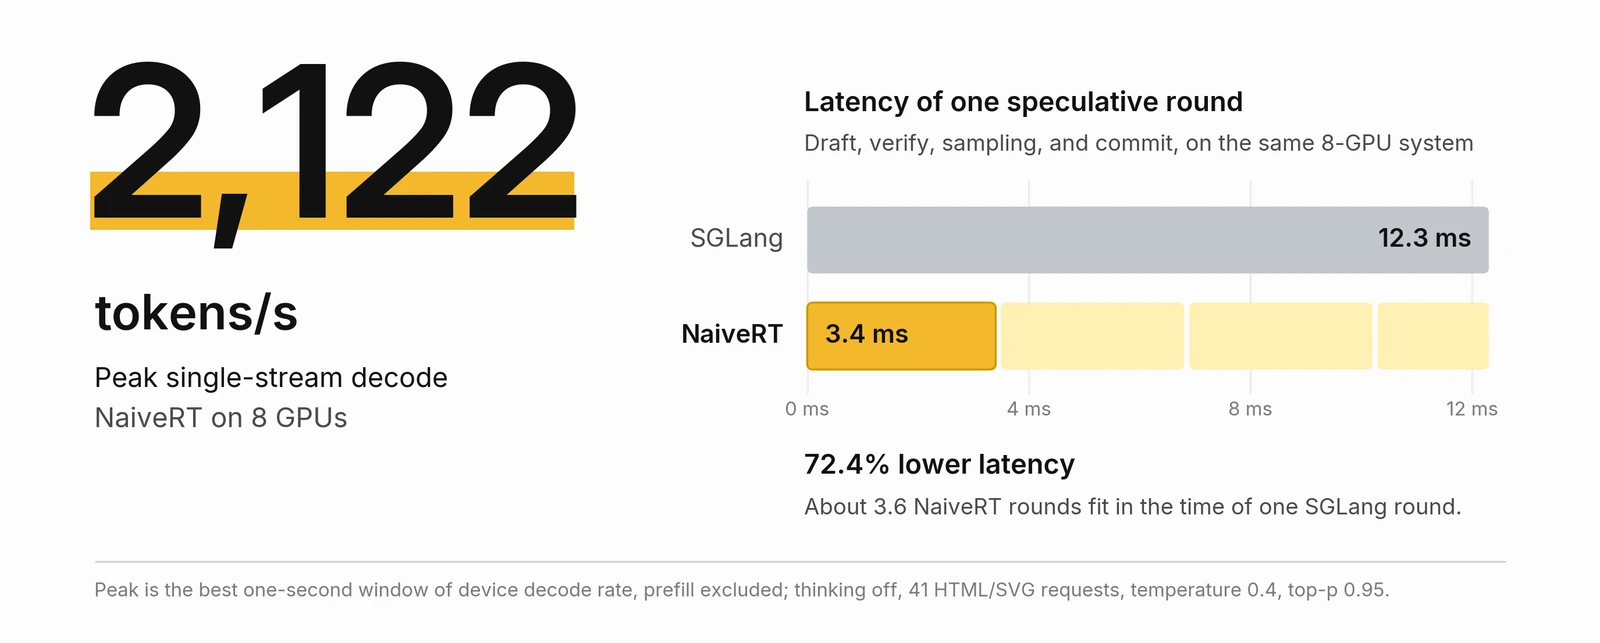
NaiveAI’ın NaiveRT çalışma zamanı birleşik GPU çekirdekleri, bağımlı başlatmalar ve spekülatif token üretimi (speculative decoding) kullanıyor. Öne çıkan saniyede 2.122 token, sekiz GPU üzerindeki 41 HTML/SVG üretim isteğinde, düşünme kapalıyken, sıcaklık 0,4 ve top-p 0,95 ayarlarıyla ölçülen en iyi bir saniyelik tek akış çıktı üretme hızı. İstemin ilk işlenmesi ölçüme dahil değil. Bu değer, sürekli uçtan uca hız veya genel API kullanıcısının bekleyeceği hız anlamına gelmiyor. Şirket aynı sistemde spekülatif turun NaiveRT ile 3,4 ms, SGLang ile 12,3 ms sürdüğünü de bildiriyor; bunlar söz konusu kurulumun şirket ölçümleri.
Erişim ve doğrulanacak noktalar
FP8 ağırlıklar MIT lisansıyla listeleniyor. Model kartındaki Transformers örneği FP8 destekli NVIDIA GPU’lar gerektiriyor. NaiveAI, API erişiminin sağlanacağını söylüyor; milyon token başına girdi için 0,10 dolar, çıktı için 0,40 dolar, önbellekten okuma için 0,01 dolar fiyat duyuruyor. Bu taslak için çalışan bir API ve geçerli sınırları doğrulanmadı. Araştırma sayfası NaiveRT’yi açık kaynak olarak tanıtırken anlattığı çalışma zamanı kodu, birleşik çekirdekler ve karşılaştırma betiklerinin 12 Ekim’e kadar erişilebilir olacağını da belirtiyor. Hız sonucunu bugün yeniden üretip üretemeyeceğini değerlendirenler için bu takvim önemli.
Geliştirici açısından en yararlı sınama, kendi uzun kod deposu veya araştırma görevidir: yanıt kalitesi, istemin işlenme süresi, sürdürülen çıktı hızı ve toplam donanım maliyeti birlikte ölçülmeli. Yayımlanan mimari modeli ilgi çekici kılıyor; kullanım ve performans iddiaları gerçek iş yüküyle sınanmayı bekliyor.
Kaynaklar bu taslak için 27 Eylül 2026’da incelendi. Teknik özellik ve performans rakamları NaiveAI’a aittir; bağımsız model, API veya çalışma zamanı testi yapılmadı.
Kaynaklar
- Naive-N0.5-Flash: Building Frontier AI with AI ↗NaiveAI
- Naive-N0.5-Flash-FP8 model kartı ↗Hugging Face / NaiveAI
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder