Kimi K3.1 Pro: 3T açık ağırlıklı model, ağırlıklar 4 Kasım'a dek
Moonshot'un Kimi K3.1 Pro'su uygulama ve API'de yayında, ağırlıklar 4 Kasım'a kadar vaat edildi. Kendi benchmark'ları, siber veri çıkarımı, neye bakılmalı.
Bu yazıda
Moonshot AI, Kimi K3.1 Pro’yu ürünlerine koydu ve yaklaşık on bir gün içinde açık ağırlık sözü verdi. Duyuru ayrıca siber yetenek konusunda alışılmadık derecede açık sözlü. Duyuru sayfasını, siber bölümü ve benchmark dipnotları dahil baştan sona okuduk. Bu yazıda neyin duyurulduğu, benchmark’ların nasıl okunacağı, Moonshot’un açık ağırlıklarda siber kötüye kullanımı sınırlamak için ne yaptığını söylediği ve nelerin doğrulanmadığı var. Sayfa tarih taşımıyor; varlıkları o güne kadar tarihli olduğu için 23 Ekim civarına yerleştiriyoruz ve hiçbir şeyi test etmedik.
Moonshot ne duyurdu?
K3.1 serisinde yeni bir model ve daha hızlı bir varyant. Moonshot’a göre Kimi K3.1 Pro “bugüne kadarki en yetenekli 3T sınıfı açık ağırlıklı modelimiz”, 1 milyon token bağlam penceresiyle, Kimi K3’ün önemli ölçüde daha büyük son-eğitim hesaplamasıyla elde edilmiş bir son-eğitim sürümü. Kimi K3.1 Pro Highspeed aynı ailenin 2 ila 3 kat hızlı hali. İkisi de bugün Kimi.ai ve mobil uygulamalarında, Kimi Work’te, Kimi Code’da ve Kimi API’de kimi-k3.1-pro ve kimi-k3.1-pro-highspeed kimlikleriyle mevcut. Moonshot tam ağırlıkların 4 Kasım’a kadar yayımlanacağını söylüyor. Lisans adı vermiyor, token başına fiyat vermiyor ve Kimi Enterprise yöneticilerinin modeli etkinleştirmesi gerektiğini, varsayılan olarak kapalı olduğunu söylüyor. API müşterileri için Zero Data Retention mevcut.
Benchmark’lar ne söylüyor?
Moonshot, K3’e göre kazanımlar ve en güçlü tescilli modellere yakın sonuçlar bildiriyor. Başlıca rakamlar:
- Terminal-Bench 4.0: %65,7; GPT-6 Astra’nın %58,2’sinin önünde, Claude Opus 5.5’in %66,4’ünün hemen gerisinde.
- Kimi Code Bench 3.0 Long-horizon, dahili bir benchmark: %61,2; K3’ün %55,95’inden yukarı.
- Araçlarla BenchCAD: %92,7; Claude Opus 5.5’in %96,2’sine ve GPT-6 Astra’nın %95,9’una karşı.
- OfficeQA Pro v2: 64,4; Moonshot bunu en gelişmiş sonuç olarak niteliyor. Ayrıca Frontier Finance’ta ve üç dahili finans benchmark’ında kazanım bildiriyor: Financial Modeling’de K3’e göre 7,2 puan, Financial Research’te 11,6 puan ve Business Operation’da K3’ün sonucunun yaklaşık 4,2 katı.
- Halüsinasyon: dahili bir stres testi olan Kimi Hallu Bench Hard’da iddia düzeyindeki halüsinasyon oranı K3’ün %23,4’ünden %8,3’e düştü. Moonshot bu oranların günlük kullanımdaki hata oranlarını temsil etmediğini söylüyor.
Bunları okumak için dipnotlar önemli. Moonshot K3.1 Pro’yu kendisi değerlendirdi; Terminal-Bench 4.0’da Claude-Code harness’ıyla, diğerlerinde Kimi’nin kendi harness’larıyla, en yüksek akıl yürütme çabasında. Rakiplerin skorları blog yazılarında, sistem kartlarında ya da liderlik tablolarında bildirilen en yüksek değer olarak alınıyor ve bazıları başka kaynaklardan geliyor; tescilli model testlerinin bir miktar geri dönüş (fallback) davranışı içerebileceği notuyla. OfficeQA Pro’da ve bir ajan benchmark’ında Moonshot ayrıca dış modellerin referans yanıtları çevrimiçi aradığını gördüğü görevleri sıfırladı. Yani karşılaştırmalar kontrollü bir kafa kafaya değil ve benchmark’ların birkaçı Moonshot’un kendisine ait.
Moonshot siber yetenek hakkında ne yaptı?
Siber ile ilgili verileri çıkardı ve çıkarmanın yeteneği düşürdüğünü söylüyor. Moonshot, K3.1 Pro geliştikçe güvenlik açığı araştırma performansının istikrarlı biçimde arttığını ve nedenini izlediğinde genel ara eğitim külliyatında siber ile ilgili içeriği ve pekiştirmeli öğrenme ortam karışımında siber ile ilgili görevleri bulduğunu yazıyor. Açık ağırlık sürümü için bu veriyi iki aşamadan da çıkardı, genel kodlama görevlerini koruyarak. Linux çekirdeği ve Node.js gibi yazılımlarda yakın zamanda ifşa edilen hatalardan çoğunlukla alınan, kaynak koduna dayalı güvenlik açığı keşfi ve istismarı için kendi içi benchmark’ı olan xdev-bench-hard’da, risk azaltma önlemleri olmayan kontrol noktasının pass@3’te problemlerin %90,5’ini çözdüğünü, nihai K3.1 Pro’nun ise %81,0’a ulaştığını bildiriyor.
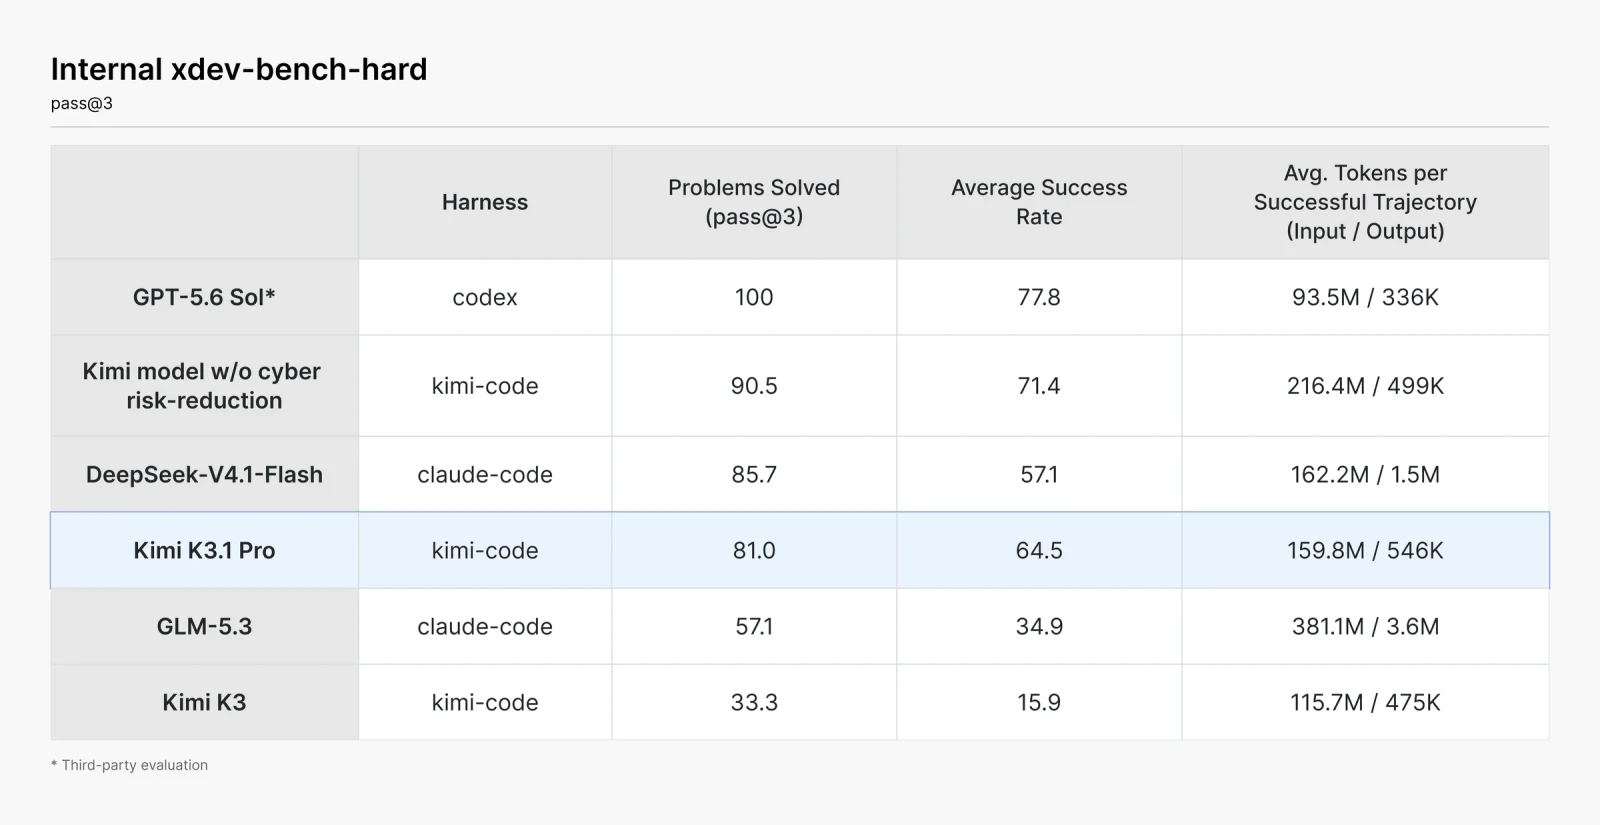
Moonshot, bunun veri çıkarımının siber yeteneği anlamlı ölçüde düşürdüğünü gösterdiğini, ama K3.1 Pro’nun selefine göre yine de büyük ölçüde iyileştiğini, yani genel kodlama ve hata ayıklama becerisinin taşındığını söylüyor. Modelin siber yeteneğinin en az üç aydır herkese açık tescilli sınır modellerin gerisinde kaldığını belirtiyor. Tabloda DeepSeek-V4.1-Flash bu testte K3.1 Pro’dan yüksek skor alıyor ve tablo GPT-5.6 Sol rakamını üçüncü taraf değerlendirmesi olarak işaretliyor.
Açık ağırlık ilkeleri neler?
Moonshot iki tane belirtiyor. Birincisi, siber yeteneğin mutlak sınırını ilerletecek açık ağırlıklar yayımlamamayı hedeflediğini ve K3.1 Pro’nun saldırgan yeteneğinin tasarım gereği boru hattının üretebileceğinin altında olduğunu söylüyor. İkincisi, açık ağırlıklarda bulunan siber yeteneği kademeli olarak artırmayı düşündüğünü; kullanıcıların kontrol ettiği altyapıda çalışan açık bir modelin çok daha fazla ekibin bakımını yaptığı kodu, özel güvenlik incelemesi nadiren yapılan eski sistemler dahil, denetlemesine imkân verdiğini ve kademeli yayılmanın sonuçta yazılımı daha güvenli kıldığını savunuyor. Bu Moonshot’un gerekçesi, yerleşmiş bir sonuç değil.
Henüz bilinmeyenler neler?
- Lisans ve tam yayın tarihi. Moonshot 4 Kasım’a kadar diyor ve lisans adı vermiyor.
- Ağırlıkların barındırılan modelle eşleşip eşleşmediği ve ağırlıklar herkese açık olunca siber veri çıkarımının bağımsız testlerde nasıl dayandığı.
- Fiyatlar. Sayfa bir fiyat sayfasına yönlendiriyor ve fiyat vermiyor.
- Bağımsız benchmark sonuçları. Moonshot’un karşılaştırmaları kendi koşularını başkalarının yayımladığı en iyi rakamlarla karıştırıyor ve bazı benchmark’lar dahili.
- Duyurunun tarihi. Sayfa tarihsiz.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Ağırlıkları bekleyin. Açık ağırlık iddiası ilginç olan kısım ve yalnızca yayından sonra sınanabilecek.
- Siber bölümü kanıt değil, bir duruş olarak okuyun. Veriyi kesmek Moonshot’un kendi benchmark skorunu düşürdü, bu yararlı bir bulgu, ama benchmark dahili ve karşılaştırma kümesi Moonshot’un seçimi.
- Bu belirtilmiş bir çizgi; başkaları izleyebilir ya da izlemeyebilir. Bir laboratuvarın siber yeteneğin açık sınırını ilerletmeyeceğini söylemesi bir politika beyanı. Önceki haberlerimizin Anthropic’in GLM-5.3 siber raporunu ve DeepSeek V4.1-Flash sürümünü nasıl ele aldığına bakın.
- Kendi görevlerinizde karşılaştırın. Bir terminal benchmark’ında Claude Opus 5.5 ile yakın sonuç genel bir hüküm değil.
Editoryal inceleme: 24 Ekim 2026 (AI). Moonshot AI’nin Kimi K3.1 Pro duyuru sayfası (siber bölümü ve benchmark dipnotları dahil sayfa metni olarak baştan sona okundu) ve xdev-bench-hard için yayımladığı benchmark tablosu (görsel olarak incelendi) üzerinden hazırlandı. Sayfanın tarihi yok; bu yüzden varlık yollarından 23 Ekim civarını çıkarıyoruz. Modeli çalıştırmadık, hiçbir benchmark’ı kontrol etmedik, model ağırlıklarını okumadık ve Moonshot ile iletişime geçmedik. Tüm sayılar Moonshot’un kendi sayılarıdır. Sayfa okumamızdan sonra değişmiş olabilir.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder