Jev sonrası karar modelleri: kim ne yayımladı, iddialar nasıl okunur
Jev'in ardından Cloudflare, Perplexity, Strands ve OpenAI geldi. Alanın karşılaştırması, iddialar ve rakamların nasıl okunacağı.
Bu yazıda
Karar modelleri üç haftadan kısa sürede tek üründen kalabalık bir alana dönüştü. TypeSafe, Jev’i 15 Eylül’de tanıttı. O günden beri Strands, Cloudflare ve Perplexity birer açık model yayımladı, OpenAI da bir Decisions API duyurdu. Bu yazı 2 Ekim itibarıyla alanın rehberi: kim ne yayımladı, her biri kendisi hakkında ne söylüyor ve birbirini tutmayan rakamlar nasıl okunur. Model kartlarını ve duyuruları okuduk; modellerin hiçbirini çalıştırmadık.
Karar modeli, bir durum ve izin verilen cevaplar listesi alıp metin yazmak yerine her cevap için olasılık döndüren modeldir. Fikri Jev ve Laya-MLX yazımızda anlatmıştık.
Alan tek tabloda
Aşağıdaki rakamların hepsi yapımcıların kendi bildirimidir, bağımsız sonuç değildir.
| Model | Yapımcı | Taban ve boyut | Erişim | Bildirdiği |
|---|---|---|---|---|
| Jev | TypeSafe | açıklanmamış | kapalı, hosted API | Diğerleri için referans noktası |
| Strands Decider 2B | Strands ekibi | Qwen3.5-2B-Base | Apache-2.0 | JevBench public sette %72,3; ortanca yaklaşık 115 ms |
| Clef ve Clef-Flash | Cloudflare | Qwen3.8-27B, Qwen3.5-9B | Apache-2.0, Workers AI | Decision Index’te 61,2 (self-reported); Flash için 38,8 ms |
| pplx-decider-v1-27b | Perplexity | Qwen3.8-27B | Apache-2.0 | 11 benchmark’ta %85,71; Jev %84,51 |
| JEV-27B | autotrust | Qwen3.8-27B | Apache-2.0 | Altı benchmark ortalamasında 84,07; Jev 1.13 için 83,85 |
| OpenAI Decisions API | OpenAI | Luna etrafında kurulu | sınırlı önizleme | Duyuruda rakam yok |
Aynı kümedeki önceki girişler: OpenDecider, CLM-8B, akıl yürütme ekleyen Jeeves ve 0,8B boyutundaki Jeff. Hugging Face’te “decider” ve “jev” aramasını en yeniye göre sıraladığınızda 29 Eylül’den beri açılmış onlarca depo da çıkıyor: GGUF, EXL3, ONNX ve NPU dönüşümleri ile alana özel türevler; çoğunun henüz beğenisi yok. Birçoğu mevcut modellerin dönüşümü gibi görünüyor.
Henüz ele almadığımız üç duyuru
Perplexity’nin pplx-decider-v1-27b modeli
Perplexity modeli 1 Ekim’in geç saatlerinde (UTC) yayımladı. Apache-2.0 lisanslı, Qwen3.8-27B’den fine-tune edilmiş; metin üretim katmanı 255 seçeneğe kadar bir karar readout’u ile değiştirilmiş. Kart yaklaşık 49 GiB ağırlık belirtiyor, yani büyük bir GPU gerekiyor; görsel girdi de kabul ediyor.
Tablosu modeli Jev ve değiştirilmemiş Qwen3.8-27B ile 11 benchmark’ta karşılaştırıyor. Genel rakam Perplexity’den yana: %85,71, Jev %84,51, taban model %74,76. Satırlar daha karışık bir hikâye anlatıyor. Kartın kendi kalın işaretlemesine göre Jev altı satırı kazanıyor (WinoGrande, JudgeBench, BBH, JevBench public hard, Belebele, TruthfulQA), Perplexity dördünü (FinancialPhraseBank, RAGTruth, TabFact, Circa), ContractNLI ise taban modelle berabere. Perplexity lehine en büyük fark RAGTruth’ta (%88,80’e karşı %77,27), aleyhine en büyük fark BBH’de (%82,80’e karşı %94,27). Karttan iki not: sonuçlar indirilebilir ağırlıklardan değil, Perplexity API’si üzerinden ölçülmüş ve kart Jev sütununun nasıl elde edildiğini söylemiyor.
Bir ayrıntı daha: release manifest’i checkpoint’i “AutoJev 27B curated SFT checkpoint” olarak tanımlıyor ve autojev eğitim ve serving kodunu içeriyor. autotrust’ın kartı, başka bir yazarın ilgisiz bir AutoJev-27B’sinden söz ediyor. Bunların birbirine nasıl bağlandığını doğrulayamadık, Perplexity’nin yayını da bunu açıklamıyor.
autotrust’ın JEV-27B’si
autotrust farklı bir yol tuttu: Jev 1.13’ün distillation’ı. System 1 head’i Jev’in olasılıklarını taklit ediyor (Jev’in etiketlediği held-out sorularda ortalama KL 0,017) ve aynı ağırlıklar sıradan metin üretimi için dokunulmamış bir Qwen3.8-27B’yi koruyor. Altı public benchmark’taki kendi çalıştırmalarında JEV-27B’nin ortalaması 84,07, hosted Jev 1.13’ünki 83,85; fark 0,22 puan. JEV-27B altıdan dördünü, Jev ikisini kazanıyor; diğer açık modellerin skorları autotrust’ın değil, başka bir grubun değerlendirmesinden geliyor.
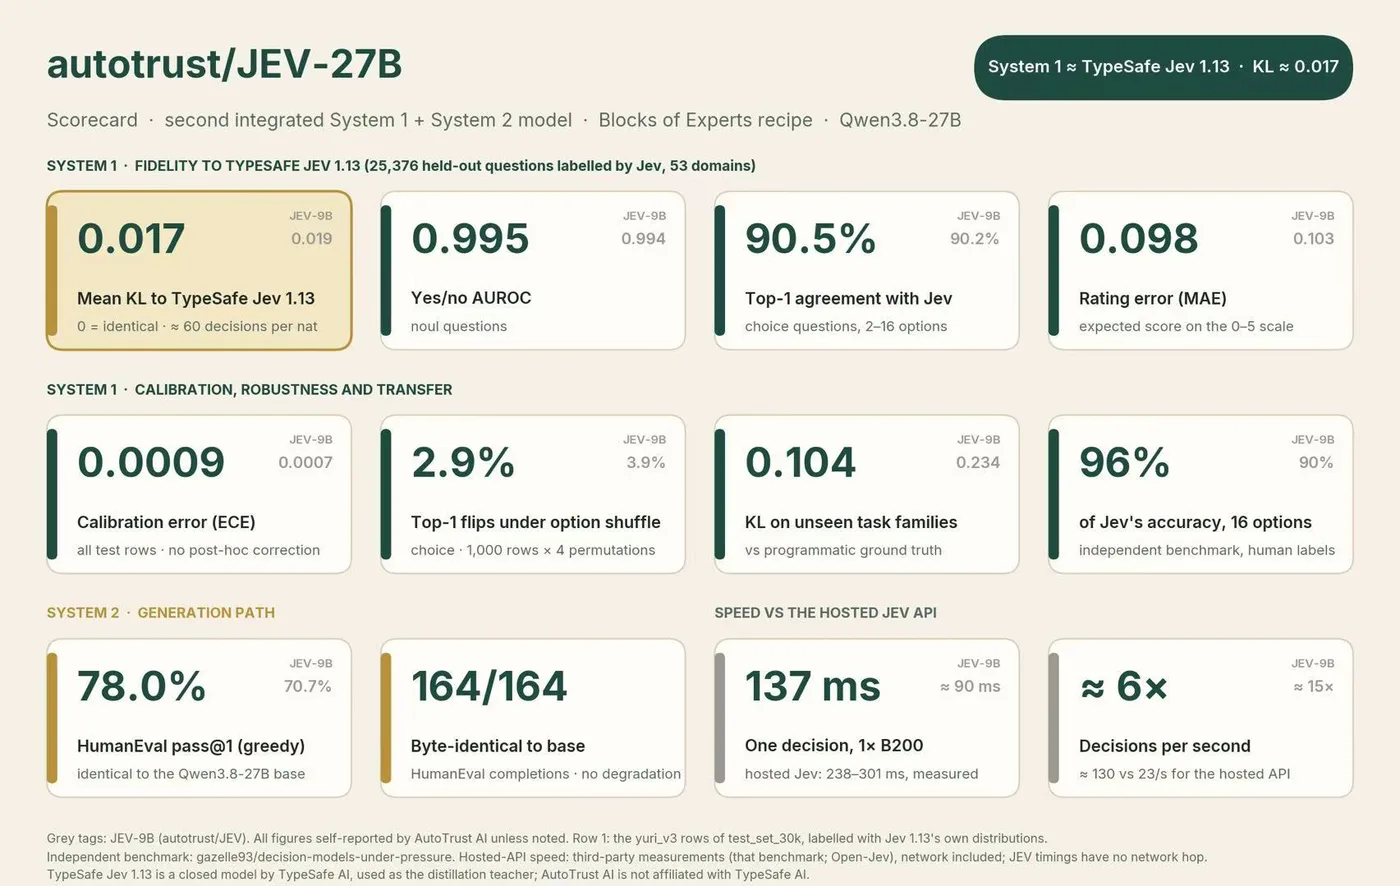
Kart sınırlar konusunda alışılmadık derecede açık. Modelin Jev 1.13’ü “hatalarına varana kadar” taklit ettiğini, İngilizce ağırlıklı olduğunu, hosted API ile hız karşılaştırmasının eşit koşullarda olmadığını (kendi tarafında ağ gecikmesi yok) ve yüksek riskli kararlar için olmadığını söylüyor. Etiketler kapalı bir modelin çıktılarından geldiği için, bunun üzerine ürün kuracak herkes TypeSafe’in şartlarının bu kullanımı nasıl ele aldığını da okumalı; biz bunu kontrol etmedik.
OpenAI’ın Decisions API’si
OpenAI’ın DevDay özeti bunu, Luna’nın zekâsını kullanıcının tanımladığı, cevapları sonlu ve önceden belirlenmiş sorulara odaklamak olarak anlatıyor; bağlam metin veya görsel olabiliyor, kullanım alanları içerik sınıflandırma, istek yönlendirme veya bir ajanın sonraki adımını seçmek. Sınırlı önizlemede ve geniş sürümün “önümüzdeki günlerde” planlandığı söyleniyor. Özet fiyat, latency veya istek biçimi vermiyor. TechCrunch geliştiricilerin henüz denediğini görmediğini yazıyor; yani doğruluğu veya kalibrasyonu hakkında bir şey söylemek mümkün değil.
Rakamlar nasıl okunur
- Üç Jev skoru, üç benchmark. Perplexity’nin tablosu Jev’i 84,51’e, autotrust’ın çalıştırması 83,85’e, Cloudflare’in Decision Index grafiği 57,9’a koyuyor. Bunlar farklı setler ve farklı örneklemler. Bir listede birinci olan model başka bir liste hakkında bir şey söylemiyor.
- Kimin çalıştırdığı önemli. Cloudflare’in kendi grafiği “self-reported” ile “board-validated” sonuçları ayırıyor. Perplexity kendi API’si üzerinden ölçmüş; autotrust’ın dipnotu rakamlarının self-reported olduğunu söylüyor. 27B iddialarının hiçbirinin bağımsız bir çalıştırması henüz yok.
- Ortak taban. Clef, pplx-decider, JEV-27B ve AutoJev checkpoint’i Qwen3.8-27B’den başlıyor. Aralarındaki farklar boyuttan değil, eğitim verisi ve tarifinden geliyor; küçük farklara (0,22 puan, 1,2 puan) temkinli yaklaşmak bu yüzden gerekli.
- Ortalama satırları gizler. Perplexity’nin genel üstünlüğü, Jev’in altı galibiyetine karşı dört galibiyet ve bir beraberlikten geliyor. Ortalamaya değil, kendi işinize en yakın göreve bakın.
- Ölçülmeyenler. Kendi trafiğinizdeki kalibrasyon, Türkçe ve diğer diller (autotrust’ın corpus’u İngilizce, OpenDecider yalnızca İngilizce test edildi) ve donanımınızdaki latency bu tabloların hiçbirinde yok.
Hangisini seçmeli
- GPU yok ya da en basit yol isteniyor: hosted bir API (şimdilik Jev, genel sürüm çıkınca OpenAI’ınki).
- Küçük ve yerel: Strands Decider 2B veya Jeff; mütevazı donanımda çalışıyorlar. Uzun, akıl yürütme ağırlıklı girdilerde daha zayıf sonuç bekleyin; Strands’in kendi kartı da bunu söylüyor.
- En büyük açık modeller: Clef, pplx-decider ve JEV-27B büyük bir GPU istiyor. İşinize en yakın iki üçünü, kendi etiketli örneklem verinizde deneyin.
- Akıl yürütme gerektiğinde: Jeeves, latency pahasına düşünüyor.
Hangisini seçerseniz seçin, güven eşiğini kendi etiketli örneklerinizde belirleyin ve emin olunmayan durumları daha güçlü bir modele ya da bir kişiye yönlendirin. Strands ve autotrust kartlarının ikisi de bunu söylüyor.
Takip edilecekler
- Bağımsız değerlendirmeler: Perplexity ve autotrust için Decision Index ve JevBench gönderimleri.
- OpenAI’ın genel sürümü: fiyat, latency ve gerçek bir istek biçimiyle.
- TypeSafe’in yanıtı. TechCrunch, CEO’sunun bu modelleri gerçekten akıllı yapmanın insanların sandığından zor olduğunu söylediğini aktarıyor.
- Veri kaymasında kalibrasyon. Ürün olan şey olasılıklar; ilginç sonuçlar, bunların yeni veride tutup tutmadığını sınayanlar olacak.
Devamı için
- llama.cpp artık karar modellerini /v1/systemone ile sunuyor
- Red Hat: Jev guardrail referanslarına göre rekabetçi, ama net üstün değil
Editoryal inceleme: 2 Ekim 2026 (AI). pplx-decider-v1-27b ve JEV-27B için Hugging Face model kartları ve sürüm dosyaları, OpenAI’ın DevDay özeti, önceki yazılarımızda ele aldığımız Cloudflare ve Strands yazıları ile TechCrunch haberleri aynı gün okunarak hazırlandı. Tüm benchmark rakamları yapımcıların kendi bildirimidir ve bağımsız olarak doğrulanmadı; modellerin hiçbirini çalıştırmadık. Scorecard görseli autotrust’a aittir, kaynak bağlantısı ve atıfla kullanıldı.
Kaynaklar
- Introducing System One Models & Jev ↗TypeSafe AI
- perplexity-ai/pplx-decider-v1-27b (model card) ↗Hugging Face
- autotrust/JEV-27B (model card) ↗Hugging Face
- Introducing Clef: our open-source decision models, and new RL fine-tuning platform ↗Cloudflare
- Introducing Strands Decider 2B: a small, open source, decision model ↗Strands Agents blog
- DevDay 2026 Recap ↗OpenAI
- Amazon releases its own Jev clone as decision models flood the web ↗TechCrunch
- OpenAI's Jev clone could help the frontier lab stop its swarming agents ↗TechCrunch
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder