CLM-8B: Ajanların karar vermesi için açık ağırlıklı bir Jev alternatifi
CLM-8B nasıl karar veriyor? Jev karşılaştırmasını, orijinal benchmark grafiklerini, yerel çalıştırma gereksinimlerini ve güven skorlarının sınırlarını inceliyoruz.
Bu yazıda
Bir yapay zekâ ajanı, gelen mesajı faturalandırma ekibine mi yoksa teknik desteğe mi yönlendireceğine karar verecek. O anda ihtiyacı uzun bir açıklama değil, doğru kuyruğu seçmek. CLM-8B, bu tür kararlar için mevcut durumla aday seçenekleri karşılaştıran, açık ağırlıklı bir model sunuyor.
24 Eylül’de Hacker News’te tartışmaya açılan proje, Jev ve Laya üzerine incelememizin devamı niteliğinde. Buradaki tarih HN paylaşımına ait; modelin bütün dosyalarının ilk kez bugün yayımlandığı anlamına gelmiyor. Asıl soru, karar vermeye odaklanan bu yaklaşımın bir ajan uygulamasında nerede işe yarayabileceği.
CLM-8B ne yapıyor?
CLM, Contrastive Language Model adının kısaltması. Model, bir durumu ve ona uygulanabilecek seçenekleri ayrı sayısal temsillere dönüştürüyor. Bu temsillerin uyumuna bakarak seçenekleri sıralıyor. Eğitimde doğru durum–eylem eşleşmelerini birbirine yaklaştırıp yanlış eşleşmeleri uzaklaştıran karşılaştırmalı bir amaç kullanılıyor.
Yayımlanan uygulama, Qwen3-8B üzerine iki küçük projeksiyon başlığı kuruyor: biri durumu, diğeri aday eylemi temsil ediyor. Temel dil modelinin ağırlıkları sabit tutuluyor; bu başlıklar eğitiliyor. Yeni bir metin kodlanırken temel model hâlâ devrede. Aynı seçenek tekrar kullanıldığında ise temsili önbellekten alınabiliyor.
Bu nedenle sistem yalnızca küçük bir sınıflandırıcı dosyasından ibaret değil. İndirilen yaklaşık 75 MB büyüklüğündeki başlık dosyasına ek olarak Qwen3-8B kodlayıcısını da çalıştırmak gerekiyor. Küçük dosya boyutunu toplam model belleği veya donanım ihtiyacı olarak okumamak önemli.
Jev’e benzeyen arayüz, farklı çalışma biçimi
Resmî depo, TypeSafe uyumlu bir API üzerinden üç soru türü sunuyor:
| Soru türü | Dönen sonuç | Örnek kullanım |
|---|---|---|
| Choice | Seçenekler arasındaki dağılım ve seçilen cevap | Mesajı editoryal, abonelik veya teknik destek kuyruğuna ayırmak |
| Noul | Doğru/yanlış seçeneklerinden türetilen bir değer | Bir mesajın acil olup olmadığını değerlendirmek |
| Score | Tanımlanmış, sıralı bir ölçekte beklenen düzey | Bir talebin önceliğini düşük, orta veya yüksek olarak puanlamak |
Bu uyumluluk, benzer istek yapılarıyla deney yapmayı kolaylaştırıyor. Aynı arayüzün kullanılması, modellerin aynı doğruluk, bağlam kapasitesi veya güven kalibrasyonuna sahip olduğunu göstermiyor.
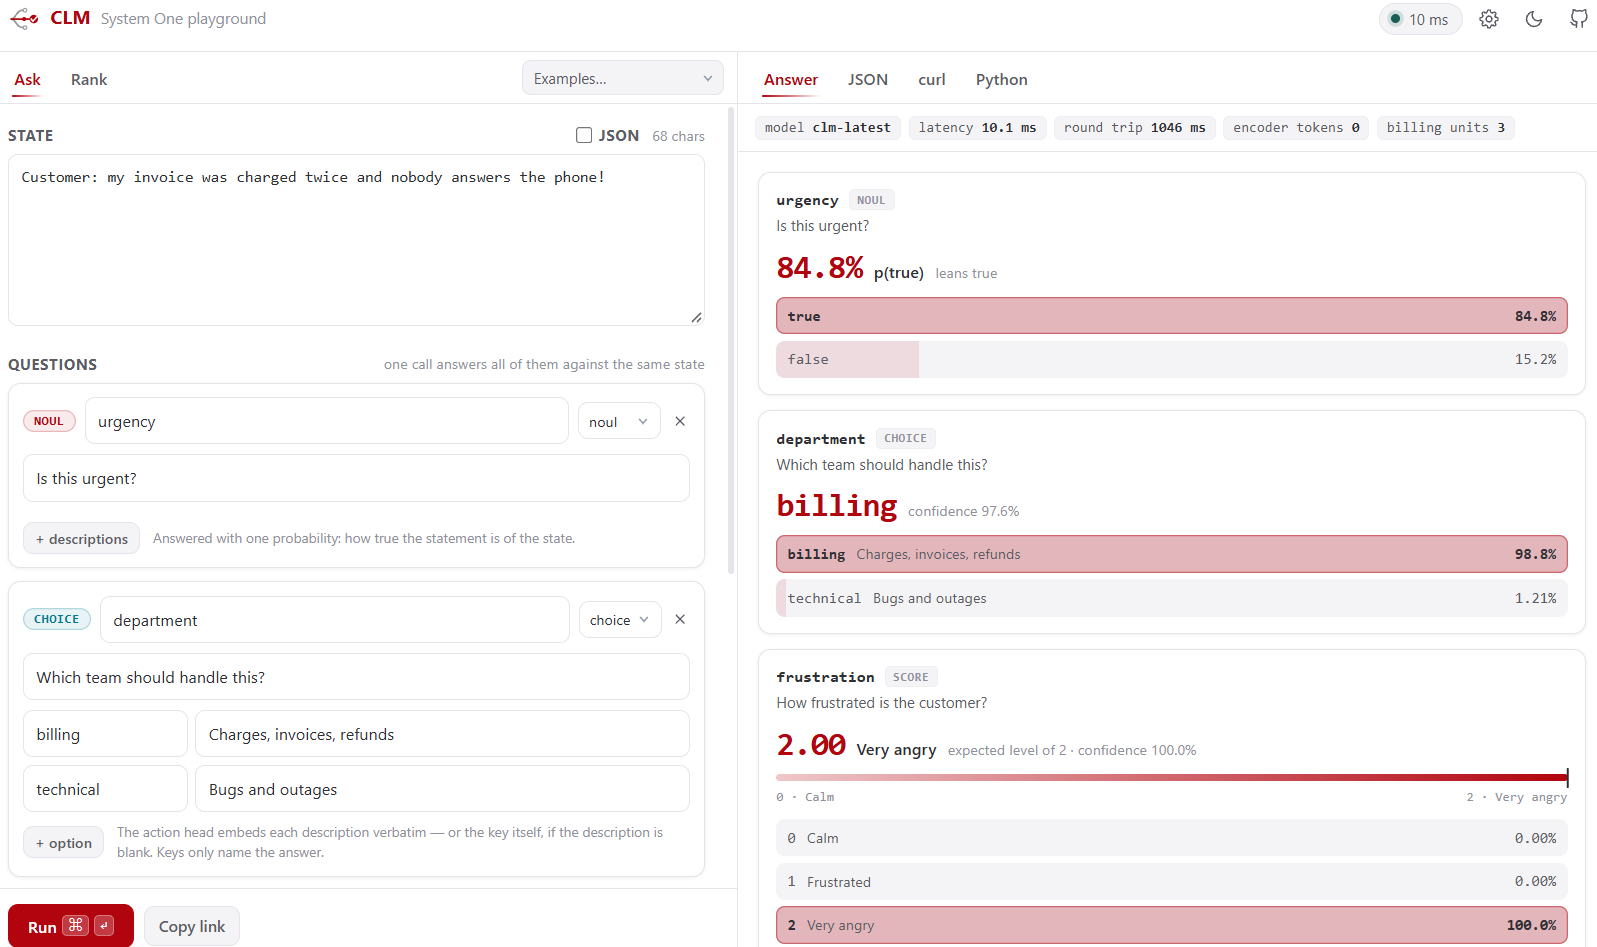
Kapaktaki resmî arayüz görüntüsü de tek bir müşteri mesajından bu üç değerlendirmeyi çıkarıyor. Oradaki yüzdeler, projenin örnek çıktıları; bizim bağımsız ölçümlerimiz değil.
“9 kata kadar hızlı” iddiasının arkasında ne var?
Projenin özgün grafiğinde en büyük fark T-Rex oyununda: CLM-8B için 16,5 ms, Jev için 149,8 ms gösteriliyor. Araç çağırma testindeki fark ise 76,8 ms ile 125,5 ms. Dolayısıyla bütün işlemler için tek bir hız katsayısı kullanmak doğru olmaz.
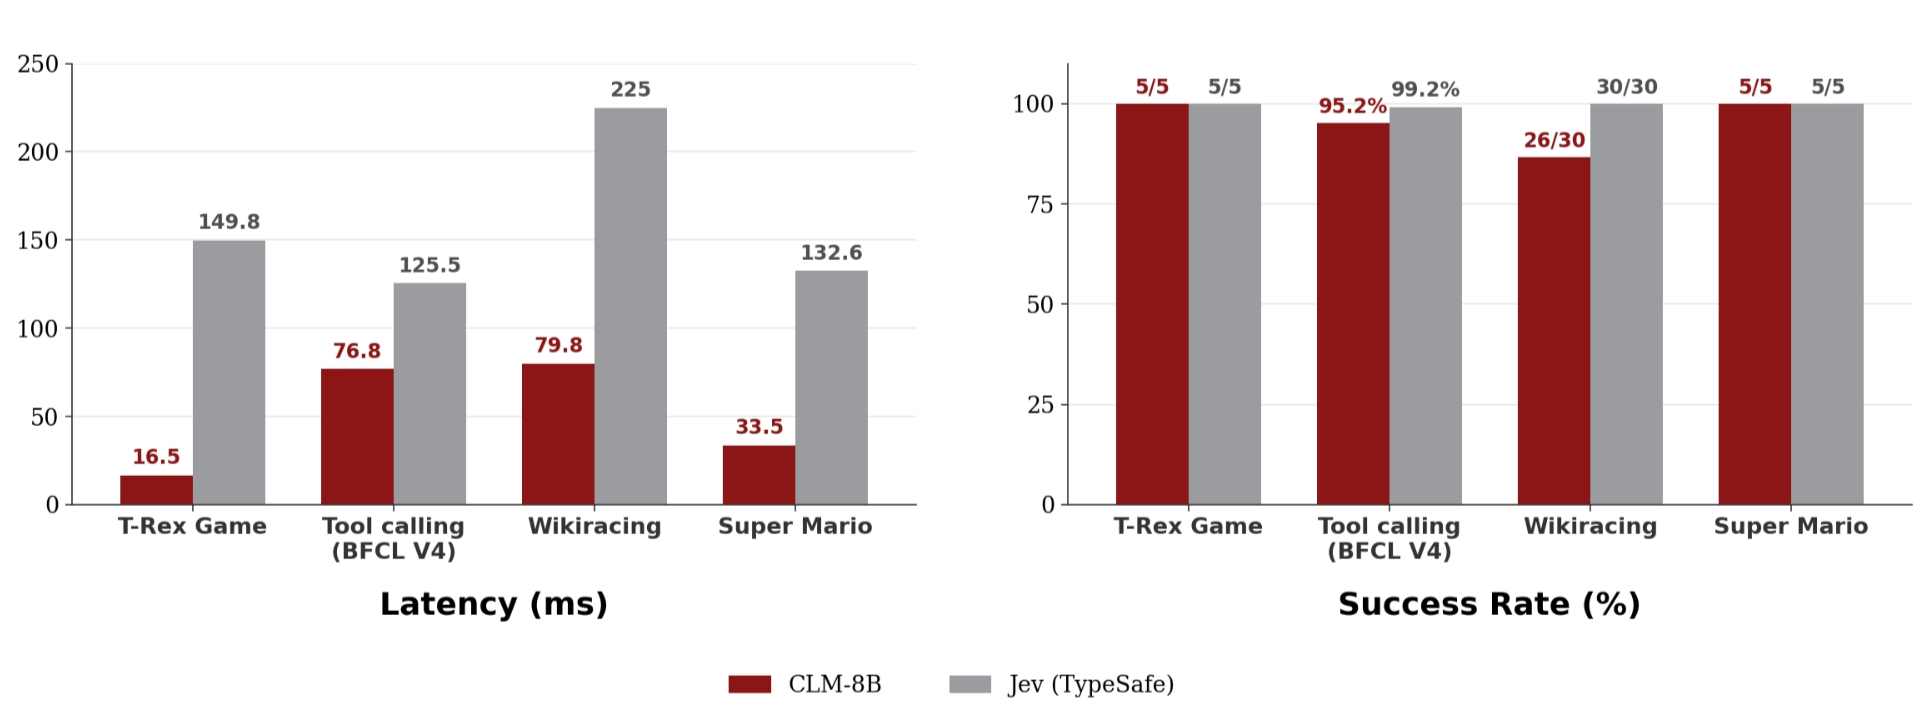
Başarı sütunları da en az hız kadar önemli. Araç çağırmada CLM %95,2, Jev %99,2; WikiRacing’de CLM 26/30, Jev 30/30 sonuç veriyor. Bu iki görevde daha düşük gecikme, eşit başarıyla gelmiyor.
T-Rex yöntem belgesi ayrıca önemli bir ayrıntı içeriyor: fizik tabanlı bir planlayıcı, modele hangi hareketlerin güvenli olduğunu söylüyor. Açık olan koruma katmanı, gerektiğinde güvensiz cevabı değiştiriyor. Beş parkurda hayatta kalma sonucu bu birleşik sistemi ölçüyor; tek başına modelin oyun becerisini değil. CLM deneyi RTX 4090 üzerinde yerel kodlayıcıyla, Jev deneyi barındırılan API ile yapılmış. İstemci tarafından ölçülen bu süreleri aynı donanımda saf çıkarım karşılaştırması olarak sunamayız.
Kodlama skorları: Çözüm yazmak ile çözüm seçmek farklı
İkinci grafikte DeepSWE için %81,6, Terminal-Bench 2.1 için %87,6 bildiriliyor. Bu deneylerde CLM kodlama görevini baştan sona kendi çözmüyor. Başka modellerin ürettiği birden fazla çözüm arasından seçim yapan bir doğrulayıcı olarak kullanılıyor.
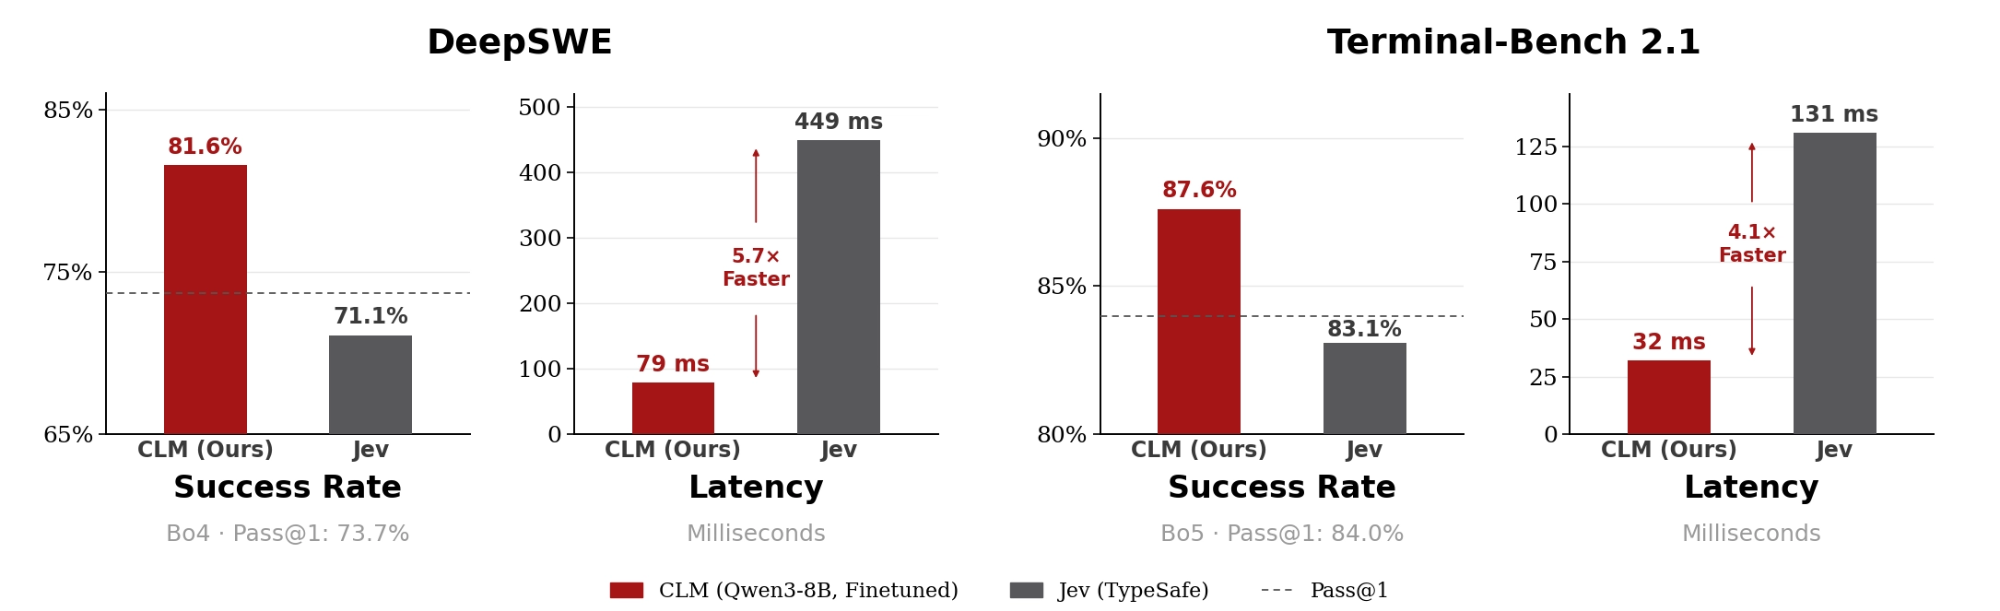
Depo, değerlendirmelerin 38 DeepSWE ve 30 Terminal-Bench görevinden oluşan ayrılmış kümelerde yapıldığını belirtiyor. DeepSWE adayları Opus 5, Terminal-Bench adayları Fable 5 ile üretilmiş. Yüksek sonuçlar göreve uyarlanmış başlıklara ait; indirilen temel başlığın kutudan çıktığı hâliyle bu skorları verdiği söylenmiyor. Gecikme ölçümlerinde H100 kullanılmış.
canberk.me açısından buradaki ilginç fikir şu: güçlü bir modele birkaç çözüm ürettirip, daha dar bir modele bunların arasından seçim yaptırmak. Ama birden fazla aday üretmenin de bedeli var. Doğrulayıcının hızını, aday üretimi dâhil bütün iş akışının maliyetinden ayrı değerlendirmek gerekiyor.
Yüzde 99 güven, yüzde 99 doğruluk demek mi?
Model kartı, olasılıkların verilen aday kümesine göre hesaplandığını açıkça belirtiyor. Doğru cevap seçenekler arasında yoksa sistem yine kalan seçeneklerden birini öne çıkarabilir.
Örneğin “Aboneliğimi iptal edin” mesajını yalnız “faturalandırma” ve “teknik sorun” seçenekleriyle değerlendirirsek yüksek bir oran görmek, sınıflandırmanın amaca uygun olduğunu kanıtlamaz. Seçeneklerin içeriği ve açıklamaları, modelin karar probleminin parçasıdır.
Bizim önerimiz, gerçek uygulamada “inceleme gerekli” yolunu da tasarlamak ve eşikleri etiketli örneklerle sınamak. Özellikle Türkçe, karışık dil ve bağlam dışı mesajlar için ayrı bir test kümesi gerekir. İncelediğimiz kaynaklarda Türkçe üretim kullanımını doğrulayan kapsamlı bir değerlendirme bulamadık.
Kim denemeli, ilk deney ne olmalı?
Resmî kurulum yolu Linux, NVIDIA GPU, Python 3.10+ ve vLLM kullanıyor. Qwen3-8B kodlayıcısı ile CLM API’si ayrı çalışıyor; tarayıcıdan kullanılabilen bir deneme arayüzü de var. Kod ve yayımlanan ağırlıklar Apache 2.0 lisansıyla sunuluyor. Yerel barındırma kontrol sağlasa da GPU, işletim ve değerlendirme maliyetini ortadan kaldırmıyor.
İlk deneyimiz otomatik e-posta gönderimi veya silme işlemi olmazdı. Kişisel bilgilerden arındırılmış TR/EN okuyucu mesajlarını üç editoryal kuyruğa ayırır; sonucu bir insanın etiketleriyle karşılaştırırdık. Basit kurallar ve genel amaçlı bir dil modeli de aynı örnekleri görürdü. Ölçülecekler: yanlış ama yüksek güvenli kararlar, incelemeye düşen mesajlar, toplam yanıt süresi ve gerçek maliyet.
CLM-8B’yi değerli kılan, karar katmanını incelemeye ve kendi verimizle sınamaya açması. Projeyi bağımsız olarak benchmark etmedik. Eldeki kanıtlar, bütün işlerde Jev’in yerine geçeceğini göstermiyor; belirli ajan kararlarında test edilmeye değer, açık bir alternatif sunduğunu gösteriyor.
Kaynaklar
- CLM: mimari, API, değerlendirmeler ve Apache 2.0 lisansı ↗Contrastive-LM projesi
- CLM-v0.1-8B: resmî model kartı ve sınırlamalar ↗Contrastive-LM / Hugging Face
- T-Rex: gerçek zamanlı karşılaştırmanın yöntemi ve güvenlik müdahaleleri ↗Contrastive-LM projesi
- Contrastive Language Models: 24 Eylül Hacker News tartışması ↗Hacker News
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder