OpenDecider, açık karar modellerini Jev ve Laya ile karşılaştırıyor
400 milyon ve 4 milyar parametreli OpenDecider modelleri, sınırlı seçenekler için olasılık döndürüyor. Geliştiricinin testlerinde hangi modelin öne çıktığı göreve göre değişiyor.
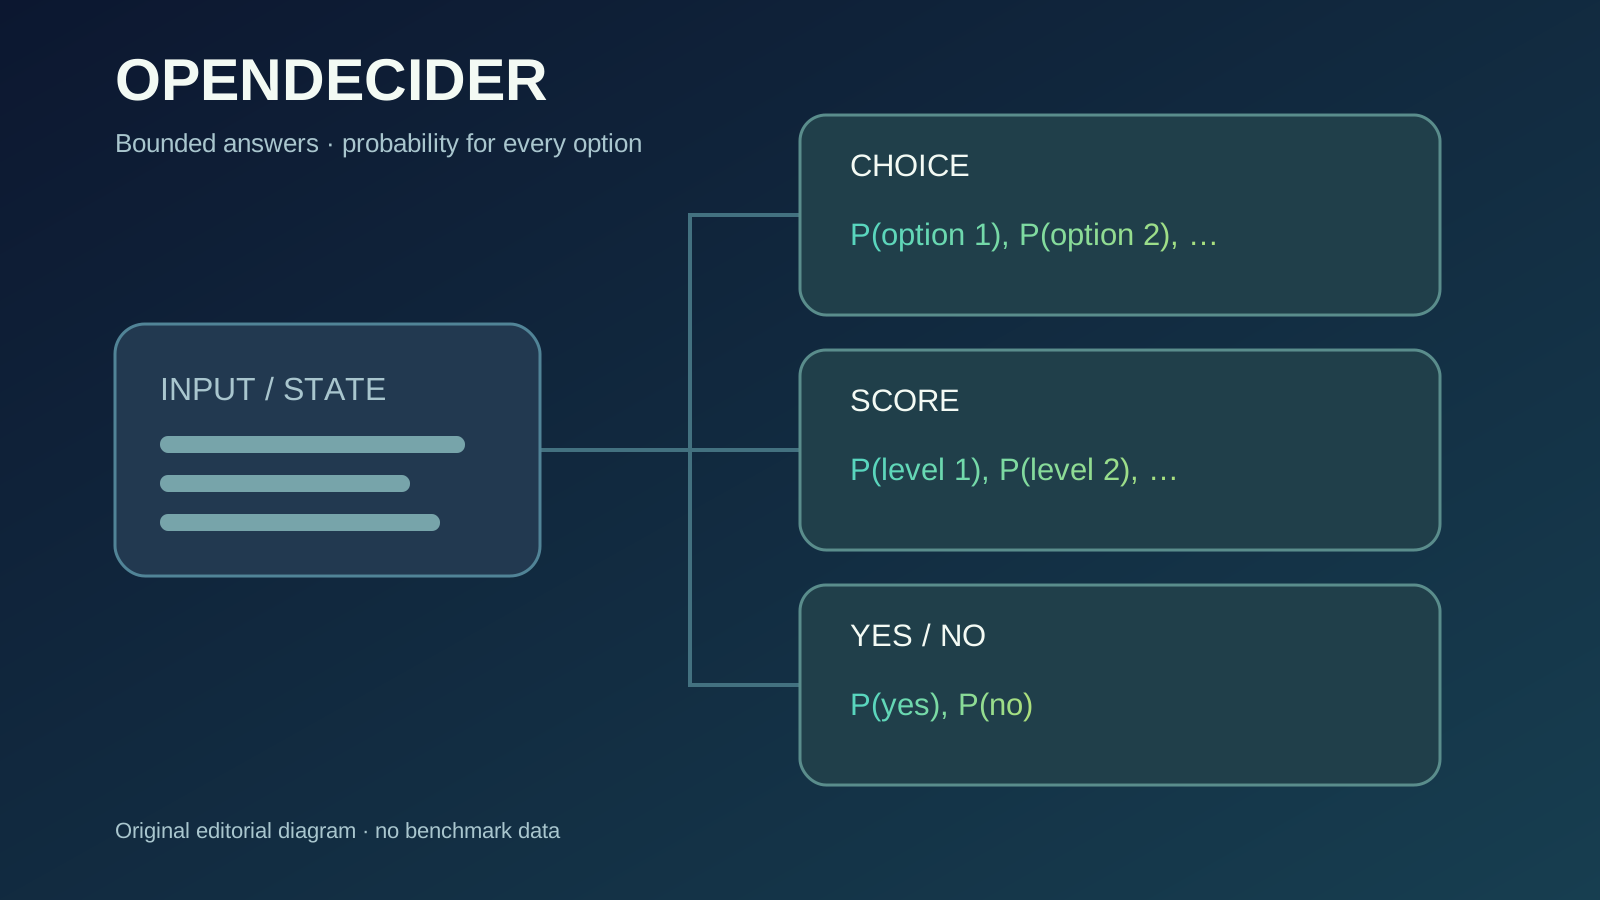
Açık bir karar modeli, metin veya yapılandırılmış bir durum hakkında sınırları belirli bir soruyu yanıtlayıp izin verilen seçeneklerin olasılıklarını döndürür. Manjunath Janardhan, 27 Eylül’de yayımladığı OpenDecider duyurusunda bu amaçla iki model sunuyor: yaklaşık 400 milyon parametreli OpenDecider-nano ve 4 milyar parametreli OpenDecider-small. Destek kaydını ilgili ekibe yönlendirmek ya da aciliyetini puanlamak gibi, uygulamanın serbest bir açıklama yerine tanımlı bir yanıt beklediği işlere odaklanıyorlar.
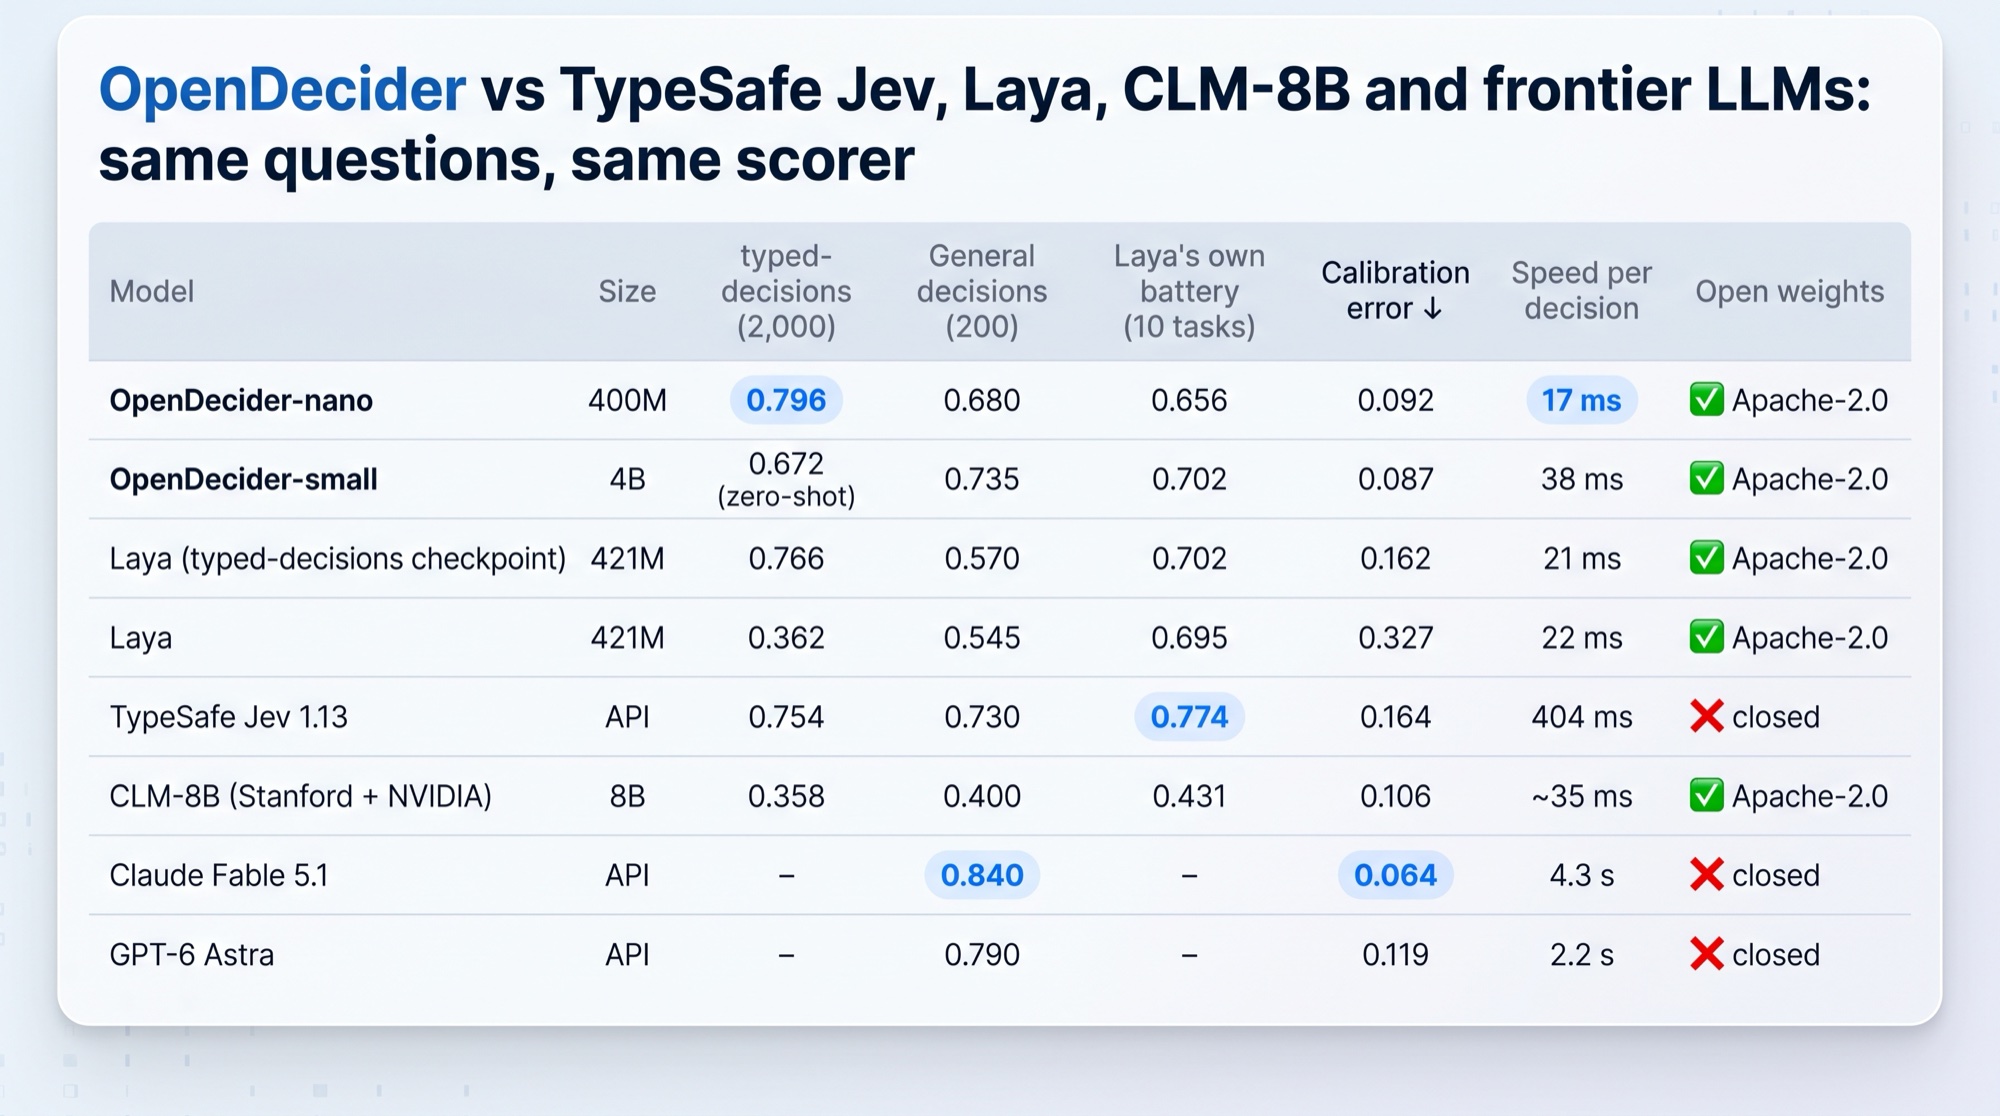
Duyurunun başlığı TypeSafe Jev ve Laya ile karşılaştırmaya dayanıyor. Ancak hangi modelin öne çıktığı veri kümesine ve modelin o kümenin eğitim bölümünde eğitilip eğitilmediğine bağlı. Aşağıdaki rakamlar OpenDecider geliştiricisinin bildirdiği sonuçlar. Açık model kartlarını ve karşılaştırma notlarını inceledik; modelleri yeniden çalıştırmadık, veri kümelerini bağımsız olarak denetlemedik.
İki model, farklı görevler
Nano, Ettin kodlayıcısını kullanıyor. Her yanıt seçeneğine ayrı bir işaret koyup bunlardan puan çıkarıyor ve puanları olasılığa dönüştürüyor. Nano kartında toplam 2.048 token girdi sınırı, çalışırken yaklaşık 2 GiB bellek kullanımı ve NVIDIA L40S üzerinde tek soru için 16 ms ölçümü var. Bunlar belirli koşullardaki model rakamları; uçtan uca hizmet gecikmesi vaadi değil.
Small, Qwen3-4B-Instruct-2507 üzerine eklenmiş bir LoRA adaptörü. Harfle işaretlenen seçeneklerin sonraki token olasılıklarını okuyarak yanıt cümlesi üretmeden karar veriyor. Model kartı, yaklaşık 8,9 GiB çalışma belleği ve L40S üzerinde tek soru için 38 ms bildiriyor. Adaptörün yanında temel Qwen modeli de gerekiyor. Ayrıca typed-decisions eğitim bölümüne uyarlanmış small-td sürümü bulunuyor; bu genel small modeliyle karıştırılmamalı.
| Geliştiricinin bildirdiği doğruluk | Nano | Small | Small-td | Laya typed-decisions | Jev 1.13 |
|---|---|---|---|---|---|
| typed-decisions, 2.000 test öğesi | 0,796 | 0,672 | 0,792 | 0,766 | 0,754 |
| Genel kararlar, 200 öğe | 0,680 | 0,735 | 0,715 | 0,570 | 0,730 |
| Laya uygulama testleri, 10 × 400 öğe | 0,656 | 0,702 | 0,703 | 0,702 | 0,774 |
Karşılaştırma notlarına göre nano, small-td ve Laya’nın typed-decisions sürümü bu veri kümesinin eğitim bölümünü kullandı; test bölümü ayrıldı. Genel small sürümü bu eğitimi almadı. Dolayısıyla typed-decisions puanının daha düşük olması şaşırtıcı değil. Bu modelin puanı tarihli duyuruda 0,672, deponun güncel tablosunda 0,671; yukarıdaki tablo duyuruyu izliyor. Nano ile Laya arasındaki bildirilen fark üç yüzde puanı; eşleştirilmiş bootstrap ile hesaplanan %95 aralığı 1,4–4,4 puan. Bu, söz konusu testteki belirsizliği anlatır; başka bir şirketin kayıtlarında aynı farkı garanti etmez.
Sıralama nerede değişiyor?
200 genel kararda small 0,735, Jev 0,730 alıyor. Yarım yüzde puanlık fark, geliştiricinin bu küçük küme için yaklaşık üç puan olarak verdiği belirsizlikten daha küçük. Burada sonuçları yakın kabul etmek daha doğru. Laya’nın uygulama testlerinde ise Jev 0,774 ile lider. Kimlik avı görevinde geliştiricinin tablosu Jev için 0,897, small için 0,630 veriyor. Özellikle yönlendirme ve güvenlik işlerinde, yalnızca typed-decisions başlığına göre seçim yapmak yerine kendi örneklerinde hataları, yanlış alarm maliyetini ve güven eşiklerini ölçmek gerekir.
Genel kararlar için bildirilen beklenen kalibrasyon hatası small’da 0,087, Jev’de 0,164, Laya’nın typed-decisions sürümünde 0,162; bu ölçütte düşük değer daha iyi. Kalibrasyon, modelin belirli bir güvenle verdiği yanıtların çok sayıda örnekte yaklaşık o sıklıkta doğru çıkmasıdır. Belirsiz vakaları insana aktarmak açısından yararlı olsa da tek İngilizce testindeki rakam başka bir iş akışı için güvenli otomasyon eşiği belirlemez.
Duyuru CLM-8B’yi de tabloya koyuyor. Düşük typed-decisions puanı, CLM hakkında tek başına hüküm vermek için yeterli değil: geliştiricinin de belirttiği gibi CLM, sınırları belirli bir sınıflandırıcıdan farklı görev ve arayüze sahip karşıtsal bir yeniden sıralayıcı. Bu karşılaştırma bağlam sağlar; eşdeğer ürün önerisi sayılmaz. Gecikme rakamlarında da yerel GPU, Apple Silicon ve ağ süresini içeren API çağrıları karışıyor; kontrollü donanım hız sıralaması olarak okunmamalı.
Erişim ve açık kalan sınırlar
Nano ve small kartları yayımlanan modeller için Apache-2.0 lisansı gösteriyor. Depoda kod ve kayıtlı tahmin sonuçları, ilk deneme için nano kullanan bir canlı demo var. Geliştirici yaklaşık 190 bin soruyla eğitim ve test metinleriyle örtüşme kontrolü bildiriyor; bunları bağımsız doğrulamadık. Sonuçlar tek eğitim başlangıcına dayanıyor ve OpenDecider yalnızca İngilizce değerlendirildi. Laya’nın çok dilli bir sürümü var; bu bilgi burada Türkçe bir başa baş test yapıldığı anlamına gelmiyor.
Kullanım kararı için gerçek iş akışından etiketli örnekler hazırlayıp adayları aynı yanıt şeması ve puanlama kuralıyla ölçmek, hatalar kadar kalibrasyonu da incelemek gerekir. Sonuç doğurabilecek kararlar için insan incelemesi yolu korunmalı. Açık yayın, yeniden üretilebilir bir başlangıç sunuyor; performans sonuçları şimdilik geliştiricinin ölçümleri.
Kaynaklar 28 Eylül 2026’da kontrol edildi. Kapak özgün editoryal çizimdir; resmî karşılaştırma görselinin ayrıca yeniden kullanım koşulları doğrulanamadığı için yalnızca bağlantısı verildi.
Kaynaklar
- OpenDecider duyurusu ve karşılaştırması ↗Manjunath Janardhan / Hugging Face Community
- OpenDecider-nano model kartı ↗Hugging Face / Manjunath Janardhan
- OpenDecider-small model kartı ↗Hugging Face / Manjunath Janardhan
- OpenDecider karşılaştırma ve değerlendirme notları ↗GitHub / Manjunath Janardhan
- Laya çok dilli model kartı ↗Hugging Face / Convai Innovations
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder