Jeff, Jev tarzı karar modellerini 0,8B'ye küçültüyor ve yaklaşık 22 ms'de cevap veriyor
Jeff, Jev'in istek biçimini konuşan küçük açık karar modelleri ailesi. README'si hızlı cevaplar ve Jev karşısında karışık bir doğruluk bildiriyor, ayrıca uzun seçenek listeleri için bir v1.1 düzeltmesi var.
Bu yazıda
Jeff, 28 Eylül’de Hacker News’te görünen ve Jev ve Laya-MLX yazımızda ele aldığımız tipli karar modeli Jev’in istek biçiminde cevap veren üç küçük açık modelden oluşan bir aile. PostHog’un Jeeves’i akıl yürütme ekleyip bunun bedelini gecikmeyle öderken Jeff ters yöne gidiyor: modeli küçültüyor ve on milisaniyeler içinde cevap veriyor. Proje, bağımsız olduğunu, Jev’in yapımcısı TypeSafe ile ilişkisi ve onayı bulunmadığını söylüyor. Aşağıdaki rakamlar projenin README’sinden geliyor ve hiçbirini biz yeniden üretmedik.
Ne olduğu
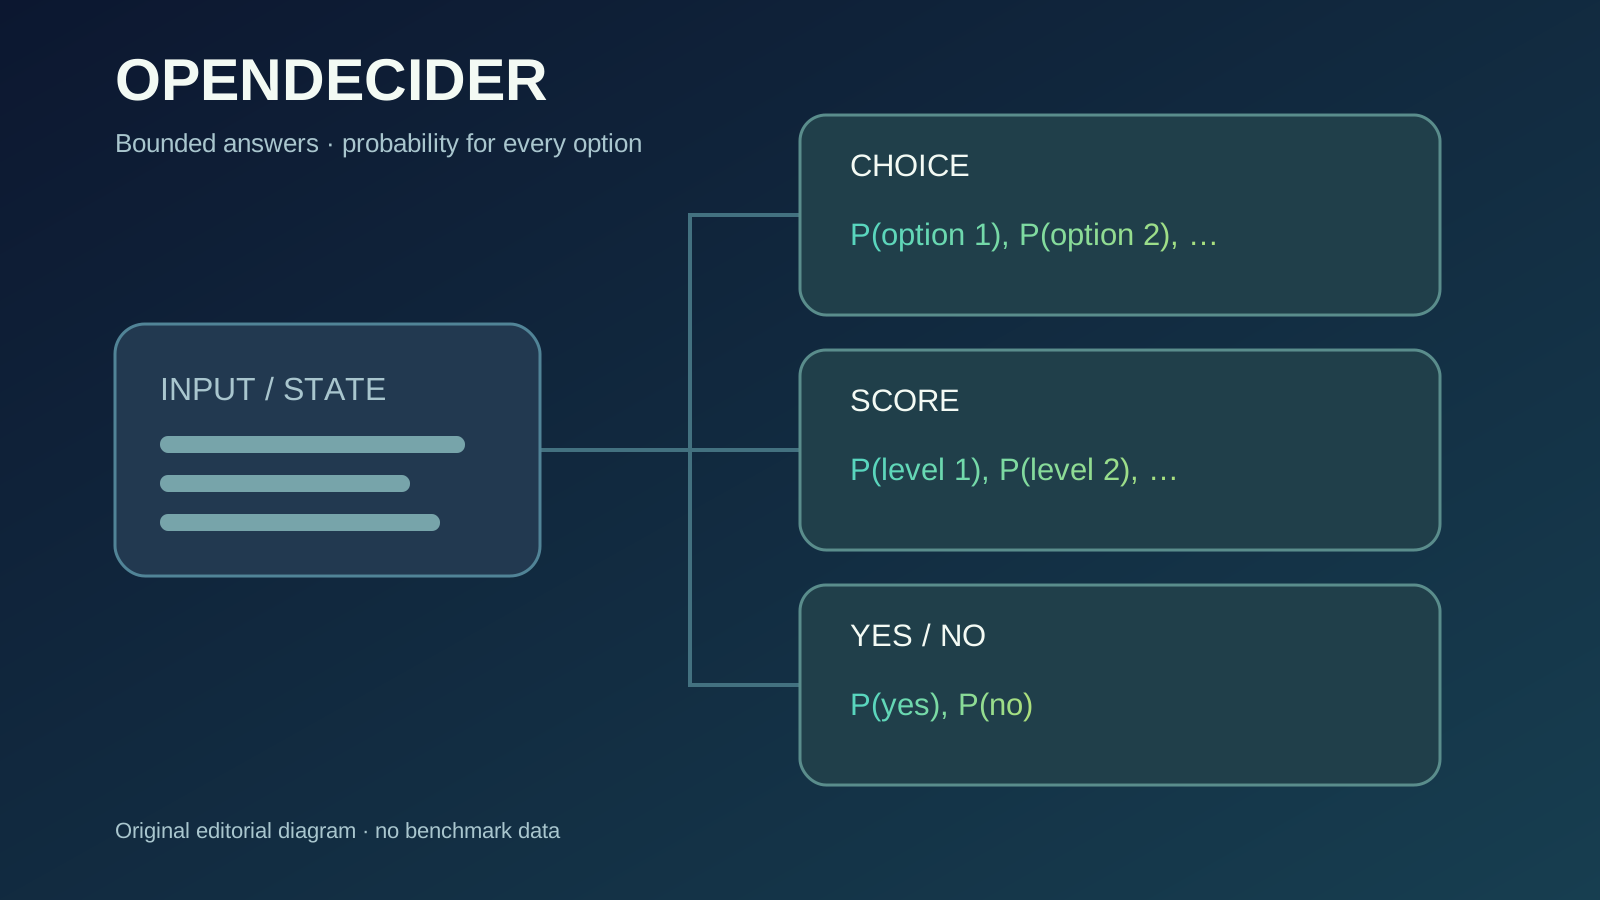
Jeff üç ince ayardan oluşuyor: Jeff-Qwen3.5-0.8B, Jeff-Qwen3.5-2B ve Jeff-Gemma4-E2B. Bir durumu ve seçenekleri düz kelimelerle anlatıyorsunuz, Jeff tek bir ileri geçişte her seçenek için kalibre edilmiş bir olasılık döndürüyor; ayrıştırılacak üretilmiş bir metin yok. Jev’le aynı üç soru türünü destekliyor: seçim, evet/hayır (noul) ve puan.
Proje, Qwen3.8-27B’yi Jev tarzı kararlar verecek şekilde ince ayarlayan, MIT lisanslı açık bir tarif olan AutoJev’in çatalı olarak başladı ve bu fikri çok daha küçük öğrencilere indiriyor. Kod MIT, ağırlıklar Apache 2.0. Eğitim verisi yayımlanmadı ve kaynaklarından bazıları share-alike.
Hız ve boyut
README, aynı 200 benchmark sorusu üzerinde (her biri yaklaşık 200 girdi token’ı), tek tek, ham metinden olasılığa kadar karar başına medyan süreyi ölçüyor.
| Model | Ağırlık (16 bit) | RTX PRO 6000 | Apple M4 Max (MLX) | CPU (32 iş parçacığı) |
|---|---|---|---|---|
| Jeff-Qwen3.5-0.8B | 1,7 GB | 22 ms | 28 ms | 463 ms |
| Jeff-Qwen3.5-2B | 4,2 GB | 24 ms | 60 ms | 708 ms |
| Jeff-Gemma4-E2B | 9,3 GB | 29 ms | yok | 1,0 sn |
Karşılaştırma için README, Jev’in yayımlanmış Doom çalışmalarında ağ dahil çağrı başına 114 ile 212 ms sürdüğünü not ediyor. İkisi aynı donanımda ölçülmedi, bu yüzden bunu bir sıralama değil, bağlam olarak okuyun.
Jev karşısında doğruluk
README, Jeff’i beş herkese açık benchmark’tan 4.599 soru ve JevBench’in herkese açık zor kademesi üzerinde test ediyor ve sonuçları Jev’in yayımlanmış rakamlarının yanına koyuyor. Qwen sütunları v1.1; Gemma modeli hâlâ v1.0.
| Benchmark | Jeff 0,8B | Jeff 2B | Jeff Gemma | Jev (yayımlanmış) |
|---|---|---|---|---|
| Genel (beş benchmark) | 79,1 | 82,0 | 81,6 | 83,0 |
| Financial PhraseBank | 95,7 | 94,7 | 96,1 | 77,0 |
| RAGTruth | 85,6 | 87,7 | 87,4 | 77,3 |
| BBH | 64,9 | 68,7 | 66,4 | 94,3 |
| JudgeBench | 63,1 | 59,4 | 60,6 | 78,6 |
| WinoGrande | 69,0 | 78,8 | 77,4 | 90,7 |
| JevBench zor (105 madde) | 46,7 | 57,1 | 48,6 | 73,3 |
Örüntü bu boyutta beklenen bir şey. Jeff, sınıflandırma ve dayanak testlerinde Jev’i yakalıyor ya da geçiyor, akıl yürütme ağırlıklı testlerde ise çok geride kalıyor. README bunu kendisi de söylüyor. Önemli çekince: Jev’in rakamları aynı benchmark’ların farklı bir örnekleminde ölçülmüş, bu yüzden farklar kesin değil, gösterge niteliğinde. Ayrıca bu README herkese açık zor kademede 105 madde sayarken Jeeves’in README’si 111 sayıyor; farklı projelerin rakamlarını yan yana koymamak için bir neden daha.
v1.1 düzeltmesi
En ilginç ayrıntı bir hata. 28 Eylül’de çıkan v1.0, hiçbir eğitim sorusunda 19’dan fazla seçenek olmadığı için 26. seçeneğin ötesini hiç seçmiyordu. Bir kullanıcı bunu bildirdi ve proje 29 Eylül’de 20 ile 254 seçenekli 32.000 yeni eğitim sorusuyla v1.1’i yayımladı. Uzun liste testinde 0,8B model %40,3’ten %94,7’ye, 2B model %95,2’ye çıktı. 0,8B’nin kalibrasyon hatası 0,049’dan 0,021’e düştü.
Bunun bir bedeli de oldu. 2B’nin genel skoru %83,1’den %82,0’a indi, yani artık Jev’in yayımlanmış %83,0’ını geçmiyor; ayrıca MASSIVE ve CLINC150 veri kümeleri artık eğitim verisinde, dolayısıyla sıfır atış testi sayılmıyor. Gemma modeli yeniden eğitilmedi ve en fazla 26 seçenekle çalışmaya devam ediyor. Depodaki grafik hâlâ eski v1.0 rakamlarını gösteriyor, bu yüzden README’nin tablosunu kullanın.
Yerel donanımda inşa edildi
Yazar, eğitimin tek bir RTX PRO 6000’de yapıldığını söylüyor: 0,8B model için yaklaşık iki saat, 2B için üç buçuk saat. Sentetik eğitim verisini iki DGX Spark üzerindeki açık bir model (Qwen3.8-Flash-Next) yazmış, testler bir MacBook’ta yapılmış. Bulut GPU kullanılmamış ve eğitim verisinde kapalı model çıktısı yok; kapalı bir model yalnızca bir örneğin kalitesini kontrol etmek için kullanılmış.
Sınıflandırmanın ötesi: oyunlar ve satranç
Sıfır atış davranışını yoklamak için README, Jeff’e her tur durumu ve yasal hamleleri kelimelerle anlatarak üç oyun oynatıyor (v1.0 ile ölçülmüş). 0,8B model Doom’da 6,55 öldürme, Frogger’da 10,3 geçiş ve Pac-Man’de 98 yemden 57,0’ını aldı; ilk ikisinde elle kodlanmış bir kural botuna yaklaşık denk. M4 Max’te hamle başına 29 ile 49 ms’de karar verdi.
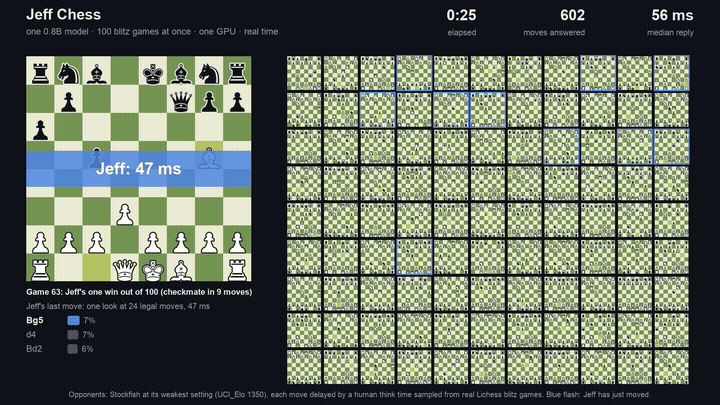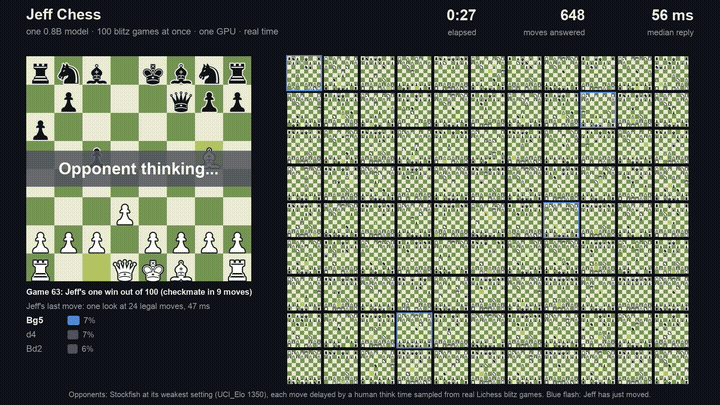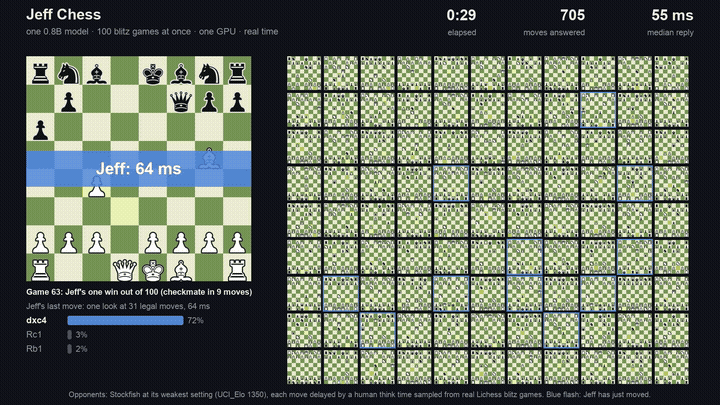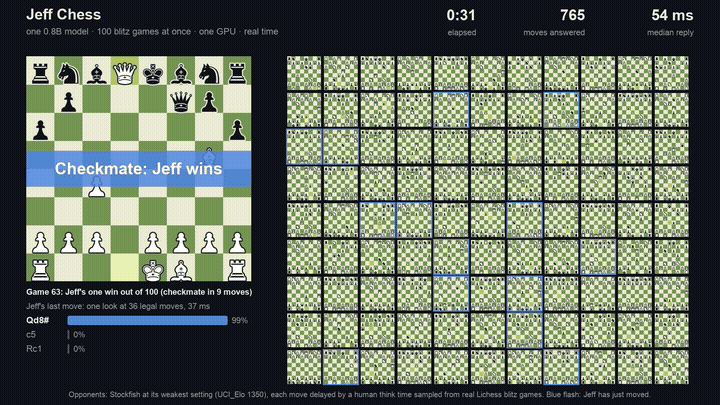
Bir satranç ince ayarı, hızın öbür kullanımını gösteriyor. Stockfish’in etiketlediği 600.000 pozisyonda yaklaşık üç buçuk saat eğitilen 0,8B model, ayrılmış 1.000 bulmacanın %55,8’ini çözdü; sıfır atışta bu %15,5’ti. Zayıf bir oyuncu, aramasız yaklaşık 1.000 Elo, ve aşağıdaki klip Stockfish’in en zayıf ayarına karşı aynı anda oynanan 100 oyundaki tek galibiyeti.
Sınırlar
- Küçük modeller akıl yürütmez. Anlattığınız seçenekler arasında hızlı, kalibre edilmiş tercihler bekleyin, çok adımlı akıl yürütme değil. README bunun bu boyuttaki her model için geçerli olduğunu söylüyor.
- İfade çok önemli. Frogger’da hedef seçeneğe diğerleriyle aynı kelimeleri vermek, bir bölümü 15 geçişten 23’e çıkardı.
- Benchmark skorları davranışı öngörmüyor. Eğitilmemiş Gemma modeli benchmark’larda Qwen modellerini geçiyor ama oyunları en kötü oynuyor. 2B, benchmark’larda 0,8B’den yüksek skor alıyor ama daha kötü oynuyor.
- Yalnızca İngilizce ve metin, ve Jev’le karşılaştırmalar yazara ait, farklı örneklemlerde.
Bizim değerlendirmemiz
Jeff, gecikme ve maliyetin baskın olduğu ve kategorilerin sade olduğu yerlerde en yararlı görünüyor: bir mesajı bir kuyruğa yönlendirmek, niyet etiketlemek, moderasyon etiketleri, cihaz üstü ya da çevrimdışı kullanım. Bunlar için 1,7 GB’lık, yaklaşık 22 ms’de cevap veren bir model, saniyelerle cevap veren bir akıl yürütme modelinden farklı bir teklif. Gerçek akıl yürütme gerektiren işlerde daha zayıf bir seçim; orada Jev ve Jeeves gibi modeller daha güçlü.
Değerlendirecekseniz kendi etiketli maddelerinizle test edin, her adaya aynılarını verin ve doğrulukla birlikte kalibrasyonu da kontrol edin. Seçenek listelerinizi de gerçekten kullanacağınız boyutta deneyin, çünkü v1.0’ın yanlış yaptığı şey tam olarak uzun listelerdi. Bu ailedeki diğer açık seçenekler için OpenDecider ve Jeeves notlarımıza bakabilirsiniz.
Kapak yapay zekâ ile üretilmiş bir çizimdir ve resmî bir tasarım değildir. Satranç klibi projenin kendi demosudur.
Kaynaklar
- Jeff: small, fast Jev-compatible decision models (README) ↗firelex / GitHub
- Jeff (Hacker News discussion) ↗Hacker News
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder