Strands Decider 2B: ajanlar için küçük, açık bir karar modeli
Strands Decider 2B, kod, ağırlık ve eğitim verisiyle açık, Jev sınıfından 2B bir karar modeli. Bildirdikleri, sınırları ve bir tool call koruması.
Bu yazıda
Jev sınıfındaki karar modellerine bir yeni oyuncu daha katıldı. Strands Decider 2B, Strands harness yazımızda ele aldığımız harness’in arkasındaki açık kaynak ajan SDK’sı Strands projesi tarafından 1 Ekim’de yayımlandı. TechCrunch bunu bir AWS yayını olarak anlatıyor. Okuduğumuz yazı, repository ve model kartı Strands’in kendi hesaplarından geliyor (GitHub’da strands-agents ve strands-labs organizasyonları, Hugging Face’te StrandsAgents organizasyonu) ve projenin kime ait olduğunu söylemiyor, bu yüzden Strands ekibine atfediyoruz. Eğitim tarifi bir AWS p5.48xlarge makinesinde çalıştı ve örnek ajan Amazon Bedrock kullanıyor. Aşağıdaki tüm rakamlar Strands ekibinin, bağımsız olarak doğrulanmadı.
Karar modelleri nedir
Yazı Strands Decider’ı, TypeSafe’in Jev’inin bu ay açtığı, TypeSafe’in System One modelleri dediği sınıfa yerleştiriyor. Metin üretmek yerine, verilmiş seçenekler arasından seçiyor (bu kahve makinesiyle ilgili mi, evet ya da hayır; üç dilden hangisi) ya da bir şeyi bir ölçekte puanlıyor ve her karara bir güvenilirlik skoru ekliyor. Strands’in dile getirdiği takas: belirli bir boyutta daha hızlı ve daha yetenekli, ama karmaşık problemlerde akıl yürütme modellerinden “belirgin biçimde daha zayıf” ve kodlama, chatbot ya da özetleme için uygun değil. Bu sınıfı Jev ve Laya-MLX, OpenDecider, CLM-8B, Jeeves ve Jeff ile izledik.
Nasıl kurulmuş
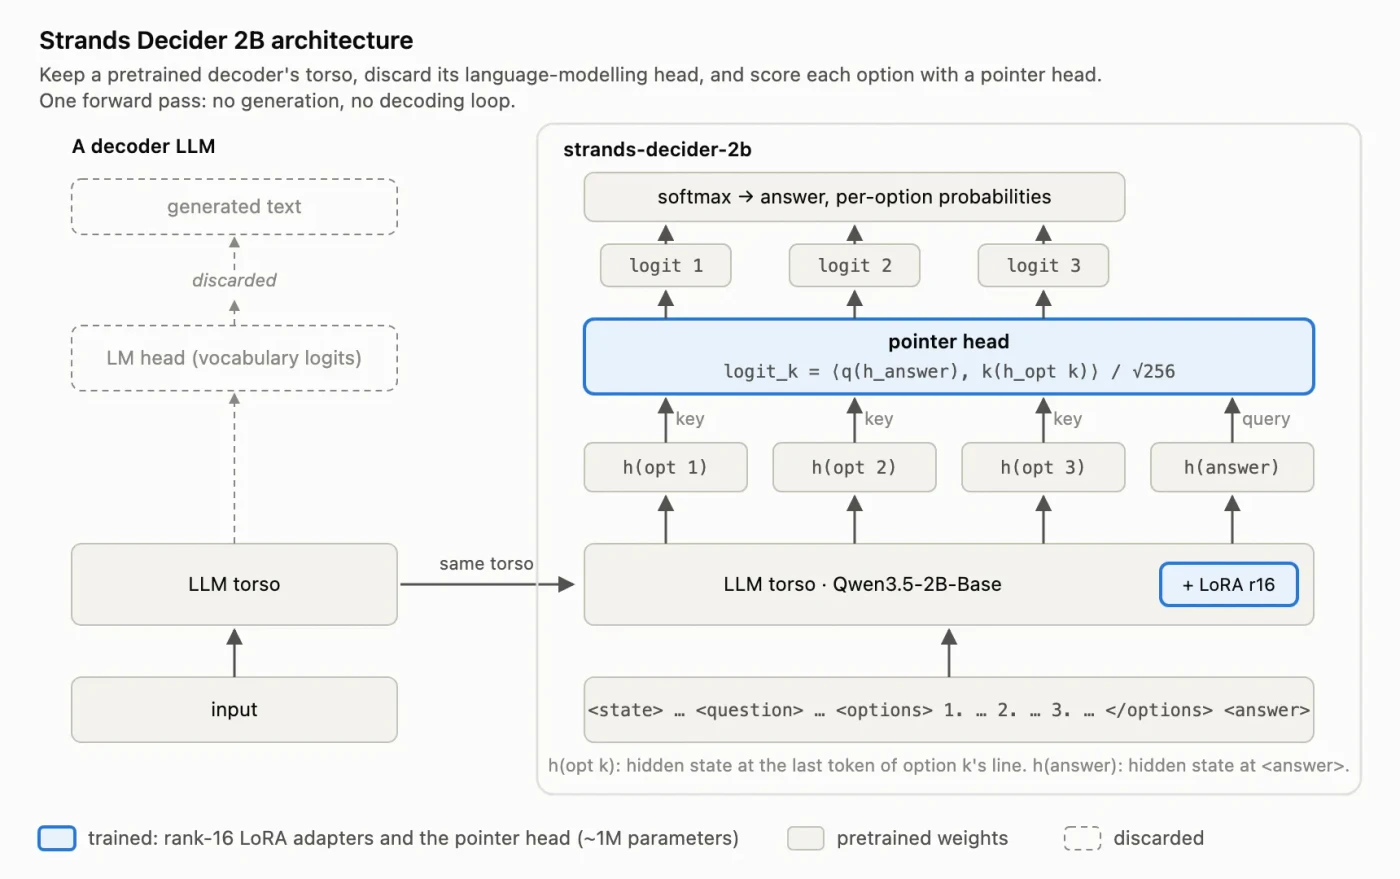
Strands önceden eğitilmiş bir LLM’i, Qwen3.5-2B-Base’i alıyor, dil modeli head’ini kaldırıyor ve yerine küçük bir pointer head koyuyor. Head, her seçeneği o seçeneğin hidden state’ini <answer> konumundaki hidden state ile karşılaştırarak puanlıyor; tek bir forward pass’te, decoding döngüsü yok. Eğitilen parçalar rank-16 LoRA adaptörleri ve head, yaklaşık bir milyon parametre. Yayımlanan model, ikinci mimarinin v19’u; “slot head” kullanan ilk sürüm belirgin biçimde daha kötü performans göstermiş. Eğitim hedefleri arasında dondurulmuş bir Qwen/Qwen3.5-4B öğretmen modelinin çıktı dağılımları, ayrıca açık veri setleri ve sentetik satırlar var.
Rakamlar ne söylüyor
JevBench’in 231 public görevinde model kartı şunu bildiriyor:
| Ölçü | Değer |
|---|---|
| Doğruluk | %72,3 (231’de 167) |
| Brier skoru (düşük iyi) | 0,348 |
| Kalibrasyon hatası (ECE) | 0,050 |
Strands bunun 2B sınıfında 33 modelden 3.’lük, 2B’yi biraz aşan modeller hariç tutulunca 30 modelden 1.’lik olduğunu ve modelin JevBench’in kolay görevlerinin %100’ünü yaptığını söylüyor. Model kartı ayrıca kendi tarifinden iç held-out setleri de listeliyor: bir boardgame setinde %82,2, ContractNLI’da %87,2 ve MuSiQue’de %88,4 gibi; bunlar harici bir benchmark değil.
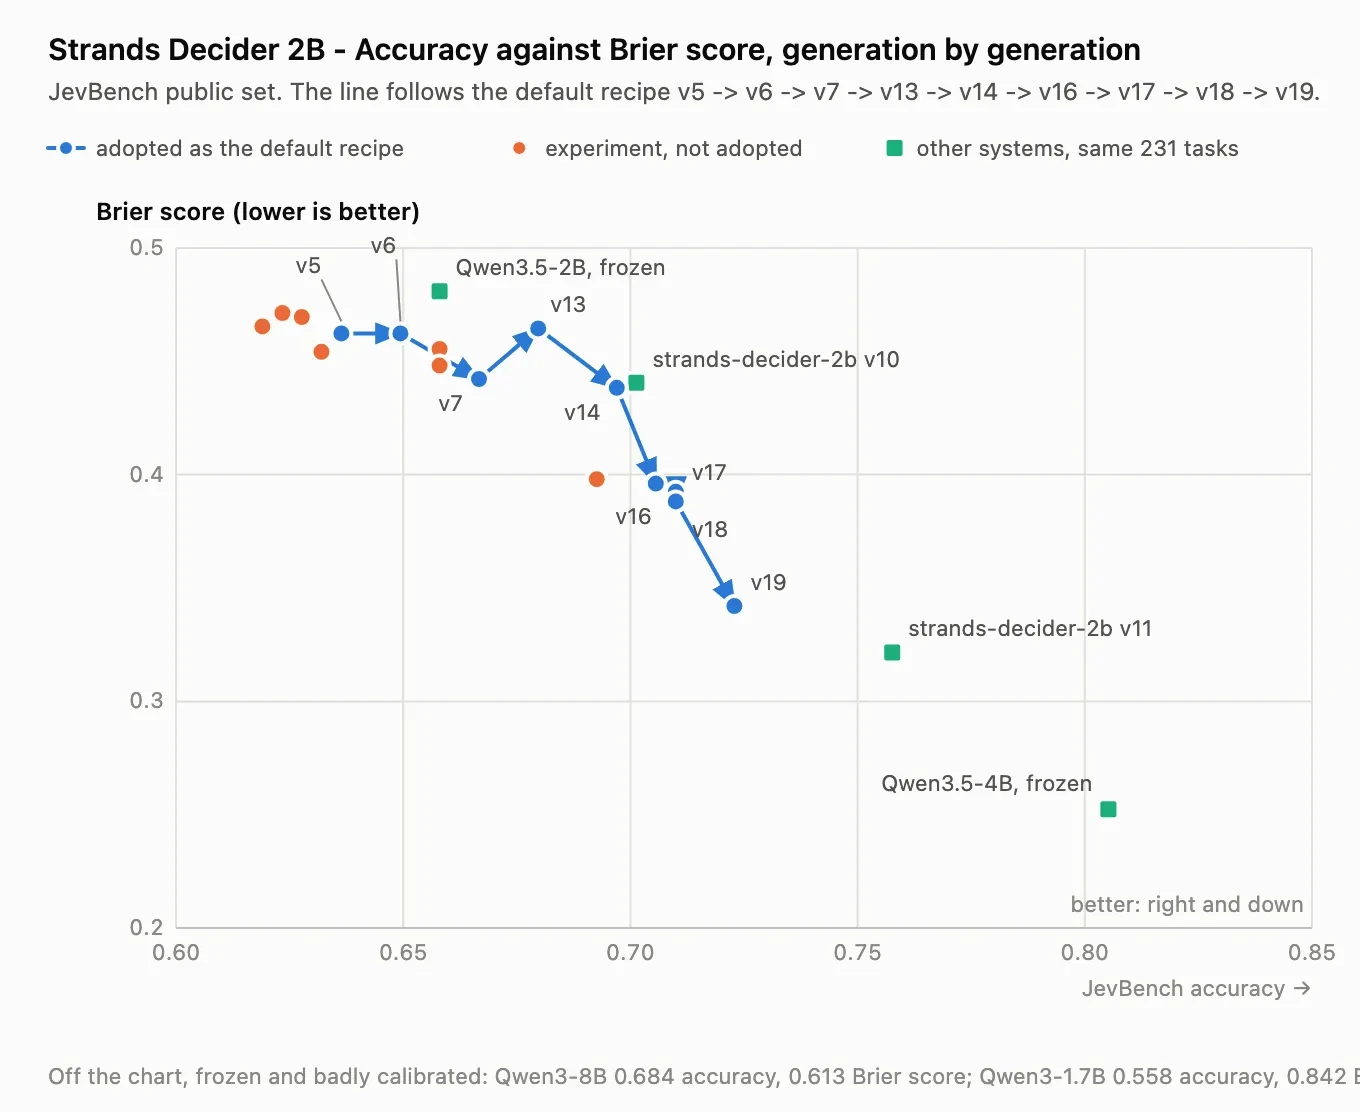
Grafik manşetten fazlasını gösteriyor. Aynı 231 görevdeki diğer sistemleri yeşille işaretliyor ve bizim okuyuşumuza göre dondurulmuş bir Qwen3.5-4B yaklaşık 0,81 doğruluk ve 0,25’e yakın Brier skorunda, v19’un her ikisinde de önünde. Bu model öğretmen, yani şaşırtıcı değil; zaten vaat en yüksek doğruluk değil: tek geçişte güven skoruyla yanıt veren 2B bir model. Grafik ayrıca “diğer sistemler” arasında strands-decider-2b v10 ve v11 etiketli iki nokta işaretliyor; bizim okuyuşumuza göre yaklaşık 0,76 doğruluk ve 0,32’ye yakın Brier skoruyla v11 noktası da her iki eksende v19’un önünde. Yazı bu iki noktanın ne olduğunu açıklamıyor. README bir kalibrasyon iddiası da ekliyor: görmediği kısa sınıflandırma görevlerinde, 0,9 ve üzeri güvenle verilen cevaplar yaklaşık %95 doğru. Model kartı bunun nerede kanıtlandığını sınırlıyor (aşağıya bakın).
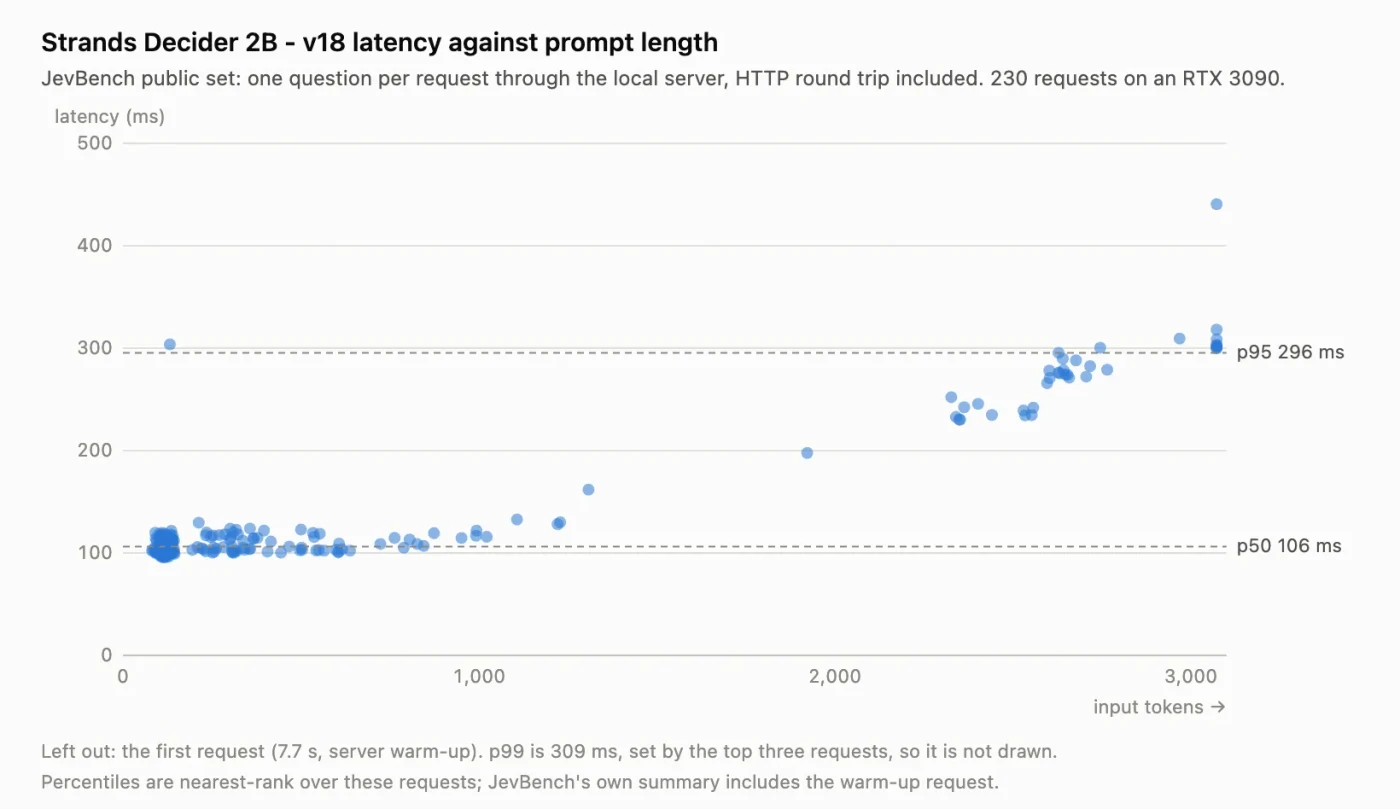
Hıza gelince, yazı ortanca kararın yaygın donanımda yaklaşık 115 ms sürdüğünü, M3 MacBook’ta küçük görevlerde yaklaşık 153 ms olduğunu söylüyor. Grafiği, RTX 3090’da v18 için, istek başına bir soruyla yerel sunucu üzerinden, 7,7 saniyelik ısınma isteğini dışarıda bırakarak, 106 ms ortanca, p95’te 296 ms ve p99’da 309 ms gösteriyor. Gecikme prompt uzunluğuyla yaklaşık doğrusal artıyor ve yaklaşık 2.500 ila 3.000 token’da 300 ms civarına ulaşıyor.
Bu rakamları Jeff ve Jeeves yazılarımızdaki rakamların yanına koymuyoruz. O projeler kendi örneklem ve donanımlarını kullandı, bu yüzden rakamlar karşılaştırılabilir değil.
Zayıf olduğu yerler
Model kartı sınırlar konusunda açık:
- Sorulardan çok belgeler okunuyor. State ve seçenekler sabitken soru değişse de çoğu zaman aynı cevap geliyor.
- Uzun, çok adımlı belgeler zayıf nokta: JevBench’in zor katmanı kolay katmanının çok altında puan alıyor.
- Yes/no ve puanlama görevleri, eğitim karışımına benzemeyen rubric’lere zayıf aktarılıyor. Sizinkine benzeyen bir rubric’le eğitin.
- Kalibrasyon primitive başına bir sıcaklık, held-out kısa sınıflandırmada fit edilmiş. Kart, bir eşiğe güvenmeden önce kendi trafiğinizde ölçmenizi söylüyor.
- Açık eğitim verisi devralınmış alanlar ve etiket gürültüsü demek.
Kullanmak ve bir tool call koruması
En hızlı yol pip install strands-decider ve her seçenek için bir olasılık ve bir güven yazdıran strands-decider ask CLI’ı. Yerel sunucu modu 127.0.0.1’e bağlanıyor ve kimlik doğrulaması yok, bu yüzden kart onu yalnızca yerel deneyler için kullanmayı söylüyor.
Yazının örneği en ilginç kısmı. Strands’in intervention sisteminde bir handler, herhangi bir tool call’dan önce çalışıyor ve tipli bir eylem döndürüyor: Proceed, Deny, Confirm (dur ve bir kişiye sor) ya da Guide (turn’ü model’e geri bildirimle ver). Örnek, önerilen bir get_weather çağrısı hakkında Strands Decider’a iki yes/no soru soruyor: argümanlar kullanıcının söylediklerine dayanıyor mu ve hiç çağırmak erken mi. Ajan kimsenin bahsetmediği bir şehir tahmin edince, kullanıcıya hangi şehri kastettiğini soruyor. Strands bunu soruları, eşiği ve politikayı elle seçerek, “bir tavsiye değil bir illüstrasyon” diye etiketliyor ve karar modeli entegrasyonu için bir Strands ekibi kütüphanesinin geldiğini not ediyor. Bu, Claude Code mod’ları notumuzdaki tool call koruması fikrini yansıtıyor, bu kez bir kural yerine bir model karar veriyor.
Lisans ve veri
Model ve kod Apache-2.0, üzerine kurulduğu Qwen3.5-2B-Base de öyle. Eğitim verisi, lisans etiketleri Apache-2.0, CC-BY, CC-BY-SA, CC0, MIT ve ayrıca other, unknown ve hiçbiri olan açık Hub veri setlerinin bir karışımı, artı sentetik satırlar. Ticari kullanmayı düşünen herkes repository’deki data/sources.md dosyasını okumalı. Karta göre yeniden eğitim bir RTX 3090’da yaklaşık 11 saat, sekiz H100’de yaklaşık 1 saat 10 dakika sürüyor.
Nelere bakmalı
- Bağımsız değerlendirmeler: JevBench’te ve diğer görevlerde, özellikle uzun belgelerde.
- Güven bantlarının, fit edildikleri kısa sınıflandırma görevlerinin dışında tutup tutmadığı.
- Strands ekibinin geleceğini söylediği entegrasyon kütüphanesi.
- OpenAI Decisions API: DevDay’de duyuruldu (DevDay yazımıza bakın) ve TechCrunch’a göre aynı hafta geldi. Bu yazıyı yazarken OpenAI’ın bu konuda bir dokümanı bulunmadı.
Editoryal inceleme: 1 Ekim 2026 (AI). Strands blog yazısından, Hugging Face model kartından ve GitHub README’sinden, hepsi aynı gün okunarak, ve Strands yazısından kredi ile yeniden üretilen şekillerden hazırlandı. Tüm benchmark ve gecikme rakamları Strands ekibine aittir ve bağımsız olarak doğrulanmadı. Modeli çalıştırmadık.
Kaynaklar
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder