Red Hat: Jev guardrail referanslarına göre rekabetçi, ama net üstün değil
Red Hat, Jev, Laya ve DiffusionGemma'yı sınıflandırıcılar ve LLM hakemlerle iki guardrail görevinde test etti. Jev birinde ilk, diğerinde dördüncü oldu.
Bu yazıda
Jev, Laya ve benzerlerinin arkasındaki karar modeli fikri, metin üretmeden hızlı, ucuz ve şemaya uygun yanıtlar vaat ediyor. Red Hat’in AI Safety ekibi bu modellerden üçünü, yerini almaya çalıştıkları araçlarla yarıştırdı. 2 Ekim tarihli bir makalede (sayfada 5 Ekim güncellemesi yazıyor) Rob Geada, Mac Misiura ve Shelton Cyril karar modellerinin rekabetçi ama güvenilir biçimde daha iyi olmadığını bildiriyor. Bu, daha önce işlediğimiz model ailesinin bağımsız bir testi; Red Hat’in kendi eğilimini aşağıda not ettik. Makaleyi ve ekini okuduk; hiçbir şeyi yeniden çalıştırmadık.
Red Hat neyi test etti?
Red Hat, bir isteğin engellenip engellenmeyeceğine karar veren guardrail’ler kurdu ve EvalHub’ın NeMo Guardrails kütüphanesinden iki testi kullandı: prompt injection ve içerik güvenliği (toksiklik ve küfür). İki veri seti de riskli ve güvenli istekler arasında dengeli; tüm istekler İngilizce.
- Karar tarzı: TypeSafe API’si üzerinden Jev 1.13.0, Laya (ModernBERT tabanlı, açık kaynak) ve vLLM’deki deneysel
/v1/systemoneuç noktasında DiffusionGemma 26B. - LLM-as-a-judge: Qwen3.6-35B, NVIDIA’nın Nemotron-3.5-Content-Safety modeli (varsayılan ve özel politikalarla) ve Mistral’in Shieldstral-1.0’ı.
- Önceden eğitilmiş sınıflandırıcılar: prompt injection için Red Hat’in deberta-v3-base’i, içerik güvenliği için granite-guardian-hap-125m; OpenShift AI 3.6’nın varsayılan guardrail kataloğundaki modeller.
- Referans: 2019 tarihli sıfır örnekli sınıflandırıcı BART-large-mnli.
Sınıflandırıcılar, Laya ve BART bir MacBook Pro M1 CPU’da çalıştı. Diğer modeller ABD’deki bir bulut bölgesinde 96 GB’lık bir GPU düğümünde, Jev ise uzak API’siyle çalıştı; ölçümlerin hepsi Birleşik Krallık’tan yapıldı.
Jev, Laya ve DiffusionGemma ne skor aldı?
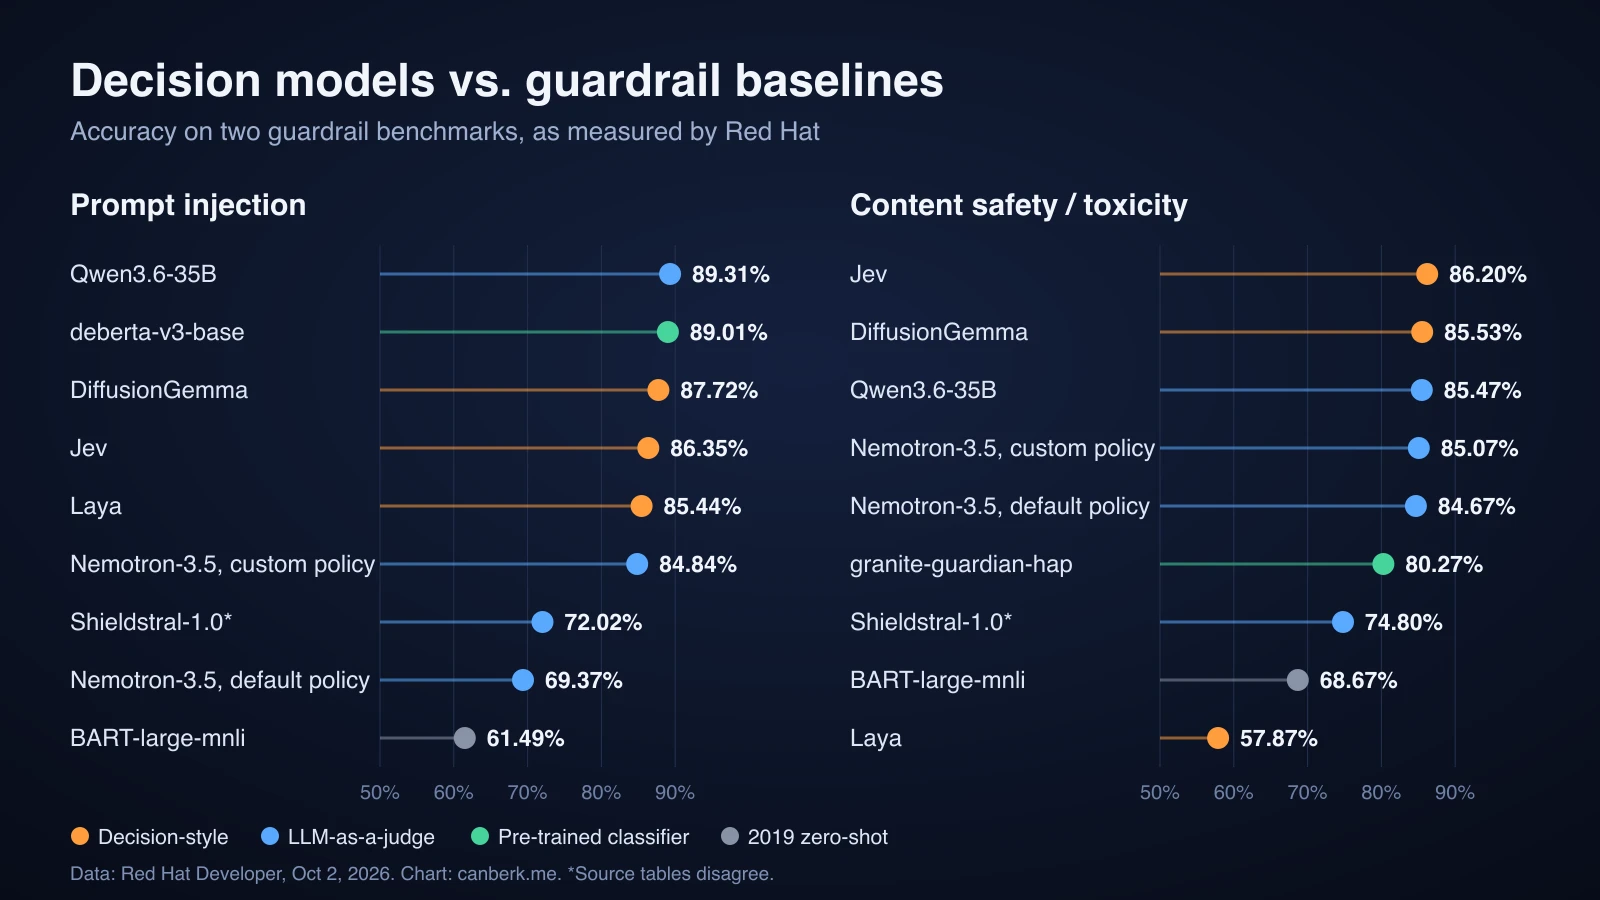
| Yöntem | Prompt injection | İçerik güvenliği | Medyan gecikme, injection |
|---|---|---|---|
| Qwen3.6-35B (hakem) | %89,31, 1. | %85,47, 3. | 312,5 ms |
| deberta-v3-base (sınıflandırıcı) | %89,01, 2. | kullanılmadı | 54,1 ms |
| DiffusionGemma | %87,72, 3. | %85,53, 2. | 561,7 ms |
| Jev | %86,35, 4. | %86,20, 1. | 348,1 ms |
| Laya | %85,44, 5. | %57,87, 9. | 119,3 ms |
| Nemotron-3.5, özel politika | %84,84, 6. | %85,07, 4. | 240,4 ms |
| granite-guardian-hap-125m (sınıflandırıcı) | kullanılmadı | %80,27, 6. | 33,2 ms (güvenlik testi) |
| BART-large-mnli | %61,49, 9. | %68,67, 8. | 115,0 ms |
Yer kazanmak için Shieldstral ve varsayılan politikalı Nemotron tabloda yok; makaleye bakın. Sıralamalar ve rakamlar Red Hat’e ait.
- Sınıflandırıcılar sağlam. Prompt injection’da 200 milyon parametreli sınıflandırıcı, liderin gecikmesinin yaklaşık altıda birinde, ilk sıranın 0,20 puan gerisinde bitirdi. İçerik güvenliğinde Jev ve DiffusionGemma, Red Hat’in küçük granite sınıflandırıcısını açık farkla geçti; yazarlar bunu kendi küçük güvenlik sınıflandırıcılarının iyileştirilmesi gerektiğinin işareti olarak okuyor.
- Jev’in sonucu karışık. İçerik güvenliğinde DiffusionGemma’yı 0,67 puanla geçerek birinci oldu; prompt injection’da zirvenin 2,96 puan gerisinde dördüncü.
- Açık alternatifler yarışıyor. DiffusionGemma iki görevde de Jev’in yaklaşık 1,4 puanı içinde bitirdi. Laya prompt injection’da zirvenin dört puan içinde, içerik güvenliğinde ise çok geride kaldı.
- İstem, modele göre değişiyor. Red Hat’in Laya için ayarladığı politikayla Laya %57,87’den %75,20’ye çıktı; aynı politikada Jev %86,20’den %82,53’e düştü. Yazarlar, bir modele uyan istem tarzının diğerine uyması gerekmediği sonucuna varıyor.
- Bir hakem düşük kaldı. Red Hat, Shieldstral’in Mistral’in kendi kıyaslamalarının düşündürdüğünden çok kötü performans gösterdiğini ve birkaç tur istem çalışması gerektirdiğini söylüyor; ortak risk tanımlarıyla yaklaşık 10 puan kaybetti.
Red Hat’in sonucu: önceden eğitilmiş sınıflandırıcılar “son derece rekabetçi” kalıyor ve karar modelleri hız ya da doğrulukta LLM hakemleri, önceden eğitilmiş sınıflandırıcıları ya da açık karar modellerini “güvenilir biçimde geçmiyor”. Laya’nın küçük boyutunu, sınırlarını istemle aşabiliyorsanız gerçek bir avantaj olarak sayıyor ve küçük, göreve özel modellere dönüşü olumlu karşılıyor.
Hangi çekincelerle okunmalı?
- Red Hat’in bir tutumu var. Yazarlar, AI Safety ekibinin küçük, öngörücü modelleri “her zaman savunduğunu” söylüyor ve makale bunların OpenShift AI 3.6’da varsayılan olarak sunulduğunu belirtiyor. Bu rakamları yanlış yapmaz, ama sonuç satıcının ürünüyle örtüşüyor.
- Gecikme aynı koşulda değil. Sınıflandırıcılar ve Laya dizüstü CPU’sunda yerelde çalıştı; Jev ve GPU’daki hakemler en az yaklaşık 56 ms’lik Atlantik ötesi gecikme taşıyan uzak çağrılardı, Red Hat’in kendisi de bunu belirtiyor. Sınıflandırıcının 54 ms’si ile Jev’in 348 ms’sini karşılaştırmak, model hızı ile ağ mesafesini karıştırıyor. Jev’in doğruluk rakamları bundan etkilenmiyor.
- Risk tanımları LLM hakemlerden geldi. Red Hat bunları LLM-as-a-judge guardrail’lerinde kullandığı istemlerden uyarladığını ve karar modelleri için en uygun olmayabileceğini söylüyor. Bu, Jev, Laya ve DiffusionGemma’yı olduğundan düşük gösterebilir.
- Dar kapsam. İki görev, yalnızca İngilizce; makale kaç çalıştırma yapıldığını söylemiyor, güven aralığı vermiyor ve Jev’in parametre sayısı “bilinmiyor” yazıyor. Maliyet ve başka diller test edilmedi; Red Hat, sınırlı önizlemedeki OpenAI Decisions API’sini de denemek istediğini söylüyor.
- Tabloları bazı yerlerde tutmuyor. Shieldstral’in doğruluğu iki ana tabloda %72,02 ve %74,80 olarak geçiyor, ekte ise tersi; hangisinin doğru olduğunu söyleyemiyoruz ve bu sayfadaki grafik bunu işaretliyor. Makale ayrıca bir yerde “dokuz aday guardrail”, başka bir yerde “sekiz” diyor ve DiffusionGemma’yı adında 26B yazmasına rağmen yaklaşık 2.600 milyon parametre olarak listeliyor.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- Fikri çürütmüyor. LLM hakem kadar iyi ve daha ucuz bir karar modeli yine işe yarar; ama bu test maliyeti ölçmedi ve uzak barındırılan hakemlere karşı bir hız avantajı bulmadı.
- Diğer bağımsız işaretlerle uyumlu. Önceki derlememiz ve llama.cpp haberi olasılıklarına güvenmeden önce modeli kendi verinizde denemeyi vurguluyordu. Bu kıyaslama o öğüdü destekliyor.
- Kendi görevinizi test edin. Burada sıralama iki görev arasında değişti; en iyi seçim kurduğunuz guardrail’e bağlı.
Editöryal inceleme: 5 Ekim 2026 (AI). Red Hat Developer’ın 2 Ekim 2026 tarihli makalesi (sayfada son güncelleme 5 Ekim), ek tabloları ve istemleriyle birlikte, düz istek engellendiği için bir tarayıcı üzerinden aynı gün baştan sona okunarak hazırlandı. Kıyaslamaları yeniden çalıştırmadık, modelleri test etmedik. Rakamlar Red Hat’e aittir; Shieldstral değerleri ana tablolardaki gibi gösterildi ve tutarsızlık belirtildi. Kapak, Red Hat’in yayımladığı doğruluk rakamlarından üretilmiş kendi grafiğimizdir ve Red Hat’e atfedilmiştir. “Şu çekincelerle okuyun” ve “Akılda tutulacaklar” bölümleri bize aittir.
Kaynaklar
- Benchmarking AI decision models against traditional guardrails ↗Red Hat Developer
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder