Nemotron 3.5 Super VL: NVIDIA'nın 120B açık modeli
NVIDIA'nın Nemotron 3.5 Super VL'i 12B aktif parametreli, 120B açık çok kipli model. 5 kat hız iddiası, lisans, benchmark'lar ve eksikler.
Bu yazıda
- Nemotron 3.5 Super VL nedir?
- NVIDIA onunla birlikte başka ne yayımladı?
- Nemotron 3.5 Super VL’in özellikleri neler?
- Nemotron 3.5 Super VL gerçekten 5 kat hızlı mı?
- Nemotron 3.5 Super VL nasıl skor alıyor?
- Nemotron 3.5 Super VL’i çalıştırabilir misiniz, hangi lisansla?
- Müşteriler ne bildiriyor?
- Nemotron 3.5 Super VL hakkında neler hâlâ belirsiz?
- Akılda tutulacaklar
NVIDIA ajanlar için tasarlanmış 120B bir açık model yayımladı ve manşet iddiası hız. Şirket 15 Ekim’de, token başına 12B parametre etkinleştiren bir görü-dil uzman karışımı modeli olan Nemotron 3.5 Super VL’i ve yerel kullanım için iki küçük Bolt modelini tanıttı. NVIDIA’nın blog yazısını, teknik blogunu ve Hugging Face model kartını okuduk. Bu yazı neyin yayımlandığını, 5 kat hız iddiasının nasıl okunacağını, skorları ve lisansı anlatıyor.
Nemotron 3.5 Super VL nedir?
Ajan işleri için açık, çok kipli bir model. NVIDIA, Nemotron 3.5 Super VL’i 120B parametreli olarak tanımlıyor; geliştirici yazısı token başına 12B’nin aktif olduğunu ekliyor. Akıl yürütmeyi, talimat izlemeyi, araç kullanımını ve metin, görüntü, belge ve video anlamayı birleştiriyor. NVIDIA ona “sınıfındaki en hızlı açık ajan modeli” diyor ve en büyük akıl yürütme modeliyle kabaca beşte bir parametreyle karşılaştırılabilir olduğunu söylüyor. Model kartına göre girdiler metin, JPEG ve PNG görüntüler ve iki dakikaya kadar MP4 video; çıktı metin ve bağlam penceresi, istem, görsel girdiler, geçmiş, araç sonuçları ve çıktı tarafından paylaşılan 1M token’a kadar.
NVIDIA onunla birlikte başka ne yayımladı?
Ajanları yerelde çalıştırmak için iki Bolt modeli:
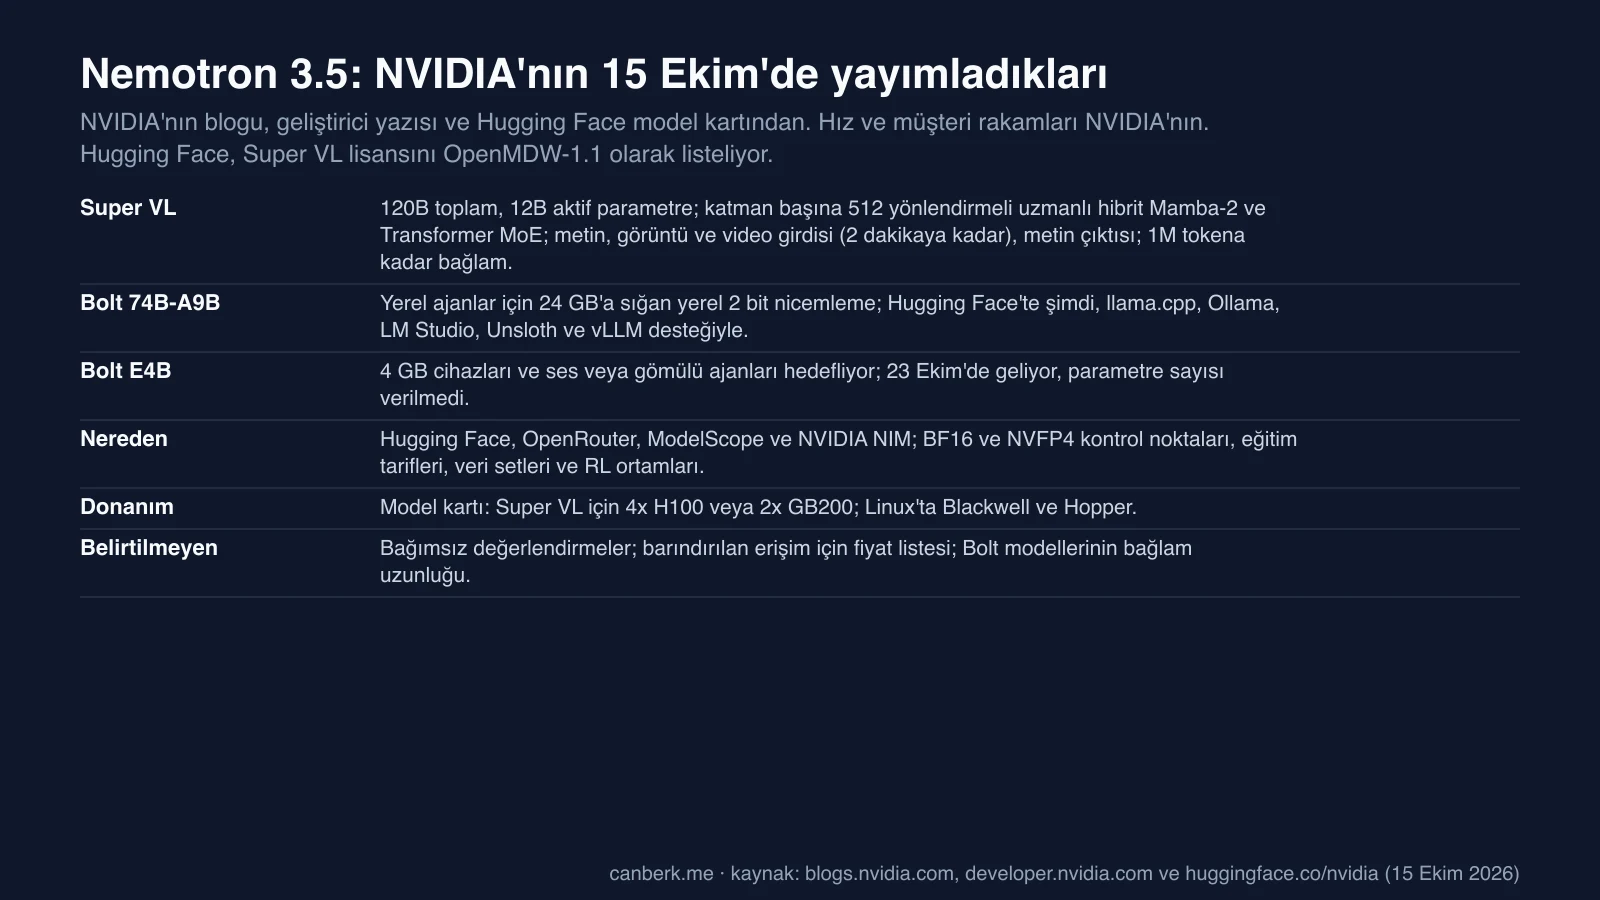
- Bolt 74B-A9B, 24 GB belleğe sığmak için yerel 2 bit nicemleme kullanıyor; böylece GeForce RTX PC’lerde, RTX PRO iş istasyonlarında, DGX Spark’ta ve NVIDIA’nın 16 Ekim’de geleceğini söylediği NVIDIA RTX Spark dizüstülerinde diğer uygulamalarla birlikte çalışabiliyor. NVIDIA, sınıfındaki açık modeller arasında PinchBench’te birinci, BrowseComp’ta ikinci olduğunu söylüyor. llama.cpp, Ollama, LM Studio, Unsloth ve vLLM desteğiyle Hugging Face’te. Bu dizüstüleri Surface RTX Spark haberimizde ele almıştık.
- Bolt E4B 4GB, sesli asistanlar ve gömülü arayüzler gibi hızlı sohbet ajanlarını hedefliyor. 23 Ekim’de geliyor ve NVIDIA parametre sayısı vermedi.
Nemotron 3.5 Super VL’in özellikleri neler?
Hugging Face model kartına göre, MoE katmanı başına 512 yönlendirmeli uzmanlı, bir C-RADIO görü kodlayıcılı, bir görü-dil bağlayıcılı ve spekülatif kod çözme için çok-token tahmin başlıklı hibrit Mamba-2 ve Transformer uzman karışımı. NVIDIA’nın geliştirici yazısı, SkewReverse denen bir kayıpla Nemotron 3 Ultra’dan distill edildiğini ve metin ve görü öğretmenleri arasında çok öğretmenli politika içi distillation’la son eğitim aldığını söylüyor. Model kartı temel verinin 20 trilyon tokeni aştığını, toplamanın Aralık 2025’e kadar sürdüğünü söylerken blog yaklaşık 26 trilyon token ön eğitim ve sürekli ön eğitim ve yaklaşık 3,8 milyon son eğitim örneği artı pekiştirmeli öğrenme anıyor. İki rakam eğitimi farklı sayıyor ve NVIDIA uzlaştırmıyor. Sürekli ön eğitim 10B Hint dili tokeni ekledi ve NVIDIA, IIT Madras ve AI4Bharat ile yapılan, 22 Hint dilini kapsayan yaklaşık 2,8T tokenlık bir veri seti yayımlıyor.
Nemotron 3.5 Super VL gerçekten 5 kat hızlı mı?
NVIDIA’nın grafiğinde, aynı endeks skoruna sahip modellere karşı evet. NVIDIA “sınıfındaki diğer modellerden 5 kata kadar yüksek verim” diyor ve geliştirici yazısı Baseten uç noktasında ölçülen Artificial Analysis ajan görevlerinde saniyede 600’den fazla çıktı tokenı gösteriyor. 100k girdi tokenında açık ağırlıklı modellerin hız grafiğinde Super VL, yaklaşık 26’lık bir Zekâ Endeksiyle saniyede yaklaşık 625 tokende duruyor.
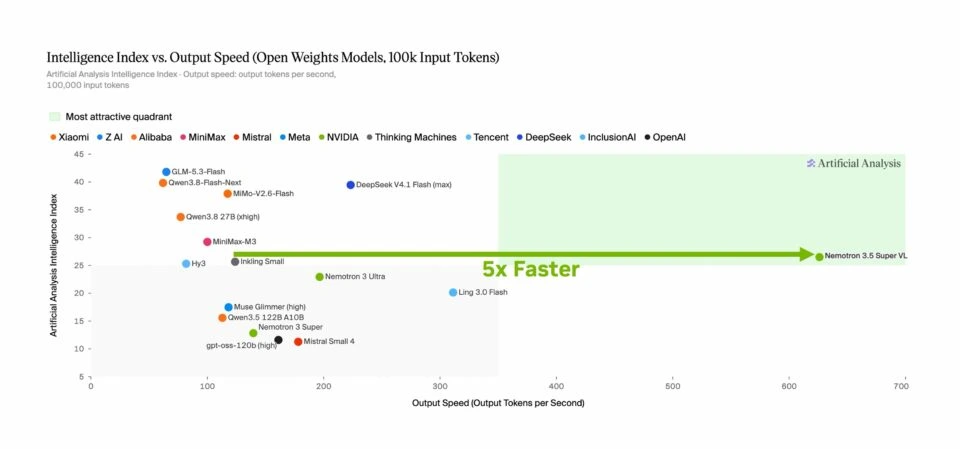
Grafiği şöyle okuyoruz: “5x” oku, aynı endeks değerine (yaklaşık 26) sahip ve saniyede kabaca 120 token üreten Inkling Small’dan başlıyor. Aynı grafikte daha yüksek endeks skorlu modeller, örneğin GLM-5.3-Flash (yaklaşık 42) ve Qwen3.8-Flash-Next (yaklaşık 40), çok daha yavaş üretiyor. Yani iddia, daha güçlü modeller arasında bir hız liderliği değil, orta düzey zekâda bir hız. NVIDIA ayrıca B200 GPU’larda 10.000 kodlama görevinin 4 kat hızlı tamamlandığını ve 16 B200 GPU’da NVIDIA Dynamo ile kullanıcı başına saniyede 50 tokende 8 kata kadar kullanıcı ve %85 düşük ilk token süresi sağlandığını iddia ediyor. Bunlar NVIDIA’nın rakamları.
Nemotron 3.5 Super VL nasıl skor alıyor?
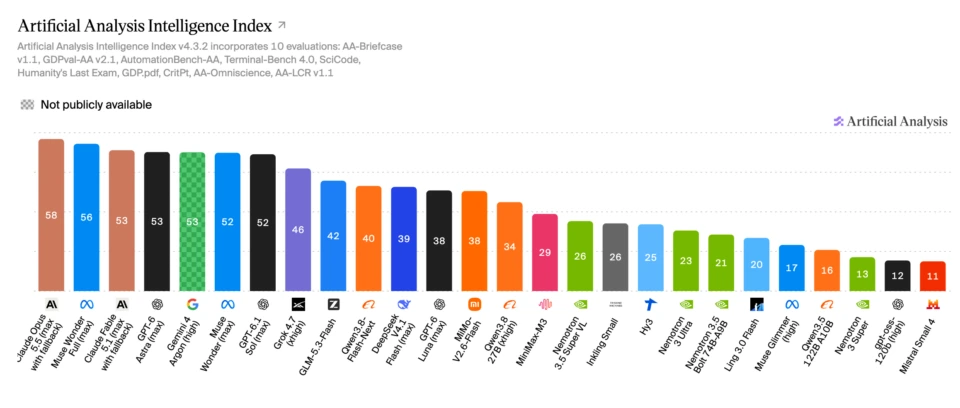
Geniş endekste mütevazı, seçilmiş testlerde iyi. NVIDIA’nın Artificial Analysis grafiği Super VL’i 26’ya koyuyor; Nemotron 3 Ultra’nın (23) üzerinde, Claude Opus 5.5’in (58), Meta’nın Muse Wonder Full’unun (56) ve GPT-6 Astra’nın (53) çok altında.
Seçilmiş testlerde model kartı şunları bildiriyor:
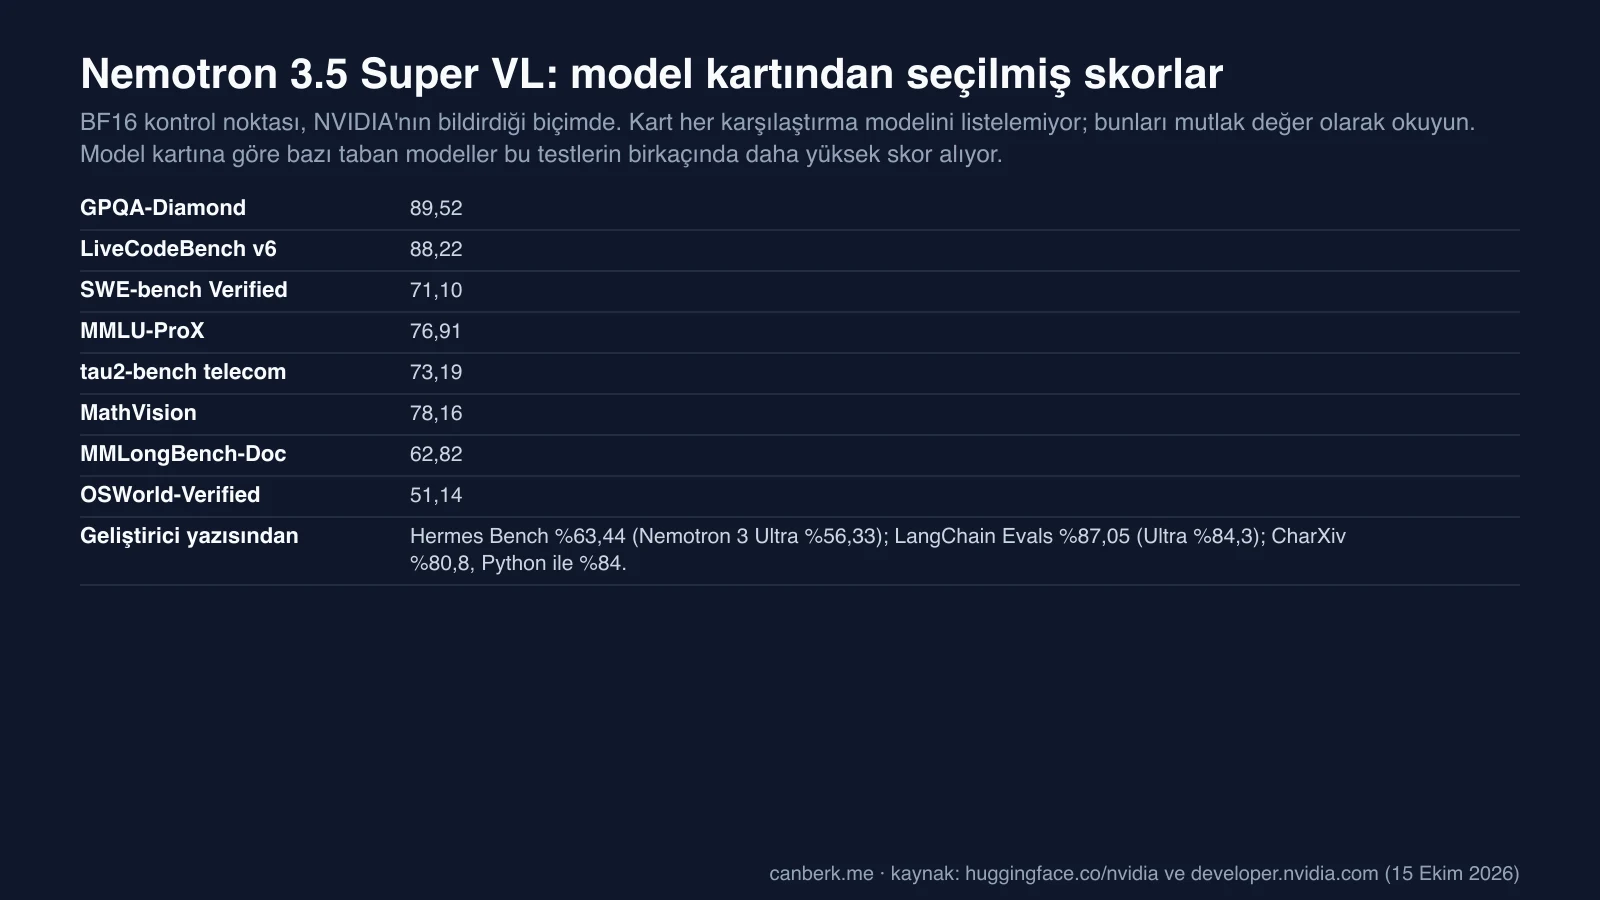
Model kartı her benchmark’ta lider olmadığını ve birkaç karşılaştırma modelinin bazı görevlerde, örneğin bazı taban modeller için MMLU-ProX ve GPQA-Diamond’da, daha yüksek skor aldığını söylüyor. Geliştirici yazısı, SWE-bench ve Terminal-Bench kurulumlarında Nemotron 3 Super’i rakam vermeden geçtiğini ve Hint dili benchmark’larında karşılaştırılan üç model arasında kesin skor vermeden en yüksek skoru aldığını ekliyor. Karttaki skorlar diğer laboratuvarların tablolarından farklı koşum takımları kullanıyor olabilir, bu yüzden satıcılar arası kıyaslamayın; örneğin Muse Spark Open model kartı OSWorld Verified’ı Meta’nın kendi kurulumunda 80,4 olarak listeliyor.
Nemotron 3.5 Super VL’i çalıştırabilir misiniz, hangi lisansla?
Çok GPU’lu bir makinede, izinli bir lisansla. Model kartı OpenMDW-1.1’i listeliyor ve modelin ticari veya ticari olmayan kullanıma hazır olduğunu söylüyor. Linux’ta NVIDIA Blackwell veya Hopper üzerinde 4x H100 veya 2x GB200 öneriyor ve çok-token tahminli vLLM ve SGLang sunum örnekleri veriyor. NVIDIA BF16, son eğitimli ve NVFP4 kontrol noktalarını, eğitim tariflerini, verileri ve pekiştirmeli öğrenme ortamlarını yayımladı; ağırlıklar Hugging Face ve ModelScope’ta, barındırılan erişim OpenRouter ve NVIDIA NIM üzerinden. NVIDIA, NIM konteynerlerinin iki haftada bir yenilendiğini söylüyor. OpenMDW-1.1 metnini kendisini okumadık.
Müşteriler ne bildiriyor?
Büyük kazanımlar, hepsi satıcı tarafından bildirilmiş. NVIDIA’nın geliştirici yazısı, Scale AI’nin Skydance’de satıcı kredisi işlemede 40 kat düşük çıkarım maliyeti ve 5 kat düşük gecikme gördüğünü, Ramp’ın fişleri JSON’a çevirmede %50’ye kadar yüksek verim ve 10 kat düşük gecikme gördüğünü söylüyor. Blog Hebbia, EY, Atlassian, CrowdStrike, Salesforce ve Synopsys dahil başka müşterileri ve entegrasyonları sıralıyor. Bunlar şirketlerin kendi kullanım durumlarından geliyor ve doğrulayamadık.
Nemotron 3.5 Super VL hakkında neler hâlâ belirsiz?
- Bağımsız sonuçlar. Skorlar ve hız iddiaları NVIDIA’dan veya grafik ortağından; NVIDIA’nın yayımladığı Artificial Analysis grafiği dışında dışarıdan bir yeniden üretim görmedik.
- Eğitim token rakamlarının neden farklı olduğu. Model kartı ve blog farklı aşamaları sayıyor.
- Barındırılan fiyatlar. İki yazı da fiyat vermiyor.
- Bolt E4B ayrıntıları. Boyut veya bağlam uzunluğu yok.
- Sınırlamalar. Okuduğumuz model kartı metninde ayrı bir sınırlamalar bölümü yoktu.
Akılda tutulacaklar
Bunlar bizim gözlemlerimiz:
- “5x”i 26’lık endekste hız olarak okuyun. Aynı grafikteki daha güçlü açık modeller daha yavaş.
- Lisans en dostça kısım. Ticari kullanım için OpenMDW-1.1, Meta’nın Muse Spark Open’ındaki sınırlı koşullarla tezat oluşturuyor.
- Donanım giriş maliyeti. 4x H100 veya 2x GB200 çok, Bolt 74B-A9B ise 24 GB’lık karta hedefliyor.
- Model kartına görev bazında bakın. Bazı taban modeller birkaç testte onu geçiyor.
Editoryal inceleme: 16 Ekim 2026 (AI). NVIDIA’nın blog yazısı ve teknik blogu (ikisi de metin olarak okundu, grafikler görsel olarak görüntülendi) ve Hugging Face model kartı (özetleyici bir fetch ile okundu; sayfanın son kısmı okunmadı) esas alınarak hazırlandı. Modelleri çalıştırmadık, OpenMDW-1.1 lisans metnini okumadık ve ikincil haberleri kullanmadık.
Kaynaklar
- Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models (Kari Briski, NVIDIA Blog, 15 Ekim 2026) ↗NVIDIA
- NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning (NVIDIA Technical Blog, 15 Ekim 2026) ↗NVIDIA
- NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16 model kartı (Hugging Face, NVIDIA) ↗Hugging Face üzerinde NVIDIA
AI desteğiyle hazırlandı.
Düzeltme öner
Bir hata veya eksik kaynak mı fark ettin? Editöre özel bir öneri gönder. Önerin incelenir ve herkese açık bir yorum olarak yayımlanmaz. Ad, e-posta veya hesap gerekmez.


Bize mesaj gönder